- Agent 自我进化
- RSI
- 观点
- 静态问题
- 什么是自进化
- RSI 总结
- 自进化系统
- 技术路线
- 进化案例
- 【2025-2-18】港大 AutoAgent
- 【2025-3-8】AppAgentX 进化
- 【2025-8-5】CMU SQLM
- 【2025-8-7】腾讯 R-Zero
- 【2025-11-20】斯坦福 agent0
- 【2025-11-13】AgentEvolver
- 【2026-3-17】MetaClaw
- 【2026-3-19】LSE
- 【2026-3-24】Hermes Agent
- 【2026-3-19】 HyperAgents
- 【2026-6-30】POLARIS
- 【2026-7-18】阿里巴巴
- 【2026-7-31】DarwinX
- 【2026-8-6】Discovery Loop
- 【2026-9-1】字节闭环自进化
- 【2026-8-25】新加坡国立+斯坦福+牛津 Recuris:进化记忆
- 【2026-8-27】AllSpark 提出 PILOT:实时进化
- 【2026-9-8】NVIDIA 工作流自进化
- 【2026-9-17】GLM-5.3 Infra Agent
- 【2026-9-18】Anthropic Claude 主导26% 核心工作
- 结束
Agent 自我进化
一个完全自主、越用越强的 Agent,有可能实现吗?
2026年,AI行业从“训练更大模型”转向“让AI自我改进”。
RSI(递归自我改进)让AI参与研发下一代AI,提升效率。
【2026-9-10】观点:国内AI自进化大致有五条路线:AI自动科研、AI制造AI、记忆驱动的Agent自进化、物理AI自进化,以及面向企业场景的持续进化。
其中最值得关注的是:元环智能、EverMind、衔远科技/清华团队、面壁智能,以及章鱼动力。
RSI
【2026-8-22】什么是RSI
补丁
- RAG: 开卷考试, 发一本随时能翻的参考书。书天天换新,学生本人没变
- 记忆: 便利贴, 《记忆碎片》式贴满便条。能提醒你钥匙在哪,教不会你开锁
- LoRA: 活页, 不重印整本书,夹几页勘误。夹多了会互相打架
- 模型编辑: 手术刀, 精准改写一条记忆。刮一两处行,刮十几处书就烂了
四类补丁各管一摊,共同点:要么不进脑子,要么不可持续。
Karpathy:
人睡着时,白天的经历被悄悄蒸馏进大脑;大模型里没有对应的东西。补上这场睡眠还要十年。而一旦补上,几百万个副本每晚把经验汇回同一个本体,就已经是最朴素的爆炸剧本。
科幻里的 RSI 是 AI 改写自己的源代码。
现实里能力全在权重:几千亿个数字,读不懂也改不了。
所以工程上的路是:AI 参与写训练代码、造训练数据,造出更强的下一代。
RSI 定义
递归自我改进 RSI: Recursive Self-Improvement
甲子光年创始人&CEO张一甲:“2026年RSI(递归自进化)的研究热度大幅抬升,它集中在部署和训练阶段的自进化。我们将RSI进行了7级阶梯的划分,从L0到L6,分别要实现的就是AI回答问题、 AI自主执行、 AI自我纠错、 AI自我学习、 AI改进AI系统、 AI改进‘如何改进AI’以及AI自主研发下一代AI。我们现在大概在L4这个位置。”
阶梯层级释义
| 层级 | 能力阶段说明 |
|---|---|
| L0 | 当场改答案,表层输出修正 |
| L1 | 攒记忆技能,沉淀可复用技能库 |
| L2 | 改工具代码,自主修改底层工具实现 |
| L3 | 改「怎么改」,元能力,修改自我改进的方法论 |
| L4 | 研发飞轮,自我迭代进化闭环(目标终点) |
OpenClaw、Hermes 已经会给自己写技能、记笔记,阶梯的第一级。但 经验复利 ≠ 能力复利:越用越顺手,不等于越用越聪明。
Karpathy 的 autoresearch:让 agent 对着 630 行训练代码无限循环。挂机两天,找到 20 处可叠加的改进,有几处连他这个调了二十年参数的老手都漏了。他说:这是最终 boss 战。
RSI 分类
【2026-7-8】加州大学 Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops
真正的 RSI 不只是模型把答案改好一点,也不是训练集里多放一些自生成样本,而是系统开始修改自己的改进机制,甚至修改判定标准本身。
二维分类
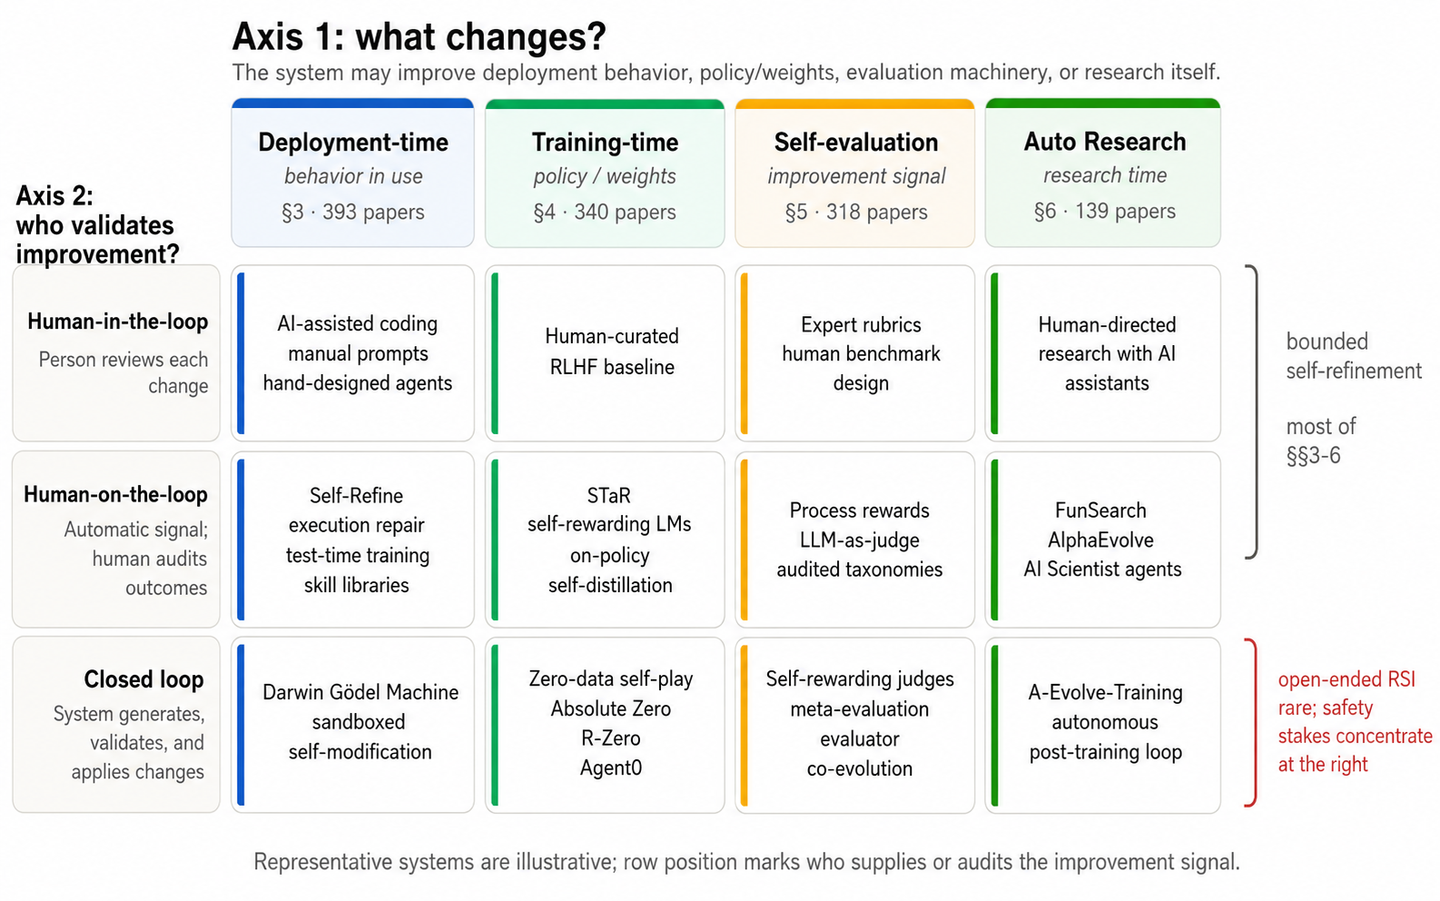
(1)系统改进对象
- Deployment-time self-evolution:部署阶段改进。包括冻结权重的输出修正(output refinement)、test-time training、harness、skill、memory 的积累。
- Training-time self-iteration:训练阶段改进。系统生成数据、奖励或教师信号(teacher signal),再更新自己的权重。
- Self-evaluation:evaluator 本身成为改进对象。系统设计、增强或共同进化 judge、verifier、奖励模型、rubric。
- Auto Research:系统参与 AI 研究本身。提出假设、运行实验、发现算法。极限情况下,它会优化产生下一代 AI 系统的方法。
(2)如何验证改进
- Human-
in-the-loop:人类逐次审查改动。 - Human-
on-the-loop:自动信号生成改进,人类审计结果或设置部署门槛。 - Closed loop:系统自己生成、验证并应用改进,没有人类审查。
现在, 绝大多数文献仍然落在 bounded self-refinement。
- 最多的是 human-on-the-loop:自动信号已经进入循环,但人类仍然审计结果。
- closed loop 的工作很少,尤其是 self-evaluation × closed loop 最少,但也最关键。因为一旦系统能改自己的 evaluator,并且自己判定这个 evaluator 更好,bounded self-refinement 就开始接近 open-ended RSI。
这个分类的好处: 不让“self-X”词汇牵着读者走。Self-Refine、self-reward、self-play 都只是机制名。真正需要定位的是改进对象和验证责任。
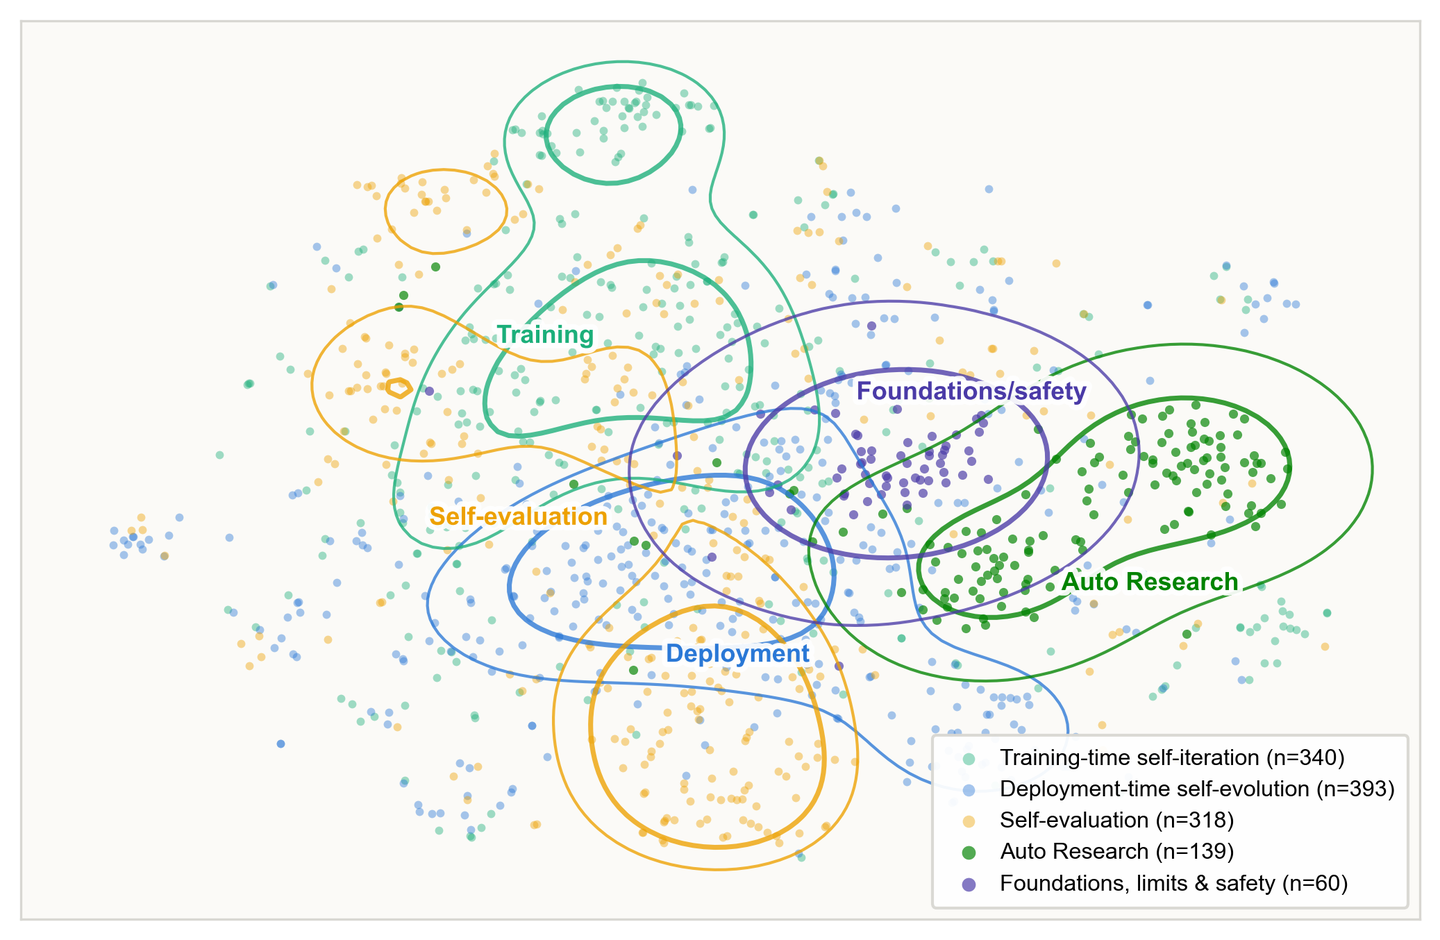
【2026-8-9】更多解读:RSI 是什么?这篇综述讲清楚了 RSI 的痛点
观点
业界布局, 最贵的人才、最高的薪资、最大的算力,都在往这RSI流动。
- 2026 年 5 月到 8 月:Karpathy 进 Anthropic 用 Claude 训下一代 Claude;
- 翁荔回 OpenAI 领导 RSI 方向;
- Jeff Dean 创办
Discovery Loop。
【2026-3-27】小米 MiMo 大模型负责人罗福莉:大模型的自进化,对科学研究带来的指数级加速
【2026-7-27】腾讯技术工程文章:Agent开始“自我进化”:会出题、会反思,还会自己长出新技能
【2026-8-13】Self-Evolving Agent: A Closed-Loop Post-Training Flywheel for Continually Learning LLM Agents
Agent 在真实任务里产生了大量轨迹和反馈,最后到底该学什么?
现在很多 Agent 已经能跑很长的任务,也有 memory、skills、harness 去保存经验。但很多时候,这些经验依然停留在模型外面:存进向量库、写进 skill、塞回 context。
Agent 能「记住过去」,和真正「从过去学会东西」,中间其实还有很长一段距离。
@AlloomiAI 做的 Self-Evolving Agent 把真实工作里的上下文、专家修改、任务结果和反馈组织成完整轨迹,再经过质量筛选、专家锚定和后训练,让这些经验逐渐进入模型能力。
整个闭环大概是:工作轨迹 → 筛选经验 → 专家锚定 → 后训练 → 评测准入 → 出问题可以回滚。
在 CL-Bench 上,同一个 backbone 经过这套方法后,成绩从 24.5% 提升到了 47.6%。
背后的方向:
- 未来 Agent 的自进化,需要解决怎么获得真正有价值的经验,以及怎么安全地把这些经验变成下一次任务可以复用的能力。
Alloomi 还把其中的上下文运行时 OpenContext 开源了,可以直接接进自己的 Agent。
比起单次任务做得更强,我现在更关注它们能不能在长期使用中持续变得更熟练。
【2026-8-20】Jeff Dean离职后首次公开访谈火力有点猛 斯坦福 2026 Frontier&Pioneer Symposium 上,Jeff Dean一口气聊开了不少过去很少公开展开的话题 YouTube
- 关于为啥离开谷歌:小团队可以极致聚焦
- 非常专注的小公司,所有人都围绕同一个使命工作,这种状态本身就很有吸引力。非常专注地去做科学和工程自动化。
- TensorFlow 当年有两个很明确的失误
- 第一,最开始没有加入 Eager Execution 模式。后来这种方式在
PyTorch和JAX框架流行,TensorFlow 才加进来 - 第二,contrib子目录允许很多外部开发者贡献各种辅助库和不同的实现方式。给社区带来困惑,因为变成同一件事情可能有十种不同的做法,到底该用哪一种,取决于用了contrib里的哪个子目录、哪个库。TensorFlow核心保持更简洁,把这些东西作为建立在核心之上的外部库。
- 第一,最开始没有加入 Eager Execution 模式。后来这种方式在
- Gemini为啥不行?
- Gemini 其实是Google内部几个更早研究项目最终汇合的结果——包括原来 DeepMind、Google Brain,以及Google Research其他团队的一些工作。
- 把Gemini的Coding能力真正做到惊艳,重视得稍微晚了一点
- 自己的科研秘诀:
- 未来科学实验的一轮迭代,可能从一天、一周压缩到一分钟、一小时
- 在找重大研究方向时,与其精读1篇论文,不如先扫10篇,甚至100篇摘要
- 利用
第一性原理和一些工程经验, 在脑子里快速判断不同解决方案大概是什么量级。
- 新公司 Discovery Loop 接下来准备押注什么
- 把科学发现变成自动迭代的Loop. Discovery Loop 目标:让模型拥有“20个博士”的科研能力
- 递归自我改进,覆盖模型参数、训练数据、Eval,甚至模型架构本身。
- 联合创始人
Quoc Le很早就在做Neural Architecture Search:让模型自动生成模型架构,再根据学习速度、训练成本等指标不断获得反馈,逐渐找到更好的设计。还做了Evolved Transformer,通过进化算法重新组合Transformer组件,最终找到的架构效率比标准Transformer高了大约30%。 - 递归自我改进真正要解决的问题是怎样让构建模型所需要的整套东西,都能够通过自动化方式持续变得更好。
静态问题
大模型老大难问题:
- 静态知识:训练完成那一刻起,模型对世界的认知就被冻结了;
- 上下文有限:再长的上下文窗口也总有边界,多轮交互终究”断片”;
- 重复犯错:今天教会它的事,明天还会再犯一遍;
- 训练贵:每次想让模型变强一点,要么 SFT 要么 RL,都得重新跑一遍。
而 Agent 与真实世界互动时问题:
- 世界是动态:新知识、新事件、新梗层出不穷。一个知识停留在 2023 年的 AI,无法理解 2024 年的最新动态。
- 任务是开放:真实世界的任务千变万化,没有固定的「题库」。AI 需要具备处理未知问题的能力。
- 工具是变化:新的软件、API 和网站不断涌现。AI 需要学会使用新工具,甚至创造新工具。
- 用户是个性:每个人都有自己的偏好和习惯。AI 需要通过与用户的互动,不断适应和学习,提供个性化服务。
「静态」的 AI 在这样动态、开放的环境中,就像一个拿着旧地图的航海家,注定会迷航。
因此,AI 范式正在经历一场至关重要的转变:从追求模型的「规模」(Scale)转向追求智能体的「适应性」(Adaptivity)。
发展路径:
- 从
基础 LLM,到能执行任务的基础智能体(Foundation Agents),再到能够持续学习和适应的自进化智能体(Self-Evolving Agents),并最终指向理论上的人工超级智能(Artificial Super Intelligence, ASI)。 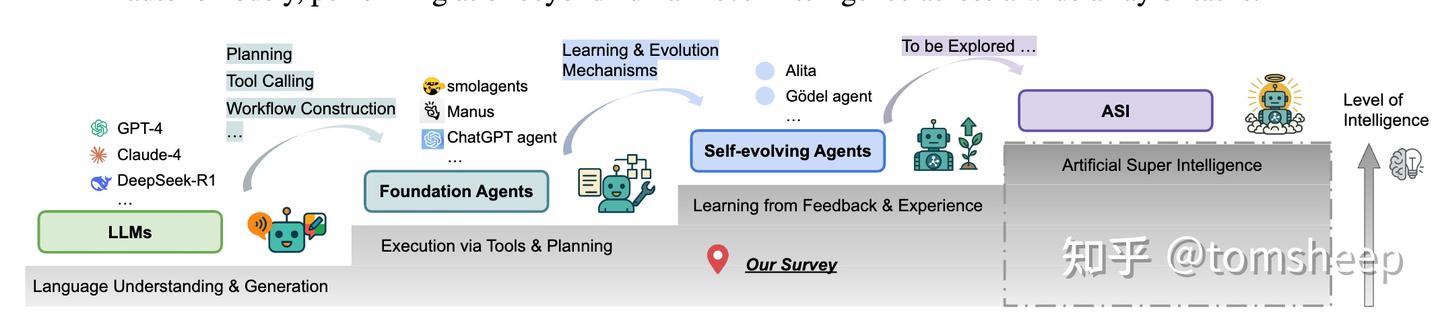
自进化 Agent 想要的正是绕开这些限制:让经验本身成为模型能力的延伸或更新通道
大模型时代被重新点燃,因为:
- LLM 本身具备总结归纳的能力(自己能给自己写笔记了);
- Agent 形态的产品越来越多,长程交互场景终于有了真实需求;
- 高质量人工标注数据越来越贵,社区开始探索”少人工 / 无人工”路线。
什么是自进化
定义
Agent 自进化(Self-Evolving Agent):
- Agent 在运行期或部署后,基于交互轨迹、环境反馈或任务结果,对自身的可持久组件进行更新,从而提升未来任务的表现。
要点
- 第一 可持久组件——更新的对象必须能跨任务留存,单次会话里的临时纠错不算。
- 第二 提升未来表现——改了之后下次要真的更好,”改了”本身不算进化。
分类
【2026-8-2】什么是 Self-evolving / self-improving / RSI ?一篇文章搞懂自进化
【2026-9-3】万字长文带你读懂 RSI(自进化,Self-Evolving)
RSI定义:
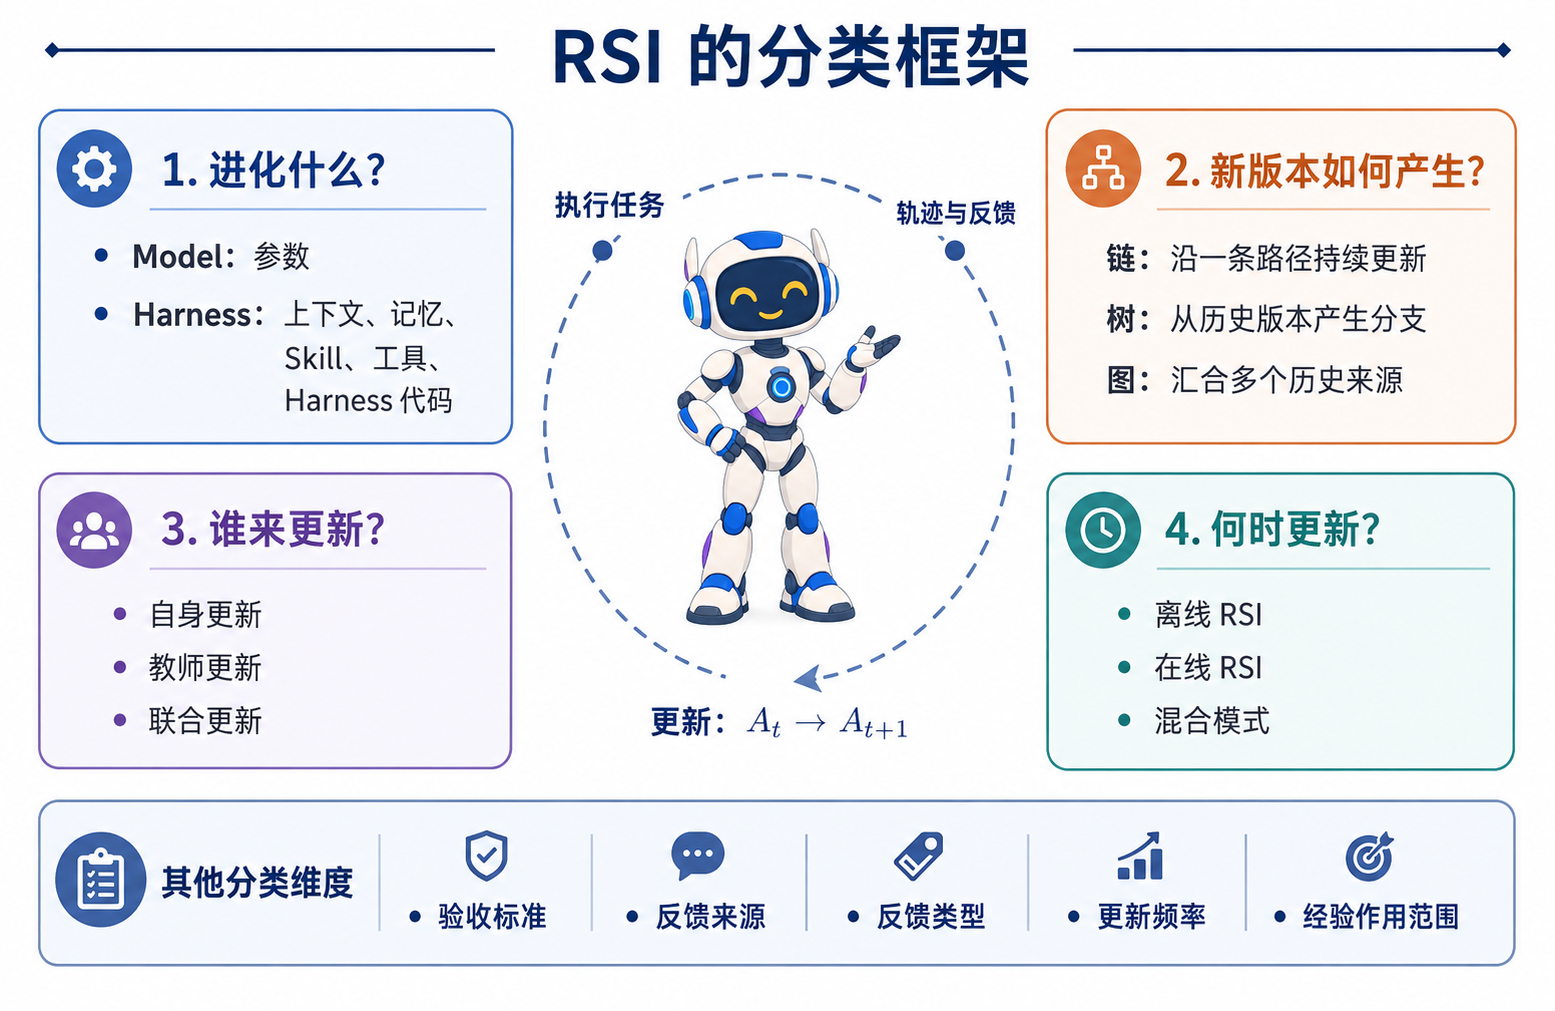
Agent 在与环境交互后,利用任务轨迹与反馈,通过更新机制修改自身状态,并让更新后的状态参与后续任务,以提升未来表现。
Agent 抽象
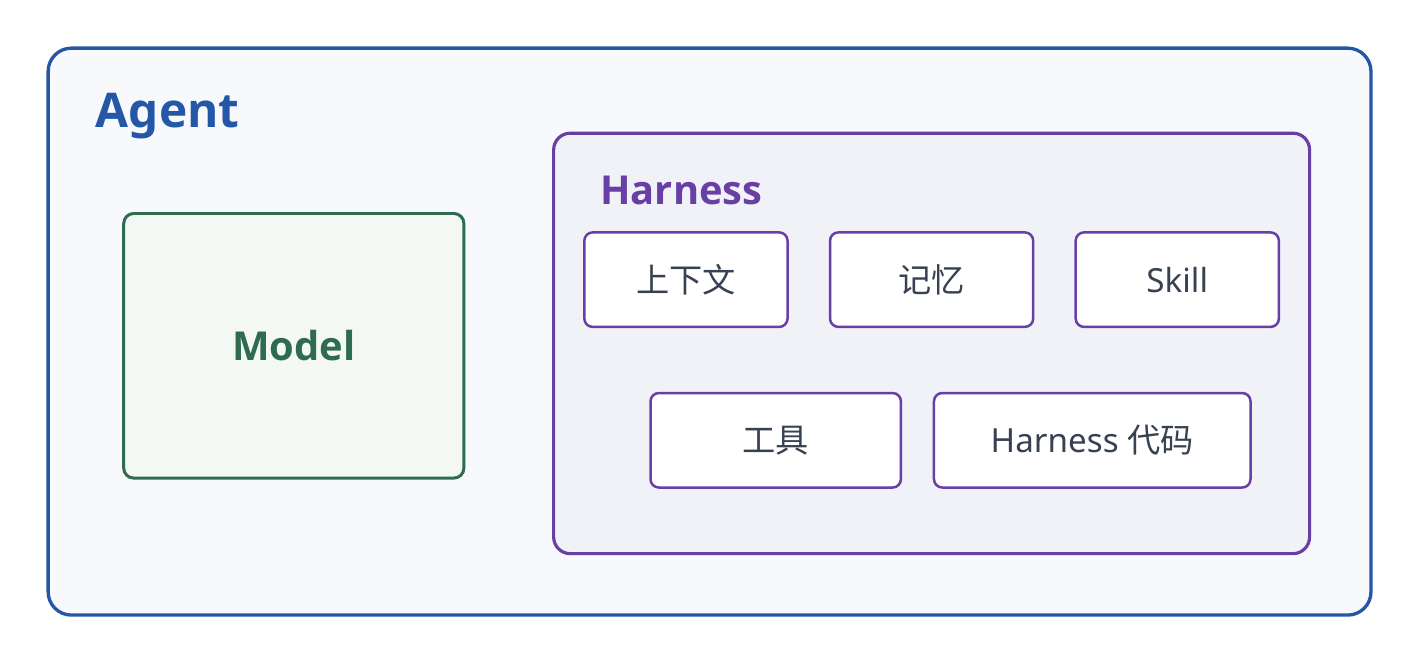
Agent=Model+Harness。
Model提供基础的理解、推理与生成能力;Harness则组织模型如何接收信息、积累经验、调用工具并完成任务,具体包括上下文、记忆、Skill、工具和 Harness 代码。
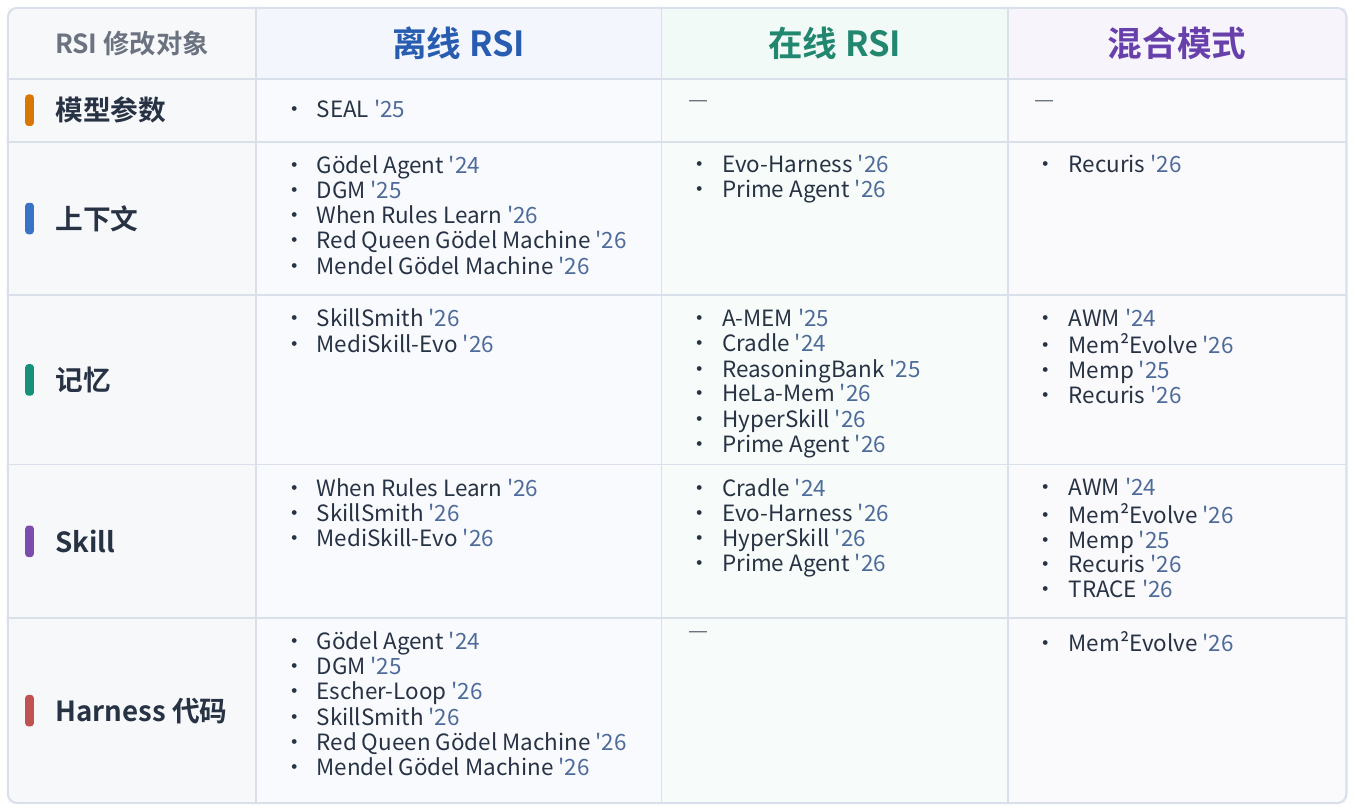
不同的 RSI 方法可能修改其中不同的部分:
- 参数进化修改 Model;
- 上下文、记忆和 Skill 进化修改 Harness 中可持续积累的状态;
- 工具与 Harness 代码进化则改变 Agent 的动作空间和控制流程。
概览
方法分类
热词: self-evolving、self-improving、recursive self-improvement(RSI)
自进化分三个方向
自我进化的优化对象是什么,就决定了属于哪个方向
- 改产出物(代码/论文/算法…)是 Artifacts
- 改脚手架(prompt/memory/tool/skill/hook…)是 Harness
- 改模型参数本身是 Model。
三者都算 RSI:
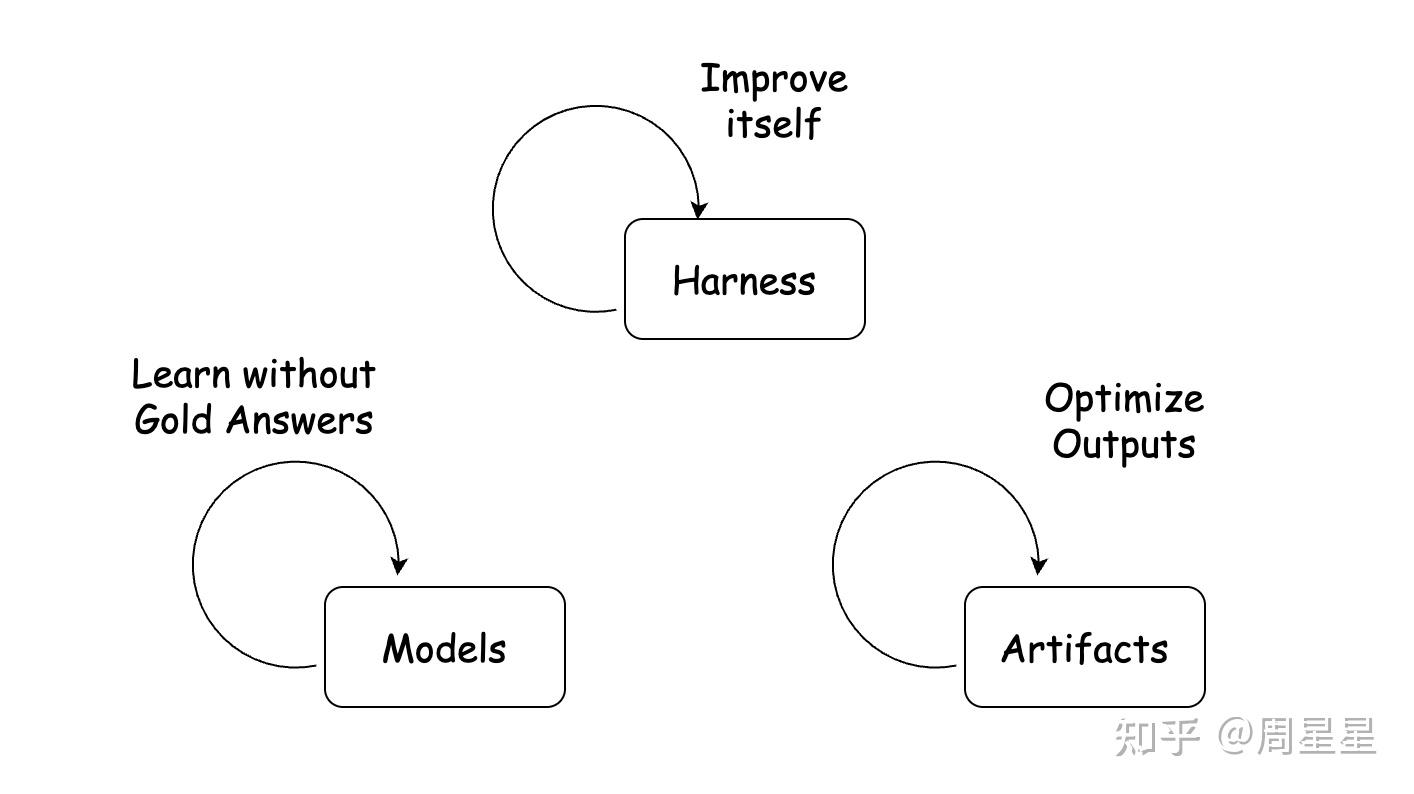
详情
- (1)Artifacts 层自进化:用强大的 LLM 反复”发现问题 → 生成产出 → 评估结果”,来优化具体的复杂问题产物(代码、论文、算法)。
- 比如任何一款 AI coding 工具,给定目标,就会写代码、自己编译、自己测试,有 bug 自己修,最终输出能达到要求的代码。
- 产出物一版比一版强,这就是 Artifacts 层面的自我进化,改的是产出物本身,不涉及模型权重,也不涉及 agent 自身的脚手架逻辑。
- 案例:
- Karpathy 的 Autoresearch:整夜自动改 train.py 迭代超参
- Google DeepMind 的 AlphaEvolve:进化算法筛选代码,成果反哺自身训练
- (2)Harness 层自进化:不动模型权重,改部署后 Agent 本身的”脚手架”:prompt、memory、tool、skill、多 Agent 路由等等等等都是这一类。
- 翁荔博客 《Harness Engineering for Self-Improvement》 判断:RSI 近期不太可能从模型直接改写自己的权重开始,更现实的路径是先在 Harness 层爆发
- 跟 Artifacts 层不一样:Artifacts 优化某次任务的产出物;Harness 优化 agent 下次执行任何任务时都会用到的那套”脚手架”,改一次,后面所有任务都受益。最直观的例子是 Agent 跑任务踩了坑,把错误总结成一条新 skill 或一段新 memory 存下来,下次碰到同类任务直接调用,不用再犯一次。agent 自己把自己的脚手架越改越顺手,这就是 Harness 层面的自我进化。
- 案例
- Hermes:踩坑自动写成 SKILL.md —— 一个任务用到5次以上工具调用,就自动写成 skill.md; Curator 后台维护机制,追踪每个技能被用了多少次、有没有被修改过,长期没用的技能会经历”活跃 → 陈旧 → 归档”的状态流转,还会定期叫一个小模型做审查、合并近似重复的技能,不是写完就无限堆量放着不管。
- MiniMax M2.7:自动跑评测迭代 scaffold,性能提升 30%; agent harness 自己收集反馈、给内部任务建评测集,再据此持续迭代自己的架构、技能/MCP 实现和记忆机制
- 陈天桥 Apodex-1.0:150 子 agent 协同检索,冲突/存疑时派发验证子团队
- Sakana 的 RHI:LLM 评估器打分驱动 harness 自我重写
- Ai2 的 Rethinking the Evaluation of Harness Evolution for Agents:预算对等后,harness 进化未必赢过简单 test-time scaling
- Weco AI 的 AIDE²:外层 agent 改内层 agent 代码,实测跑到 RSI Level 1
- (3)模型层自进化:广义的角度,不需要人工标注答案、模型自己给自己当老师的训练都能算:自己筛出高置信度/前后一致的答案反过来当训练数据(self-training、TTRL)、把内部信号转成可验证奖励再用 RL 训练(DeepSeek-R1)、两个版本的自己互相对练(自对弈,例如 SPIN、Absolute Zero)、推理时当场再学一遍(测试时训练)。不靠人喂标注答案,模型自己给自己当老师,这就是 Model 层面的自我进化。狭义的层面,是模型能自己产出下一代的训练优化方向,一代代往上迭代——模型自己训练完 → 自己测试 → 自己找问题(架构瓶颈在哪、工程实现哪里有坑、训练数据有什么问题)→ 自己提出优化方向/实验(例如自己改训练代码,自己补充训练数据)→ 再训练,整个研发循环都由 AI 自己跑。
- 案例:把”改 harness”和”改权重”拧到同一个循环里联合优化的系统(SIA、Continual Harness)、不直接做 RSI、但研究”模型内部思考链、可解释性等
- SIA:Feedback-Agent 决定该改 harness 还是改权重
- Continual Harness:内层高频改 harness,外层用 PRM 蒸馏更新权重
- 可解释性代表工作:搞懂训练怎么塑造推理
- 案例:把”改 harness”和”改权重”拧到同一个循环里联合优化的系统(SIA、Continual Harness)、不直接做 RSI、但研究”模型内部思考链、可解释性等
易混淆概念
易混概念:
- 不等于权重在线学习。 工程上常说的自进化,大多不是在线更新模型权重,而是在冻结的基座模型之外更新记忆、工具、提示词、工作流或 Agent 代码。这正是落地的原因,和”AI 递归自我改进奔向超级智能”那种叙事之间的真实距离。
- 不等于反思(reflection)。 单次任务内的 self-critique 是临时,任务结束就丢。自进化要求改进跨任务持久化。这是最硬的分界线:判断系统算不算自进化,先问这次学到的东西下次还在不在。
- 不等于 RAG。 准确的切分是:RAG 是检索机制,负责读;自进化是更新机制,负责写。一个自进化系统完全可以用 RAG 去读自己沉淀的经验库,但只读静态知识库、从不基于运行经验写回的系统,和自进化无关。
RSI 总结
【2026-9-6】RSI AI自我进化的下一站 Recursive Self‑Improvement
不只是更会回答,而是让AI自己变得更好
从辅助人类,到不断超越起自己,但这不是魔法,而是一条充满挑战的工程之路。
更多见飞书笔记
01 RSI核心能力
- ✅ 自己产生经验
- ✅ 自己生成数据
- ✅ 自己验证结果
- ✅ 自己改进方法
- ✅ 持续迭代进化
进化阶梯:回答任务 → 积累经验 → 自我改进 → 更强的AI和更大的可能性
02 核心概念区分:不是所有“自我”都叫RSI
| 概念 | 改进了什么 | 能保留多久 | 是否改变自身改进能力 | 是否属于严格意义的RSI | 一句话理解 |
|---|---|---|---|---|---|
| Self‑refine(自我修正) | 当前答案/产物 | 仅当前回答 | 否 | 否 | 把这道题做对 |
| Self‑improvement(自我改进) | 可复用的知识/技能/策略 | 跨任务/会话 | 有限 | 部分 | 下次遇到类似问题更容易做对 |
| Recursive Self‑improvement(递归自我改进) | 不仅改进任务能力,还改进改进自身的方法 | 可持续积累 | 是 | 是 | 不仅更会做题,也更会变得更好 |
Iteration:重复执行改进流程。Recursion:改进后的系统,进一步增强下一轮改进能力。 ⚠️ 不能仅凭“自动跑了很多轮”或“生成数据后又训练了一遍”,就认为实现了强意义上的RSI。
03 RSI的总体框架:从人在环路到闭环
三种环路演进:
- Human‑in‑the‑loop(人在环路): AI提出改进,但每次修改都需要人确认。
- Human‑on‑the‑loop(人在环上): 数据/reward/verifier等自动产生,人主要负责监督结果和控制部署。
- Closed loop(闭环): 系统自己产生、验证并启用改进,不再需要人工审核。
自我改进发生的两个阶段
- Test‑Time RSI(部署时进化):在解决当前任务的过程中进化,改进发生在推理过程。典型方法:self‑refine、TTT、harness evolution。
- Training‑Time RSI(训练时进化):把自己产生的数据、reward或反馈重新用于训练自身。典型方法:self‑rewarding RL、self‑distill、self‑play、auto‑research。
04 Test‑Time RSI:从回答到整个Agent
改进对象不同,保留范围也不同,并不一定是线性升级,是不同组合。
- Self‑critique & Self‑refine:只改当前回答
流程:Generate → Critique → Refine
- 模型权重不变
- 需要可靠的verification信号
- 只提升单次回答,经验通常会消失
- Test‑Time Training(TTT):在当前任务中更新参数
流程:Experience → Update(更新参数)
- 让测试时的经验写入权重
- 标准TTT:只在当前样本有效;可结合TTRL等方法传递到下个样本
- Agent: Harness Evolution:改进整个Agent
改进对象:Prompt、Skill、Tool、Workflow、Memory、Agent Code
- 从真实interaction和失败中学习工具/策略
- 自动生成/修改自己的技能和工作流
- 改进可以临时存在,也可能在推理阶段持久保存(如DGM)
💡看RSI,不只问“改了哪里”,还要问“下次启动时,这个改进还在不在”。
05 Training‑Time RSI:从数据到研究策略
(1) Zero‑label 零标签
- 自己生成监督(仍需人提供问题)
- Fine‑tuning / RL / Distillation
示例:StaR、自我奖励、OPO、on‑policy自蒸馏
(2) Zero‑data 零数据
自己生成问题/课程(连下一轮学什么也自己决定)
Proposer/Challenger生成问题 ↔ Solver解决问题
示例:Absolute Zero、R‑Zero、Agent0,从预测模型里提出任务,并通过执行获得新的学习范式
(3) Auto Research 自动研究策略 自己生成改进策略
- 分析失败原因
- 提出hypothesis
- 选取数据与训练方法
- 运行实验
- 根据结果调整完整的research process
优化的不只是问题,而是完整的研究流程;人类只提供数据集与提问,进一步退出research decision。
⚠️ 警示: 零输入人工训练样本 ≠ 零预训练知识 ≠ 零环境反馈 ≠ 零人为设计。 任务可以自己生成,但可靠反馈仍需要明确来源;并不是所有信号都来自模型的主观判断。
06 Verifier:RSI的核心瓶颈
无论是test‑time还是training‑time RSI,每一次进化都需要一个可靠的标准,来判断这次更新是否真的带来了改进。
| 任务难度 | 形式化可验证(相对容易) | 开放任务(更困难) |
|---|---|---|
| 例子 | Math、proof checker、Code、unit test、工具执行结果、机器人模拟环境 | 开放Agent任务、创意任务、研究品味与方向、需要价值观、subjective、user preference等主观形式 |
Verifier 进化方向
- Self‑Trained Verification:把verifier本身作为训练对象
- Self‑developing Deep Research Agent:持续更新评价rubric/verifier
- Meta‑evaluation:评价verifier本身
- Red Queen Gödel Machine:让agent和verifier共同进化
关键区分:允许系统改进“怎么测”,但不能仅凭它自己的判断,改写最终的验收目标。 ✅ 合理进化:增加更多测试用例、覆盖更多边界情况 ❌ 有问题的标准漂移:删除难的测试条件,得分更容易
07 如何判断“真的变强了?”验收清单
分数上涨 ≠ 能力增长;能力增长 ≠ 递归改进能力增长。
✅ 必须追问的问题(真变强)
- 新任务上也提升了吗?
- 重启后仍然提升吗?
- 旧任务有没有退步?
- 预算相同时仍有优势吗?
- 换独立验证仍然成立吗?
- 改进后的系统会产生下一轮改进吗?
❌ 排除的误判(伪变强)
- 只记住旧题、旧轨迹或评测案例
- 只是当前上下文临时表现更好,学会新能力,却丢掉原有能力
- 只是多采样、多调用工具、多消耗算力
- 只迎合了自己的judge或训练奖励
- 只证明任务能力提升,没有证明递归增强
验证“能力增强”时,应控制每个任务的推理预算;讨论“是否值得落地”时,还要计入生成数据、训练、评测和维护的总成本。
08 工程落地闭环:从候选改进进到安全发布
真正可持续的RSI,需要工程化的准入、评估和回滚机制。 流程:收集失败与经验 → 提出候选改进 → 在隔离环境中测试 → 独立评估、旧能力回归测试 → 通过准入条件 → 小范围发布 → 监控真实表现 → 保留改进或回滚
必要的安全边界
- ✅ 沙箱环境 / 受限权限(如DGM)
- ✅ 人类对目标、权限和发布的控制
- ✅ 保留修改历史,可回滚
- ✅ 监控异常行为,防止奖励黑客
常见风险
- Self‑confirming loop(自我强化偏差)
- Training collapse(训练崩溃)
- Diversity collapse(数据/模型多样性下降)
- Reward grounding failure(奖励锚定失败)
- Policy and verifier drift(策略/验证器偏移)
RSI不是终点,而是一种新的学习范式。 更好的AI,不是被设计出来的,而是学会自我进化的。 底部标语:Humanity × AI A Better Tomorrow
自进化系统
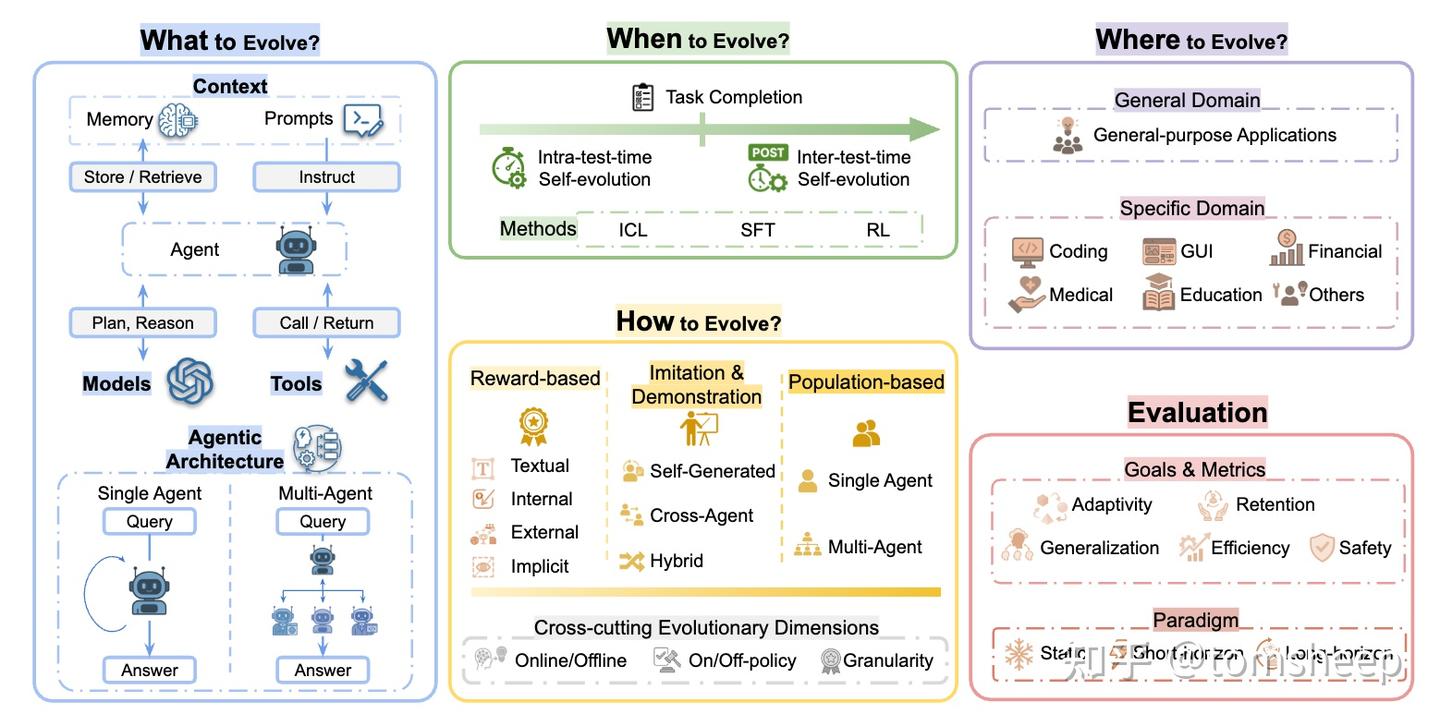
2025 年,系统综述《A Survey of Self-Evolving Agents》用三个维度组织这个领域:
- 进化什么(模型、记忆、工具、架构)
- 什么时候进化(任务内 intra-test-time、任务间 inter-test-time)
- 怎么进化(标量奖励、文本反馈、单/多智能体)。
注意定义并不限于”上线之后”,任务执行过程中的演化也算。但工程上最有价值、也最常被讨论的是任务间的持久演化——系统用得越久越好用。
人类学习逻辑:
做事留记录(运行轨迹)→复盘好坏(反馈评分)→总结经验(提炼)→记住经验(持久更新)→下次活用(任务复用)→检验进步(效果评估)→继续优化。
闭环流转顺序:
运行轨迹→反馈/评分→经验提炼→持久更新→后续任务复用→效果评估,循环往复持续迭代。
大多数自称”自进化”的系统至多实现了”经验提炼→持久更新→后续任务复用”这中间三段(”经验提炼”往往还只是粗暴摘要),而”反馈/评分”和”效果评估”这两个评价环节普遍缺位
记忆和技能沉淀的基础设施已实用化,提示词自动优化半实用,架构和权重层自改进仍是研究品——而严格意义上的完整自进化闭环,在哪一层都还算不上普遍。卡住后两层的,不是”怎么进化”,是”怎么评估”——Agent 自己改了自己,谁来判断改得对不对?
综述:AI 如何实现自我进化
【2025-7-30】普林斯顿、清华、CMU等综述:AI 如何实现自我进化?
截止2025年7月,「自进化智能体」(Self-Evolving Agents)领域的进展。
- 当前,尽管大语言模型(LLM)能力强大,但本质上「静态」,一旦训练完成,其内部参数就不会再改变。
- 这在需要实时适应新知识、新任务的动态世界中成了一个巨大的瓶颈。
与环境互动、从经验中学习并持续自我完善的智能体。
理论框架,围绕三个核心问题展开:进化什么(What)、何时进化(When) 以及 如何进化(How)。
- 论文: A Survey of Self-Evolving Agents: On Path to Artificial Super Intelligence
- github Self-Evolving-Agents
What-When-How 框架系统地解构和理解所有关于「自进化」的研究。三个维度分别是:
- (1)进化什么?(What to Evolve?):智能体作为一个系统,它的哪些部分可以被改进?模型、上下文、工具、架构
- (2)何时进化?(When to Evolve?):进化的过程发生在任务的哪个阶段?
- 「任务中进化」追求的是灵活性和即时响应
- 「任务间进化」追求的是系统性提升和长期成长。
- 一个优秀的自进化智能体,需要兼具这两种能力。
- (3)如何进化?(How to Evolve?):驱动进化的具体方法和信号是什么?
- 三大类进化引擎:奖励、模仿和演化
斯坦福 自进化 Agent课程
【2026-8-10】Stanford 研究生课程
- 主页 CS329A:Self-Improving AI Agents
- YouTube地址 一共 9 讲。
围绕问题展开:AI Agent 怎么通过和环境不断交互,持续改进自己的能力。
内容从 Test-Time Compute、Verifier 和 RL 讲起,后面会进入工具/代码反馈、多步推理与规划、Deep Research、自我改进,以及 Agent 的长时任务评测。
把散落在论文里的方向串到一起:从「怎么让 Agent 多思考」,一路讲到「怎么验证结果、从反馈学习,再把这些能力放进更长的任务里」。
五个层级
自进化的五个层级
记忆层。 把交互历史沉淀成长期记忆,下次遇到类似问题直接复用——”这个用户的部署环境是 K8s”、”上次这个报错的根因是配置漂移”。目前最成熟、最普及的一层,Mem0、Letta(原 MemGPT)是这一层的代表性基础设施。技能/工具层。 Agent 把验证过的解题过程固化成可复用的技能,甚至自己写新工具。经典案例是 2023 年的 Voyager:在 Minecraft 里自动探索,把学会的动作沉淀成代码技能库,后续任务直接调用,能力滚雪球式增长——全程不微调模型权重。Claude Code 的 Skills 机制常被拿来类比,但要说清楚:Skills 是技能沉淀的承载形式,目前主要由人编写、Agent 辅助生成。只有当 Agent 能自动完成提议、验证、注册、回滚这一整套动作时,才算进入自进化——有 skill 机制不等于在自进化。提示词/策略层。 自动优化自己的提示词和工作流。DSPy 这类框架把提示词当可优化参数,但要分清优化发生在哪:发生在离线编译阶段的,是开发期优化,按本章定义不算自进化;只有优化结果在运行期被持久写回、影响后续任务,才进入自进化的讨论范围。self-refine 循环同理——跑一遍、自我批评、改进策略再跑,改进若不出会话,就只是反思。这一层的工具链已经成熟,真正闭环到运行期持久写回的用法还不多。架构层。 Agent 修改自己的代码和结构。2025 年 Sakana AI 与 UBC 的 Darwin Gödel Machine 是标志性工作:Agent 重写自己的实现代码,用编码基准实证验证每次修改,维护一个不断扩张的变体档案库做”进化树”。成绩是真的:SWE-bench 从 20.0% 提到 50.0%,Polyglot 从 14.2% 提到 30.7%。但前提也是论文摘要自己写明的:”All experiments were done with safety precautions (e.g., sandboxing, human oversight)”——这是带沙箱、带人工监督、有干净评分基准的实验结果,不代表生产系统的成熟度。模型权重层。 通过在线 RL 或自生成数据微调更新模型本身。学术定义里它是自进化的一层,但在生产闭环里直接在线更新权重仍极少见——现实中这个需求通常被拆解成离线再训练、灰度评测、安全审核的传统流程。它不是什么
资料
技术路线
按”是否更新模型权重”和”是否依赖人工数据”两个维度划成了三类
| 路线 | 更新模型权重? | 依赖人工数据? | 代表工作 |
|---|---|---|---|
| 第一类:经验/Skill存储型 | ❌ 不更新 | ❌ 依赖 | AutoSkill、EvoSkill、MemSkill、CoEvoSkills、SE-Agent、Hermes |
| 第二类:RL训练型 | ✅ 更新 | ❌ 依赖 | EvolveR、SAGE、SkillRL、SKILL0、SkillIOS、AgentEvolver |
| 第三类:0数据自学型 | ✅ 更新 | ✅ 不依赖 | Agent0、Tool-R0、Absolute Zero |
差异:
- 第一类给 Agent 配一本”工作笔记”,模型本身不动,只在需要时翻阅;
- 第二类直接把”工作笔记”上的经验通过 RL 写进模型的权重里,让 Agent 真正”长本事”;
- 第三类更激进——干脆连”老师”都不要了,让 Agent 之间互相出题互相考试,自己跟自己打。
【2026-7-27】腾讯技术工程文章:Agent开始“自我进化”:会出题、会反思,还会自己长出新技能
第一类:经验/Skill 存储型
经验/Skill 存储型(不更新模型权重)
特征:
- 不训练、跨会话保留上下文、文件式存储;核心是把经验沉淀为可检索/可复用的”技能(Skill)”。类比来看,这类工作就像是给 Agent 配了一个”外挂大脑”,本体(base LLM)保持冻结,所有的”成长”都发生在外挂里。
案例
- AutoSkill(arXiv: 2603.01145) 双环结构, 动态增删改查 Skill 来防止 Skill 库爆棚。
- EvoSkill(arXiv: 2603.02766)让多个 Agent 分工协作——执行、反思、落地——把”失败”变成”新 Skill”,并用 Pareto 前沿机制保证 Skill 库永远精而不滥。EvoSkill 来自 Sentient 和弗吉尼亚理工的合作工作,主张是把传统 Agent “失败即重试” 的笨办法改造成 ”失败即学习” 的进化闭环。它的最大特点是把 Skill 当作一等公民来升级,而不是只在 prompt / code 层面做文字游戏。
- MemSkill(arXiv: 2602.02474)前两个工作针对用户指令;MemSkill 只针对操作 Memory 的 Skill 做自进化。
- CoEvoSkills(arXiv: 2604.01687v2)TLDR:给每条新总结的 Skill 配一个”考官”(Verifier),生成的 Skill 必须先通过考试才能进库;通不过就带反馈打回,让 Generator 重写——这是把软件工程的”单元测试”理念搬到了 Skill 进化里。CoEvoSkillsn解决老大难问题:Skill 总结出来到底靠不靠谱? AutoSkill / EvoSkill 都是”生成完了直接入库”,质量基本靠 LLM 自觉。CoEvoSkills 的回答是:不能靠自觉,得有验证闭环。
- SE-Agent(arXiv: 2508.02085)与其反复”自我反思”在同一条轨迹上小修小补,不如一次跑出多条轨迹,让它们互相借鉴、互相打磨——SE-Agent 把 Agent 自进化从”单线程深度修补”切到了”多线程横向融合”。
更多见站内技术专题:Skill自进化
第二类:基于 RL 的训练型自进化
特征:
- 通过 RL 训练直接更新模型权重,让模型从根本上变强。当前学术界与工业界的主流方向
第二类工作走得比第一类更远:把经验从”外挂”变成了”权重”。
但仔细看仍能拎出几条共性:核心点
- 仍然依赖训练集反馈(除 AgentEvolver 外) 核心点
- 核心是 RL rollout 时继承/更新之前的 skill核心点
- 不算严格意义的”RL by talking” —— 因为反馈仍来自任务结果或人工标签,而不是交互对话本身
案例
- EvolveR(arXiv: 2510.16079)
- SAGE(arXiv: 2512.17102)提出 Sequential Rollout —— RL rollout 时序列化地跑一系列相似任务,后序任务训练时就可以使用前序生成的 skill。
- SkillRL(arXiv: 2602.08234)用强模型(o3)蒸馏 Skill,再通过 RL 训练弱模型学会使用,并递归进化技能库
- SKILL0(arXiv: 2604.02268)将 Skill 从推理时的”外挂上下文”内化到模型参数,实现零样本执行(每步 < 0.5K tokens)。
- SkillOS(arXiv: 2605.06614)最有启发。训练专门的 Curator,通过 RL 学会如何增 改 删 SkillRepo,而不是直接学如何使用 Skill。
- 核心设计哲学:”学会如何管理技能,而不是学会如何使用技能” —— Executor 冻结,只训练 Curator,通过长周期间接奖励信号学习 Skill 的增删改策略。
- AgentEvolver(arXiv: 2511.10395)完全自主的三环自演化框架 —— 自出题、自解题、自总结经验,全链路无需人工标注。
第三类:0 数据自学型
特征:
- 完全不要人工标注的数据,靠 Agent 之间互相出题/解题闭环。
这一类的精神更激进:连数据集都不要,Agent 自己出题自己考自己。
总结:真·不需要训练数据通用流程:
出题 Agent 训练 → 出题构造数据集 → 解题 Agent 训练 → 出题 Agent 训练 …
核心点
- 全靠出题的 Agent 自己核心点
- 准确率判断大多靠对照出题 Agent 自己给出的答案——这是个隐患,sliver answer 的可靠性需要打问号核心点
- 最好要有自动化的判断标准——比如 Absolute Zero 用的代码执行器核心点
- 出题难度很重要——太难学不懂,太简单学不到,这个 reward shaping 是核心难点核心点
- 评估很混乱——只有数学类的 benchmark 勉强出现了多次,其余几乎完全没有重叠,可比性差
案例
- Agent0(arXiv: 2511.16043)学习工具使用,一个 Agent 负责出题,一个 Agent 负责解题。
- Tool-R0(arXiv: 2602.21320)类似 Agent0,但做的是 general tool 而不是纯数学。
- Absolute Zero(arXiv: 2505.03335)单个模型同时扮演出题人和解题人,用代码执行器作为唯一的验证来源,完全不碰任何外部数据。
进化案例
【2025-2-18】港大 AutoAgent
【2025-2-18】 港大开源全自动且高度自我进化的零代码AI Agent框架:AutoAgent
AutoAgent 是全自动且高度自我进化的框架,用户仅需自然语言即可创建并部署 LLM Agent。
核心特性
- 🏆 GAIA 基准测试冠军
- AutoAgent 在开源方法中排名 #1,性能媲美 OpenAI 的
Deep Research。
- AutoAgent 在开源方法中排名 #1,性能媲美 OpenAI 的
- 📚 Agentic-RAG,内置自管理向量数据库
- AutoAgent 配备原生自管理向量数据库,超越 LangChain 等行业领先方案。
- ✨ 轻松创建 Agent 和工作流
- AutoAgent 利用自然语言轻松构建可直接使用的工具、Agent 和工作流 —— 无需编码。
- 🌐 广泛兼容 LLM
- AutoAgent 无缝集成多种 LLM(如 OpenAI、Anthropic、DeepSeek、vLLM、Grok、Huggingface…)。
- 🔀 灵活交互模式
- 支持函数调用(Function-Calling) 和 ReAct 交互模式。
- 🤖 动态、可扩展、轻量级
- AutoAgent 是你的个人 AI 助手,具备动态、可扩展、可定制、轻量级的特性。
使用方法
- 用户模式(SOTA 🏆 对标 OpenAI Deep Research)
- AutoAgent 内置多智能体(Agent)系统,你可以在启动页面选择用户模式直接使用。这个多智能体系统是一个通用 AI 助手,具备与 OpenAI Deep Research 相同的功能,并在 GAIA 基准测试中实现了可媲美的性能。
- 🚀 高性能:基于 Claude 3.5 实现 Deep Research 级别的表现,而非 OpenAI 的 o3 模型。
- 🔄 模型灵活性:兼容任何 LLM(包括 DeepSeek-R1、Grok、Gemini 等)。
- 💰 高性价比:开源替代方案,无需支付 Deep Research $200/月 的订阅费用。
- 🎯 用户友好:提供易部署 CLI 界面,交互流畅无阻。
- 📁 文件支持:支持文件上传,实现更强的数据交互能力。
- 🎥 Deep Research(即用户模式)
- Agent 编辑器(无工作流的 Agent 创建)
- AutoAgent 最具特色的功能是自然语言定制能力。不同于其他 Agent 框架,AutoAgent 允许你仅通过自然语言创建工具、Agent 和工作流。只需选择 Agent 编辑器或工作流编辑器模式,即可开启对话式构建 Agent 之旅。
- 工作流编辑器(使用工作流创建 Agent)
- 通过工作流编辑器模式,使用自然语言描述创建代理工作流,如下图所示。(提示:此模式暂时不支持工具创建。)
【2025-3-8】AppAgentX 进化
【2025-3-8】西湖大学 推出自学习能力 Agent
进化框架,提高运营效率,同时保持智能和灵活性
每个步骤,Agent 都会
- 捕获设备的当前屏幕并分析,从预定义的作空间中选择合适的作。
- 执行所选作,与 GUI 交互。
- 任务执行轨迹被分解为多个重叠三元组。基于这些三元组,生成LLM页面和 UI 元素的功能描述。
- 将合并重复生成的页面描述。
- 整个交互历史记录使用节点链进行记录。
进化机制可识别重复序列并创建高级快捷方式,从而显著减少常见任务所需的步骤数和推理。
AppAgentX 在多个基准任务中的效率和成功率都明显优于现有方法。
- 与 GPT-4o 相比, AppAgentX 执行步数、耗时、token花销大幅降低,而准确率最高
【2025-8-5】CMU SQLM
大语言模型的训练很大程度上仍依赖人工整理数据集,堪称费时费力。
为了减轻这一负担,研究人员开发了用于强化学习的无监督奖励函数,然而,这些函数仍然依赖于预先提供的高质量输入提示。
因此,问题难点从“生成答案”转移到了“生成高质量问题”。
当前方法的关键不足:
- 缺乏可扩展且自我维持的流程,能够在无人干预的情况下自动生成有意义的问题和答案。
【2025-8-5】无需外部数据!AI自问自答实现推理能力进化
卡内基梅隆大学提出新框架SQLM——一种无需外部数据的自我提问模型。
- 论文 SELF-QUESTIONING LANGUAGE MODELS
- 该框架包含
提问者(proposer)和解答者(solver)两个角色,提问者生成与给定主题相关的问题,解答者旨在解决问题。 - SQLM框架,非对称的自我博弈框架
堪称:带 RL 的 GAN
实验结果显示
- SQLM 将 Qwen2.5-3B-Instruct 在算术任务上的准确率提高了14%,在代数任务上提高了16%;在编程任务上的准确率提高了7%。
此外,上表还显示出SQLM显著优于格式奖励基线(用于稳定训练和规范输出格式的参考值),表明推理能力的真正提升。
【2025-8-7】腾讯 R-Zero
【2025-8-7】腾讯AI Lab(西雅图),腾讯AI Lab推出「零数据自进化」推理LLM
- 论文标题:R-Zero: Self-Evolving Reasoning LLM from Zero Data
- 项目主页 R-Zero: Self-Evolving Reasoning LLM from Zero Data
- Code: R-Zero.
自我进化的大语言模型(LLM)通过自主生成、优化并从自身经验中学习,为实现超级智能提供了可扩展的途径。
然而,当前训练此类模型的现有方法仍高度依赖于海量的人工标注任务和标签,通常通过微调或强化学习实现,这构成了推动人工智能系统超越人类智能能力的根本瓶颈。
为克服这一限制,腾讯AI Lab 团队推出了一个完全自主、能够从零开始生成自我训练数据的框架——R-Zero。
从单个基础 LLM 出发,R-Zero 初始化两个具有不同角色且独立运行的模型:挑战者(Challenger)和解决者(Solver)。
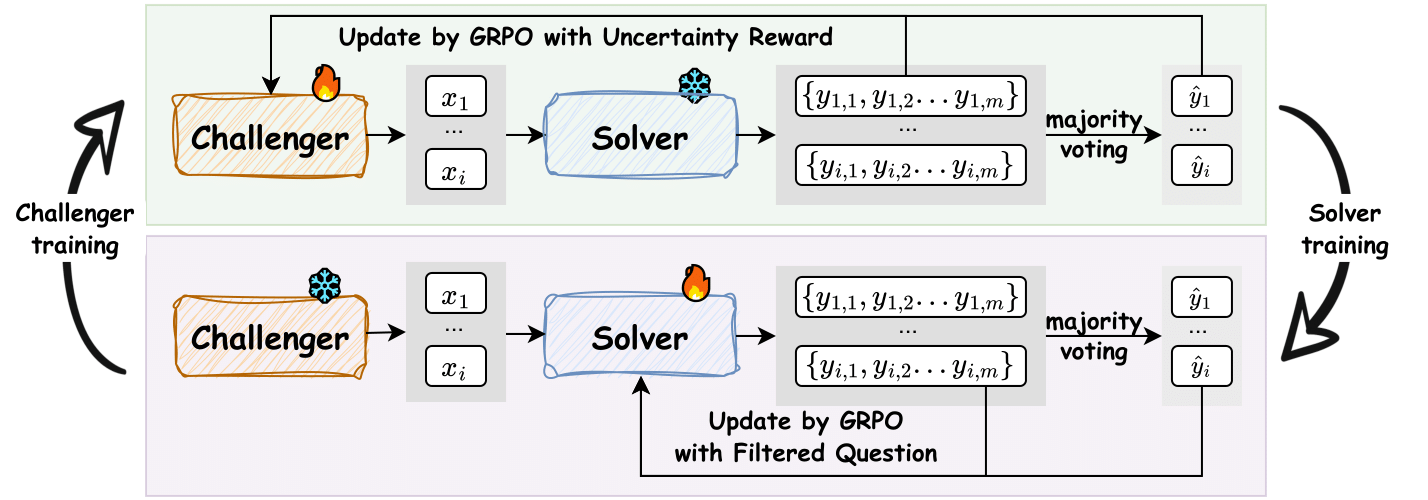
这两个模型分别进行优化,并通过相互作用实现协同进化:
挑战者因提出接近解决者能力边界的任务而获得奖励,而解决者则因解决挑战者提出的日益复杂的任务而获得奖励。
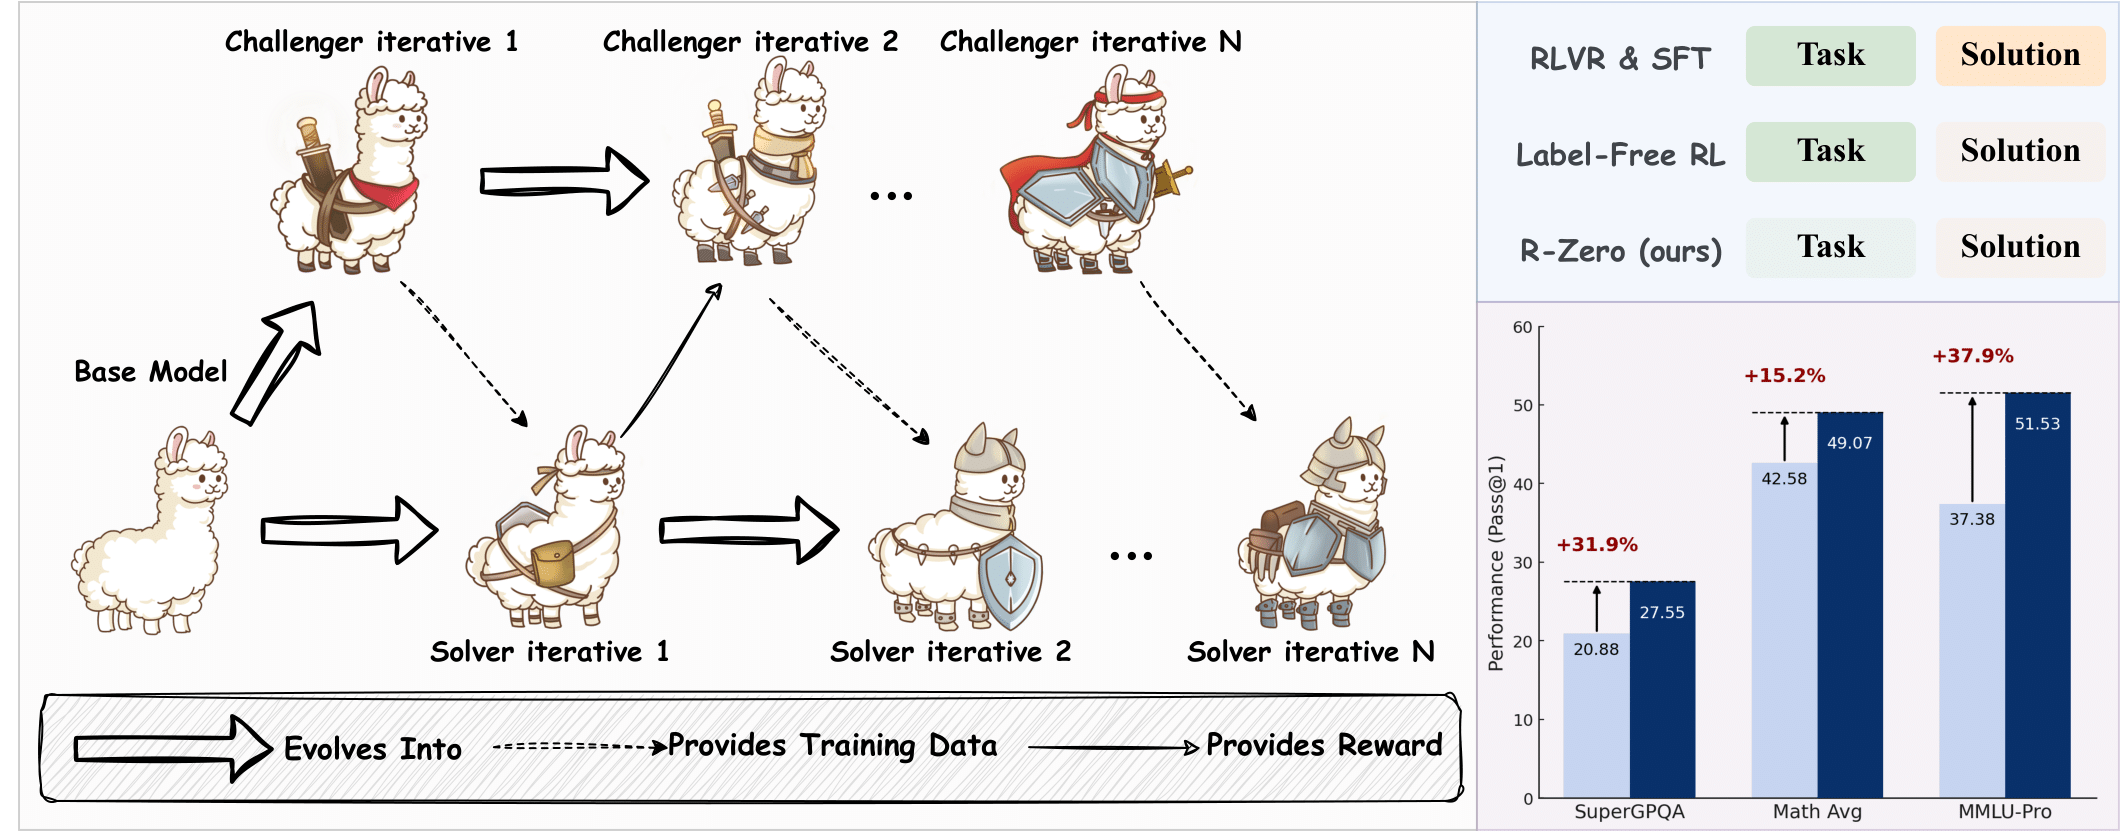
这一过程产生了无需预先存在的任务和标签的针对性、自我改进的课程。
实验结果表明
- R-Zero 显著提升了不同基础 LLM 的推理能力,例如在数学推理基准测试中使 Qwen3-4B-Base 的性能提升 6.49,在通用领域推理基准测试中提升 7.54。
【2025-11-20】斯坦福 agent0
【2025-11-20】斯坦福 agent0
已有自我进化框架:受限于模型能力和单轮交互,难以实现包含工具使用、动态推理的复杂模式进化
Agent0 全自主的智能体进化框架,通过多步协同进化、无缝工具集成,无需外部数据即可培育出高性能智能体
Agent0 让两个基于相同 LLM 初始化的智能体形成共生竞争关系:
- 一个是课程智能体,负责提出难度逐步提升的前沿任务;
- 另一个是执行智能体,专注于学习解决这些任务。
框架集成外部工具以增强执行智能体的问题解决能力,反过来促使课程智能体设计更复杂、且能适配工具使用的任务。
通过这一迭代过程,Agent0 构建起自我强化的循环,持续生成高质量的训练课程。
核心思想:
- Agent0 从同一个基础LLM创建两个智能体,并迫使它们进入竞争性的反馈循环。
- 一个发明任务,一个试图生存。这种持续的推拉产生的前沿难度问题是任何静态数据集都无法比拟的。
解决了自进化智能体的最大失败模式:停滞。
大多数智能体只生成比他们当前水平稍微难一点的问题。Agent0使用不确定性、采样答案之间的分歧和工具调用频率来检测执行智能体的弱点。
实证结果表明
- Agent0 显著提升了模型的推理能力:在数学推理基准测试中,Qwen3-8B-Base 模型性能提升 18%;在通用推理基准测试中,性能提升 24%。
【2025-11-13】AgentEvolver
【2025-11-13】通义实验室开源新框架 AgentEvolver,通过「自我提问」「自我导航」「自我归因」三大机制,系统性解决智能体强化学习中的任务稀缺、探索低效和样本利用率低等瓶颈。
大多数智能体系统仍停留在“按照指令完成任务”的层面——缺乏持续学习、适应变化的能力。
三大瓶颈:
- 任务构建成本高:新的环境往往需要重新定义任务与目标,人工成本高、覆盖面有限。
- 探索效率低:强化学习依赖大量交互采样,训练成本与时间消耗巨大。
- 样本利用不充分:奖励稀疏且模糊,模型难以判断哪些中间步骤真正起作用。
AgentEvolver 推动智能体从“被训练”迈向“自进化”的新范式
AgentEvolver 核心是由三大机制驱动的动态学习闭环。让智能体不再是被动执行任务的“工具”,而是一个能不断学习、总结、改进的动态系统
三大机制的协同作用,驱动智能体在复杂环境中持续优化和演化:
- 自我任务生成(Self-Questioning):自主生成探索任务,摆脱对人工数据集的依赖。
- 自我经验导航(Self-Navigating):高效复用历史经验,提升探索效率。
- 自我反思归因(Self-Attributing):精细评估步骤级奖励,提升样本利用率。
自我任务生成
【2026-3-17】MetaClaw
【2026-3-17】CMU、伯克利推出 MetaClaw 持续元学习框架
结合 OpenClaw,精准解决落地智能体静态固化、能力跟不上用户需求漂移的核心痛点。
🔑 关键方法
- 1️⃣ 技能驱动快速适配:从失败轨迹中蒸馏可复用的行为指令,无参数更新、零服务停机,prompt注入即刻生效
- 2️⃣ 机会主义策略优化:通过OMLS调度器捕捉用户空闲窗口,用云端LoRA+RL做梯度更新,全程不打扰正常使用
💡 核心创新
- 1️⃣ 双时间尺度互补闭环:秒级prompt技能进化+小时级梯度策略优化双向赋能,形成越用越强的良性学习循环
- 2️⃣ 技能版本隔离机制:严格拆分支撑数据与查询数据,彻底解决旧轨迹 stale reward 污染RL训练的行业痛点
- 3️⃣ 轻量化代理架构:无需本地GPU,兼容主流LLM厂商与智能体平台,可直接落地生产级大模型
📊 实验效果
- ✅ 纯技能适配让Kimi-K2.5准确率相对提升最高32.2%,全流程将其准确率从21.4%拉至40.6%,几乎追平GPT-5.2基线
- ✅ 端到端任务完成率提升8.25倍,文件校验完成率暴涨185%
- ✅ 跨域适配23步全自动科研管线,仅技能注入就将综合鲁棒性提升18.3%,阶段重试率降低24.8%
【2026-3-19】LSE
LLM 部署后遇到新任务时,最常见的做法是”自我反思”——让模型审视之前的失败并修改自己的 prompt。但问题:没人教过模型怎么做”自我进化”这件事。
- 所有现有方法(TextGrad、GEPA 等)都依赖模型天生的推理能力来做 prompt 优化,从未专门训练过这项技能。
问题
- 从未被专门训练
- 线性路径锁死
- 奖励信号含噪
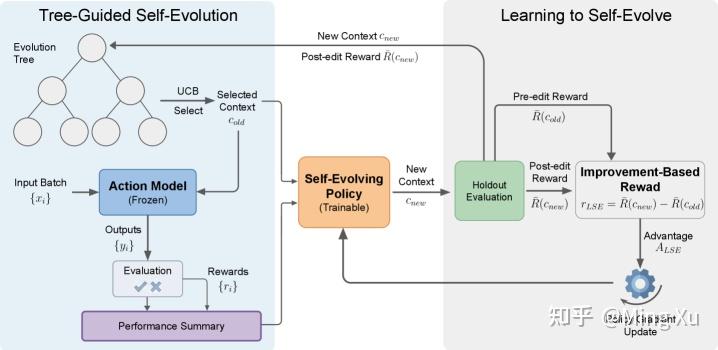
Snowflake 团队提出 LSE(Learning to Self-Evolve)框架:用强化学习训练 4B 参数的”自进化策略”,专门学习如何改进上下文。
- 配合 UCB 树搜索防止进化路径塌缩,LSE 训练的 Qwen3-4B 在 Text-to-SQL(BIRD)上以 67.3% 超越 GPT-5 的 65.2%,在 MMLU-Redux 上以 73.3% 超过 GPT-5 的 72.5%。平均提升 +6.7 个百分点。 LSE 学到的不是针对特定模型的技巧,而是一种通用的”如何从反馈中改进上下文”的元能力
- 更关键: 训练好的自进化策略可以零样本迁移到完全不同的模型上,为其提供 +6.7% 的提升。
- 论文 Learning to Self-Evolve
- 解读 4B 小模型击败 GPT-5:Learning to Self-Evolve 用强化学习教会 LLM 在测试时自我进化
LSE 框架总览。
- 左侧为测试时的树引导自进化循环——UCB 算法从进化树中选择节点,Action Model 在新批次上执行后生成性能摘要,Self-Evolving Policy 据此提出新上下文。
- 右侧为训练流程——用改进量(编辑后性能 - 编辑前性能)作为 RL 奖励信号。
【2026-3-24】Hermes Agent
【2026-3-24】自主进化 Hermes Agent 适合自动化编程、浏览器操作等需持续学习的场景,能从任务中自动提炼复用技能。作为新兴开源项目,初期配置有一定技术门槛,复杂任务中的自主进化能力可能需要调优。
- 项目主页:Hermes Agent,GitHub hermes-agent
Nous Research 开发的开源自主 AI 智能体,2026年2月27日正式发布
curl -fsSL https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.sh | bash
source ~/.bashrc    # reload shell (or: source ~/.zshrc)
hermes              # start chatting!
# 命令
hermes              # Interactive CLI — start a conversation
hermes model        # Choose your LLM provider and model
hermes tools        # Configure which tools are enabled
hermes config set   # Set individual config values
hermes gateway      # Start the messaging gateway (Telegram, Discord, etc.)
hermes setup        # Run the full setup wizard (configures everything at once)
hermes claw migrate # Migrate from OpenClaw (if coming from OpenClaw)
hermes update       # Update to the latest version
hermes doctor       # Diagnose any issues
随你成长的 AI 智能体。
部署在自己服务器上,连接消息账号,成为持久个人智能体
- 学习你的项目、自动构建技能、随时随地触达你。不是聊天机器人,不是代码补全工具,而是一个住在你机器上、每天都在变聪明的智能体。
Hermes Agent 将持久记忆、自动技能创建和多平台接入整合在一个开源包中。
- 持久记忆:跨会话记住你的偏好、项目和环境。运行越久,越了解你——不再需要每次重新解释上下文。
- 自动技能创建:当 Hermes 解决了一个难题,它会写下可复用的技能文档,永远不会忘记解决方法。技能可搜索、可分享,兼容 agentskills.io 开放标准。
- 多平台消息网关:通过单一网关进程连接 Telegram、Discord、Slack、WhatsApp、Signal 和 CLI。支持语音备忘录转录,跨平台无缝切换。在 Telegram 开始对话,在终端继续。
- 定时自动化任务:内置 cron 调度器,可向任意平台推送。设置每日报告、夜间备份、每周审计和晨间简报——全部无人值守运行。
- 并行子智能体:为并行工作流生成隔离的子智能体,每个都有独立的对话和终端。通过 RPC 将多步骤流水线压缩为零上下文消耗的操作。
- 完整浏览器与网页控制:网页搜索、页面提取、完整浏览器自动化——导航、点击、输入、截图。还支持视觉分析、图像生成、文字转语音和多模型协作推理。
支持本地龙虾信息迁移: 导入人设、记忆、技能、命令、消息、api等信息
hermes claw migrate              # Interactive migration (full preset)
hermes claw migrate --dry-run    # Preview what would be migrated
hermes claw migrate --preset user-data   # Migrate without secrets
hermes claw migrate --overwrite  # Overwrite existing conflicts
【2026-3-19】 HyperAgents
【2026-4-15】AI学会左脚踩右脚自进化?Meta华人新研究改写Agent法则
【2026-3-19】华人学者 Jenny Zhang 在Meta实习期间,联合Meta AI、UBC、纽约大学等机构研究者,提出新智能体框架:HyperAgents(DGM-H)。
- 论文 Hyperagents
重点不是再造一个更能干活的Agent,而是瞄准更高层问题:
- 如果AI已经能够修改自己的任务解法,那能不能连「自己以后该怎么修改自己」这件事,也一并改掉?可以
HyperAgents 把「执行任务的 agent」和「负责改进 agent 的 meta agent」合并进同一个可编辑程序里,作者将之称为 hyperagent。
新框架下,系统不只会修改任务求解逻辑,还开始修改未来生成改进方案的机制本身,称为 metacognitive self-modification,元认知自我修改。
过去行业竞争的是:谁的Agent更会干活。而HyperAgents 指向的下一阶段则可能是:谁的Agent更会变强,而且会越来越会变强。
上一代自我进化路线的天花板。
去年 Darwin Gödel Machine(DGM)已经很惊艳。在coding任务中不断自改代码、自我验证、把成功版本存进archive,再从这些「垫脚石」里继续往前长。
但DGM 之所以能在coding里成立,是因为「评估」和「自我修改」本身也都是coding任务。一旦离开coding,这个对齐关系就断了。比如评审论文、设计机器人奖励函数、给IMO级数学解答打分,这些任务做得更好,不等于你就更会修改自己的元机制。
HyperAgents 最核心的一招:直接把这个假设砍掉:
既然任务能力和自我改进能力未必天然对齐,那就不要再把meta层写死。
表面上看,HyperAgents只是多了一个meta agent。
但真正值得注意的是,它把task agent和meta agent合成了同一个可编辑程序。HyperAgents 不是「再加一个Agent」,而是取消了「上层永远不变」这个默认前提。
【2026-6-30】POLARIS
【2026-6-30】7B模型也想实现递归自我进化?POLARIS 说没问题
哥德尔智能体(Gödel Agent) 提出的“递归自我改进”概念虽然酷炫,但在 7B 等规模的模型(SLM)上落地时面临严重的资源瓶颈。
常因上下文增长过快导致 OOM(内存溢出)或工具调用失范。
其根源在于:
- 验证集冗余:原框架需在内存中保留 20 个验证样本及其完整的推理链路;
- 历史链条过长:保留过多的进化步骤和工具调用历史(通常为 10 步),挤占了 SLM 稀缺的上下文窗口。
POLARIS 核心价值在于证明:递归自我改进并非大模型专属。
通过将“学习”转化为“针对自身 Policy 代码的结构化修补”,SLM 同样能在部署后通过与环境的交互完成自我进化。
核心方案:基于经验抽象的策略修复
POLARIS 放弃了全量存储失败案例,转而采用一种类似“自动程序修复(APR)”的四阶段循环:
- A. 失败分析(Failure Analysis): 智能体调用 AnalyzeFailure 算子,对 N 个(通常取 3 或 5)失败样本进行反思,生成包含故障诊断、修正方案和预防规则的结构化记录 A_i。
- B. 策略综合(Strategy Synthesis)通过 StrategySynthesis 算子,模型将零散的报错记录 A 压缩为通用指令集 delta(如任务分解、逻辑一致性检查等),从而实现跨任务的经验迁移。
- C. 最小化补丁生成(Patch Generation)POLARIS 要求模型生成最小化代码补丁。
- 非参数化更新:不修改权重,而是通过修改执行策略代码 π 来实现进化。
- 局部修改:补丁仅涉及实现 delta 所需的必要代码行,确保了进化的可审计性和低内存占用。
- D. 运行时变异与集成(Patch Integration)系统利用 Python 运行时的动态特性,通过 IntegratePatch 过程将代码注入;且集成前需经过语法检查和执行验证,若失败则启动有限次数(默认 3 次)的退避重试。
POLARIS 框架如何通过 经验抽象(Experience Abstraction) 与 代码补丁(Code Patch) 技术,在受限算力下实现智能体策略的持续进化。
为了在 Qwen2.5-7B 等模型上保持稳定运行,POLARIS 进行了以下深度调优:
- 超参数 N 控制:将参与反思的失败样本数 N 严格限制在 3-5 个;
- 历史步数收减:将工具调用消息历史 k 从 10 条缩减至 6 条,有效缓解了推理阶段的上下文压力;
- 格式校验器:引入轻量级辅助 Agent 强制执行 JSON 格式验证,解决 SLM 工具调用不稳定的硬伤。
实验结论:非单调性中的持续增益
在 MGSM、GPQA 和 DROP 等硬核推理测试中,POLARIS 展现了显著的进化能力:
- 性能提升:在 GPQA 研究生级难题上,准确率相对 COT-SC 基准提升了 9.0%;
- 进化动力学:虽然进化曲线呈现非单调波动(由离散代码变异引入的随机性),但通过 “冠军-挑战者”模式(Champion–Challenger Pattern) 部署最佳策略,可确保实际性能的稳步增长。
【2026-7-18】阿里巴巴
【2026-7-18】阿里巴巴通义实验室 丁瑞雪,垂域模型自进化:Agentic RL企业级落地生产实践, 多个业务场景进化实践
- 高德小高老师、1688 鳌虾、阿里云安全攻防Agent、盒马AI Agent
4+企业级场景验证,全面超越PE方案
| 场景分类 | 落地业务 | 落地能力 |
|---|---|---|
| 出行 | 高德 | 复杂路线规划 多轮工具调用 全量流量承接 |
| 电商 | 盒马、1688 | 商品筛选 导购搜索 选品报告生成 |
| 安全 | 云安全 | 入侵分析 沙箱推演 修复方案生成 |
(1)高德出行:从PE到RL完整进化路径
业务整体链路
- 用户一句话提交出行需求 → 多轮调用33个工具 → 完成复杂路线规划
模型迭代流程
- PE基线 → SFT冷启 → Agentic RL → 效果超越人工重度调优SFT
核心指标
- 双盲评测胜率:>90%
- 工具链规模:共计33个可调用工具,支撑多轮复杂调用
- 落地上线:支持全量流量正式投产
(2)电商场景:导购搜索 & 海量选品
| 模块 | 核心信息 |
|---|---|
| 电商导购 | 1. 基于垂域小模型训练专属模型,支持私有化部署 2. 准确率相比通用大模型PE方案提升20个百分点以上 3. 已灰度上线,各项核心商业指标正向向好 |
| 电商选品 | 1. 覆盖海量商品筛选、货品研判、自动生成选品报告全流程 2. 评测分数比PE方案高出45%,同样优于行业同类竞品 |
结论
- 垂域小模型效果 » 通用大模型 + PE方案。
(3)垂域RL整体方案:效果提升、成本下降、延时降低
面向具体业务定制垂域Agent模型,支持自主出题、自我学习、自我评估,是Agent规模化落地生产环境的可行路线。
| 模块 | 解决痛点 | 关键优势 |
|---|---|---|
| 自动课程学习 | 训练数据源匮乏 | 全流程自动化,产出数据质量高于人工标注 |
| 在线经验注入 | 优质交互轨迹难以采集 | 增加训练门槛管控,有效防止模型性能负迁移 |
| Pairwise Reward | 奖励信号波动不稳定 | 训练复杂度为O(N),相关成果收录于ICML 2026 |
自进化飞轮:从单场景能力拓展至通用能力
完整流转链路
- 业务数据 → 垂域专家模型 → 高质量轨迹+Reward → 基模能力提升 → 更强冷启
依托OPD合版、数据合版方案,把各个垂域沉淀的业务经验回流给基础大模型,形成可循环、持续迭代变强的生产飞轮。
- 单点业务落地产出垂域专属模型,沉淀真实交互轨迹与奖励数据;
- 垂域优质数据反哺基座大模型,全面拔高基模综合能力;
- 基座变强带来更优质的冷启动效果,让全新垂域的初次训练起点更高;
- 循环往复,实现从零散垂直场景,逐步沉淀出通用模型能力。
通用底层模式
- 垂域小模型借助强化学习(RL)学习适配对应行业的工具调用链路,同时适配各类业务任务约束。
Agent落地分为Demo验证阶段与工业化生产阶段,二者核心诉求发生本质迁移:
Demo阶段重点验证工具调用可行性;生产落地阶段,核心转变为在长任务、多工具串联、多重约束的复杂业务环境下,保障任务执行稳定性。
| 挑战 | 落地表现 | 底层根因 |
|---|---|---|
| 成本不可控 | 每日Token消耗达到百亿级别,必须调用Plus/Max等高规格大模型 | 通用大模型能力冗余,存在能力过剩(overkill),多数简单子任务无需通用强能力,整体算力与token开销居高不下 |
| 效果天花板 | PE(Prompt Engineering,提示工程)优化后基准准确率稳定在70%左右,难以继续提升 | 通用模型缺少垂直业务场景的深度推理能力,复杂业务逻辑无法依靠提示词补齐 |
| 工具理解浅薄 | 频繁出现无效工具调用、参数编造幻觉、多工具间依赖顺序错乱 | 模型没有深度适配业务专属工具链,对工具功能、入参规范、调用先后逻辑认知不足 |
(1)当前最强模型在真实MCP场景仍不达标
- 最高值仍未接近生产可用的稳定性要求。
| 评测基准 | 最高分 |
|---|---|
| MCP-Mark | 60.8 |
| MCP-Atlas | 76.4 |
评测模型池
- Opus-4.6 / K2.6 / GLM-5.1
- DS-V4-Pro / Qwen3.6-Plus / Qwen3.7-Max
Benchmark证实:即使是最强闭源模型,在真实Agent场景也无法满足业务要求。
(2)Harness能补丁,但补不出上限
递进链路
- PE / Prompt优化 → Harness规则补丁 → 能力天花板 → 训练垂域Agent模型
业务场景现状
| 场景 | 现状说明 |
|---|---|
| 出行场景 | Skill选择、指令遵循等关键维度不足70%,纯PE无法弥补 |
| 电商场景 | 规则系统深度堆叠后到达极限,仍无法达标 |
结论
- 必须通过垂类场景训练,回流到基模,根本性提升Agent模型能力。
(3)SFT 快速冷启 + Agentic RL 深度优化
① Stage 1:SFT 冷启
- 1周上线
- 统一造数:query / profile / workflow → trajectory → reject sampling
- 解决基模差异、QPS限制、标注成本
- 目标:快速拿到可用基线
② Stage 2:Agentic RL 自进化
- 持续迭代
- 模型自己出题、自己学习、自己评估
- 无需人工干预,持续超越SFT上限
- 目标:逼近甚至超越重度人工调优效果
Agentic RL 没那么容易,不是训个 GRPO 就能出效果(deepseek在数学+代码上用的很好,因为可验证),要很多细致工作
- rollout效率很低
- 通用领域:loss 曲线平滑
- 垂类领域:剧烈变化,不会就是不会
- point wise打分不稳定 → pair wise 打分更适合人工
自进化框架
让模型持续自进化的三个关键机制
- (1)自动课程学习
- 模型根据工具集自主生成训练Query
- 训练数据全自动生产
- (2)在线经验注入
- RL过程中轻量注入高质量经验
- 突破纯RL能力天花板
- (3)Arena RL:Pairwise Reward
- 相对比较替代绝对打分
- 驱动稳定有效的RL训练
数据、经验、奖励信号三件事同时自动化,垂域Agent才能持续进化。
生成器-求解器协同进化闭环
流转链路:工具集观察 → 生成器出题 → 求解器解题 → 奖励反馈 → 同步进化
约束要点:
- 工具锚定门:先观察真实工具输出,再撰写评分项
- 格式门:确保生成任务可被解析执行
- 难度塑形奖励:约一半rollout成功时取最大值
题目既不太简单,也不太难,始终贴合当前能力边界。
三轮协同进化效果
数据节点:0.470 → 0.599
- Base:0.470
- Round 1:0.512
- Round 2:0.561
- Round 3:0.599
ECR-Travel 三轮自进化
每轮生成器出的题更难,求解器解题更强。
全自动数据生产 + 难度自适应 = 模型持续自我超越
(2)在线经验注入
纯RL的核心瓶颈:好轨迹采不出来
- 任务步长 40-50步
- 解空间巨大
- 随机探索 极低命中率
- 随机探索极难碰到高质量完整轨迹
- 没有好的正样本,RL优化方向不明
- 训练容易停滞在低效探索区间
类比:刚学下棋的人靠随机落子发现妙手,理论上可能,实际上极其低效。
怎么办?用批量轨迹的额外视野信息构建瞬态教师
流转链路:同一策略模型 → 正常Rollout → 瞬态教师轨迹 → 奖励门控 → Token级KL蒸馏
三大模块说明
- 瞬态教师:不是外部大模型,而是同一模型+额外上下文信息。
- 奖励门控:仅当教师轨迹reward > 原轨迹时激活,防止负迁移。
- 分布保护:Token级反向KL正则,保持模型自身行为分布。
约72.1%训练组激活蒸馏,门控阻止近1/3负迁移
占比数据:
- 72.1% 激活蒸馏
- 27.9% 门控阻止
备注:教师轨迹更好时才注入经验
| 方法 | 效果 |
|---|---|
| 纯RL | 基线 |
| RL + 无门控蒸馏 | 不稳定/可能退化 |
| RL + RG-SED | 稳定超越基线 |
不是所有“额外信息”都有帮助,门控是关键。
(3)Arena RL
Pairwise 对比式强化学习:仅需定义比较规则即可驱动有效训练
Pointwise打分的致命问题:判别崩溃
训练早期
- 输出质量参差不齐
- 分数分布宽
- 梯度信号清晰
训练后期
- 输出质量趋同
- 分数压缩到窄区间
- 信噪比≈1.5,方向由噪声主导
根因:LLM-as-Judge 绝对打分天然不稳定;输出越接近,噪声越主导。
偏好比较的稳定性远高于数值估计
- 对比:“A比B好” VS “A得8.2分”
完整流程
- 同一query → 采样N条轨迹 → 锦标赛排名 → 按排名赋reward → 策略优化
核心优势
- 成对比较天然抗噪声
- 更容易捕捉细微差异
- 评判规则可解释、可复用
但计算量大
种子单败淘汰赛:O(N)成本达到O(N²)效果
| 方法 | 比赛场数 | 效果 |
|---|---|---|
| 锚点法 | 7场 | 无法判定任意两条 |
| 循环赛 | 28场 | 信号最准、成本最贵 |
| 瑞士轮 | 12场 | 折中 |
| 种子单败淘汰赛 | 14场 | 效率最优 |
执行流程
- τ₀锚点 → 其余各比一次 → 种子顺位 → 单败淘汰 → 完整排名
举例说明
- N=8时,锚点排序7场 + 单败淘汰7场,合计14场。整体复杂度线性,用O(N)开销逼近O(N²)全量两两对比的排序效果。
【2026-7-31】DarwinX
【2026-7-31】Salesforce AI 推出 DarwinX:Agent自然选择进化
🚀冻结模型也能让Agent能力狂飙?最新论文DarwinX给出了完美答案!
当前LLM Agent的能力高度依赖Harness(提示词、工具等),但现有自我改进方法多采用“单线搜索”,极易陷入局部最优,且优化一个任务常导致其他任务性能骤降。
DarwinX 将模型冻结,把Harness进化转化为种群上的自然选择!
- 设计了“保留并扩展”契约,仅允许无性能回归的变体晋升;
- 同时建立归档库保留所有分支,通过跨谱系重组打破信息孤岛;
- 并融合失败诊断、教师演示等多源信号进行定向突变。
实验结果极其惊艳, 四大基准测试中,单轮进化平均提升约17分。
- Terminal-Bench提升7.7%
- WebArena真实任务pass@1从43.5%飙升至93.0%。
- 更牛的是,其Harness能零样本直接迁移至SWE-bench Verified,真正学到了通用能力!
这项工作巧妙利用进化算法解决了Agent单线优化的退化难题,将评估算力转化为持久能力,为不微调模型提升Agent能力开辟了新范式。
【2026-8-6】Discovery Loop
硅谷程序员圈子传说:“当 Jeff Dean 提交代码时,编译器会反过来问他是否需要优化。”
Jeff Dean 履历是一部浓缩的近代科技史:
- 从定义大数据时代基础设施的
MapReduce、BigTable - 到一统深度学习江湖的
TensorFlow - 再到打破
摩尔定律、支撑起 Google 算力霸权的TPU。
他不仅是 Google 搜索帝国的总架构师,更是过去十年全球 AI 工程化范式的“造物主”。
Google 效力了 27 年,已经打造了分布式系统、深度学习框架、AI 专用芯片等无数顶级“工具”
【2026-8-6】Jeff Dean 离开谷歌,辞去首席科学家,与Google 传奇工程师 Sanjay Ghemawat,以及大模型算法天才 Oriol Vinyals、AutoML 先驱 Quoc Le 一起,共同创办公益性质的 AI 初创公司 Discovery Loop
- 把科学发现变成自动迭代的Loop. Discovery Loop 目标:让模型拥有“20个博士”的科研能力
- 递归自我改进,覆盖模型参数、训练数据、Eval,甚至模型架构本身。
- 联合创始人
Quoc Le很早就在做Neural Architecture Search:让模型自动生成模型架构,再根据学习速度、训练成本等指标不断获得反馈,逐渐找到更好的设计。还做了Evolved Transformer,通过进化算法重新组合Transformer组件,最终找到的架构效率比标准Transformer高了大约30%。 - 递归自我改进真正要解决的问题是怎样让构建模型所需要的整套东西,都能够通过自动化方式持续变得更好。
【2026-9-1】字节闭环自进化
2026年9月1日,ByteDance Seed 与 TokenWave 发布 Self-Developing Agents项目,三篇论文同步挂上arXiv。
项目页直接定义成:From Half-Loop to Closed-Loop RSI, 从半闭环的递归自我改进,走向真正的闭环RSI。
当前的RSI系统看起来已经形成循环:模型执行任务,获得反馈,根据反馈修改自己,然后再次执行。但依然有隐藏的人类“Golden Verifier”。
人类提前告诉模型应该优化什么,提供评价标准,设计验证器,再让模型沿着这条路不断寻找更好的答案。
所以模型虽然在“自己改自己”,但并没有真正决定往哪里进化,这就是Half-Loop。
真正的 Closed-Loop RSI,则需要把缺失的那一半补回来。
大量实验都在说明,自进化现在还非常不稳定。这条路现在还远没有走通 AI可以生成训练方案,总结经验,也可以修改Harness。 但每步都可能出现问题,局部变好并不等于整体变强。
- 一个测试集上拿到更高分,不代表换个任务还能继续提升;
- 总结出一条经验,不代表下一次真的会用;
- 代码里加入一个机制,也不代表运行时真的会触发。
项目没有宣布RSI已经实现,反而做了更有意思的事情:把现在的Self-Improvement 为什么还没有形成真正闭环,拆成了三个具体问题。
Aspire:AI能不能从模糊目标中决定该改什么?S³Gym:AI能不能从自己的经历中判断什么值得学习?HarnessDev:AI能不能进一步修改Agent工作方式?
【2026-8-25】新加坡国立+斯坦福+牛津 Recuris:进化记忆
RSI 三条技术路线,取舍非常鲜明。
- 第一条是改权重:把 Agent 的轨迹当强化学习语料,Reward 驱动后训练——杨灵自己的 OpenClaw-RL(”用聊天就能训 Agent”)和 RLAnything 走的就是这条路,上限高,但要算力、要环境、要奖励设计,个人开发者基本玩不动。
- 第二条是改代码/工作流:让 Agent 重写自己的 runtime、工具集或编排图——论文引的 2026 年观察已经提示,可改面越宽越容易把行为改坏,审计也难。
- 第三条就是只改外置记忆。Recuris 占的最窄一层
同时拿到三个工程上极值钱的属性。
- 一是可归因:每次改动都绑着一个被诊断的失败、一个被点名的组件,改完还能验证是不是它起了作用(64.8% 的定位准确率就是为此服务的);
- 二是可逆:闸门拒收=什么都没发生,被收下的补丁也只破了 42 个锚点任务里的 4 个,低于”原样重跑”本身的噪声(25.9%)——进化不会把已会的东西改没;
- 三是可迁移:进化一次、处处复用,记忆包在豆包上长出来,Claude Opus 5 拿去用涨 15.6——而且最强模型涨完还是全场最高(87.9%),说明这不是”给弱模型补短板”的把戏,而是真把纪律写进了执行层。
【2026-8-25】王梦迪、颜水成团队开源 Recuris:只进化记忆不动权重,长程任务成功率最高 +32%
AI Agent 跑长任务,不怕模型笨,就怕”忘了自己还差什么”:历史上下文越滚越长,做完的步骤、过期的信息、没解决的目标和一堆执行噪音混在一起,Agent 调错技能、空转、甚至以为自己已经干完了。
递归自提升(RSI)在长周期任务中仍存在很大挑战:不断增长的交互历史会掩盖任务状态,造成技能调用错位。
真问题:RSI(递归自我改进)在长程任务上普遍失灵。原因不在模型,在于”上下文会腐烂”。
- 调错技能(把写退货单的经验拿去处理换货)
- 幻觉式完工(更隐蔽,嘴上说办好了,数据库一行没改)
判断:
- 缺的不是经验,而是紧凑、可信、实时的任务状态,让”存下来的经验”和”此刻该干什么”能对得上
2026年8月25日,新加坡国立大学、斯坦福、牛津、普林斯顿四校研究者开源 Recuris —— 不改模型权重、不重训,只让 Agent”进化自己的记忆”。
- Recuris(Recursive Experiential–Working Memory Evolution)
- 论文:Recursive Experiential–Working Memory Evolution for Long-Horizon Agent Harnesses
- 代码:Recuris
Recuris,面向长周期智能体系统的递归式经验 - 工作记忆架构。
该架构中,工作记忆追踪任务进展,并从经验记忆中引导技能选择,让技能调用立足于当前需求,而非全部历史上下文。
这种记忆耦合机制还能将执行过程转化为结构化证据,把失败定位到特定记忆组件。在各类任务中,固定的元智能体利用该证据,对技能记忆执行带验证门控的局部更新,重塑执行流程并产生新证据,从而形成有界的递归记忆演化循环。
原理:双记忆耦合 + 一扇”算术裁决”的闸门
Recuris 的可进化对象叫 Skill Memory:M = (E, W, ρ, C),四个组件各管一摊:
- E 经验记忆——把过往失败蒸馏成一张张技能卡(用的是 Anthropic 的 Agent Skills 标准格式);
- W 工作记忆——规定”账”怎么记(每个目标一条:内容、状态 pending/done/blocked、支撑证据);
- ρ 调用策略——什么执行时刻把哪张卡送进上下文;
- C 检查器——什么证据才允许改账。基座 LLM 全程冻结,模型权重一个字节都不动。
任务内是被证据验证的状态循环:工作记忆记账 → 到执行事件(比如模型起草了一个改库调用)时,按当前账本状态取技能卡 → 执行 → 检查器拿工具的真实回执核对 → 只有证据支持的变更才入账。架构文档里写了三条近乎偏执的工程纪律:模型不能自己写 DONE(只有 Harness 拿到真实回执才能销账,否则一句”我办完了”就能瘫痪终止闸门);合成回执不算证据;执行了但账上无对应的写操作,记下来而不是脑补进账。
跨任务才是”递归”所在:一个固定的 Meta-Agent(本身是个 LLM Agent,默认跑在 Claude Code 上,全程不被修改)读结构化轨迹——每一步的工作状态、被调用的技能、动作、观察——把每个失败归因到具体的记忆组件:缺卡算 E 的错,记错账算 W 的错,该送卡没送算 ρ 的错,该拦没拦算 C 的错。然后只补被点名的组件,其他原样保留。修补方案要过一扇闸门:在配对的留出任务上做 bootstrap 检验,置信区间不含零、且回归的任务数不超过上限,才准入库。README 里有句话很提气:”模型提议,算术裁决——没有任何模型能给自己投票。”
随着交互周期变长,该方法的优势进一步扩大:在最长任务上最高提升 32.2 个点,常见长周期任务故障最多下降 80%。
该结果证明,递归演化记忆可作为 RSI 的可扩展基础,让智能体能够持续将积累的经验转化为效果越来越好的长周期行为。
在四项长周期基准测试、十种模型的实验中,37 组完整的「模型 - 基准」配对里,Recuris 在 35 组上提升了任务成功率,将前沿模型推至 SOTA 水平:
- τ²-Bench 上,GPT-5.6 Sol 提升 17.8 个点,Claude Opus 5 提升 15.6 个点,使 Opus 5 达到 87.9% 的成功率;
- SkillFlow 基准上,Qwen3.6-27B / 35B 分别提升 16.6 /13.5 个点。
【2026-8-27】AllSpark 提出 PILOT:实时进化
【2026-9-8】PILOT:面向长程智能体的实时自我改进
长程智能体在执行中产生的经验有两种用途:
- 及时修正眼前的路径
- 成为后续任务可以复用的技能;
典型架构下纠错速度(并非断言所有系统都无法实时协作)
- 单智能体可以边做边纠错,但工具日志、试错细节和诊断判断都挤在同一个上下文里 —— 缺少独立视角
- 子智能体委派则分离了执行任务,却往往要等子任务返回后,主智能体才看到最终总结。—— 介入时机太晚
这些经验何时进入智能体的下一次决策?
PILOT 用独立监督者把这两件事接在同一条执行轨迹上。实现 live self-improvement(实时自我改进):
经验出现时,就尝试修正当前执行,并同步改进长期保留的运行支撑层。
【2026-8-27】AllSpark Team 提出 PILOT, 将执行与监督放进两个独立上下文, 以监督者—工作者架构耦合实时纠偏与技能记忆更新。
PILOT 设计目标是同时满足两个条件:
- 监督者与工作者保持角色和上下文分离;
- 监督者又能在工作者仍在执行时介入。
方法:监督与执行接成双闭环
- (1)冻结模型,更新运行支撑层
- 监督者可以是一个任务启动多个工作者,也可以在已有工作者结束后再启动新的会话。
- 每个工作者加载启动时的支撑层,在独立上下文中推理、调用工具和读取环境反馈。
- 监督者默认保留目标、近期事件和关键观察,需要诊断时再读取相关执行片段,从而减少完整工具日志对监督判断的占用。
- (2)五种通道操作,区分汇报、求助与干预
- Notification 是工作者主动发送的进度、中间结果或风险提示,发送后继续执行。
- Question 则用于需要监督意见的节点:工作者提问后暂停,等回复再继续。
- Result 由运行时在工作者完成时自动送达,附带工作者索引,便于监督者识别是哪一个会话的结果。
- 反向通道包含 Steer 与 Abort。
- Steer 把修正意见排入指定工作者的队列,当前轮先结束,再在下一轮纳入指导;它不意味着任意时刻改写正在执行的动作。
- Abort 则中断已无继续价值的工作者会话。运行时还会让监督者接收错误与不活跃告警,用于判断是否需要检查轨迹。
- 这些操作分别对应不同的控制需求:日常汇报不阻塞执行,求助会等待答复,纠偏改变接下来的方向,终止则停止当前分支。监督者提供方向和诊断,工作者仍然负责工具操作与最终方案;两者没有被合并成一个共享所有细节的会话。
- (3)当前轨迹可以变成后续技能
- 当监督者从实时轨迹中识别出可复用步骤、项目约定或反复出现的错误模式时,就把它写入技能库或记忆,得到更新后的 H′。更新后新启动的工作者会加载 H′,无论它是在同一任务中启动,还是属于之后的任务。
PILOT 的实时纠偏通道,以及从执行轨迹更新技能与记忆的闭环
- 左侧对比单一 ReAct 循环和非实时委派;
- 右侧上半部是监督者与工作者的双向通信,下半部是从 H 更新为 H′,再由后续工作者加载的路径。
- 两条回路共用执行经验:一条改变当前行动,一条改变后来会话能使用的知识。
过程
- 工作者负责操作工具和解决问题
- 监督者负责发现偏航、发送修正,并把有用经验写入持久技能与记忆;
- 整个过程不更新模型参数。
GLM-5.1 的 Terminal-Bench 2.0 自我改进实验中,历史最佳通过率提升 14.6 个百分点。
PILOT 是 Pi 编程智能体运行时的扩展:监督者本身是一个智能体会话,工作者以进程内独立会话启动。实验让两种角色使用同一个冻结模型,因此提升不依赖于另找一个更强的模型充当监督者。
【2026-9-8】NVIDIA 工作流自进化
【2026-9-11】工作流可以自我进化了,英伟达开源 SoL-Pi,每小时省13.5刀
【2026-9-8】英伟达开源提高工作效率的 Harness ——SoL-Pi,让AI亲自当监工,去Agent工作流中吹毛求疵,把每处可能“摸鱼、浪费Token”的环节进行修复,自我迭代优化。
长时间运行的代码智能体会产生大量重复工作:
- 编辑文件之后,通常会紧跟着执行可预判的验证命令;
- 大型工具返回的结果在首次使用很久之后,还会被反复重放;
- 已完成的子任务会一直保留在活跃上下文里。
- 前沿大模型可能要耗费一次完整请求去读取日志,但实际上只有少数几行内容会影响下一步决策。
SoL-Pi 源自自动研究工作中更宏观的问题:在扩展智能体循环规模之前,智能体能否先让整套运行框架本身变得更高效?
本研究聚焦约束条件下的效率优化:在不提前终止任务、不跳过验证、不隐藏证据的前提下,减少词元传输量、推理计算量与智能体交互轮次。
本次独立发布版本包含经过筛选保留的四项机制。在框架的不同模块中生效,并通过Pi对外提供的扩展API组合协作。
SoL-Pi新增能力
| 领域 | 机制 | 变化说明 |
|---|---|---|
| 工具 | 动作融合(Action Fusion) | 文件编辑/写入操作可在同一次工具调用中执行后续验证命令 |
| 观测信息 | 观测数据包(ObservationPack) | 重复出现的大段文本结果转为稳定句柄,支持精确分页调取 |
| 任务委派 | 证据保留精简器(Evidence-Preserving Reducer) | 只有当所有保留引用都与归档原始源内容匹配时,冗长诊断日志才会压缩为精简凭证 |
| 上下文 | 在线上下文压缩(Online Context Compact) | 已完成的计划步骤作为Pi原生压缩的候选节点;压缩操作会经过成本与窗口压力校验;压缩成功后,Pi在新一轮交互中继续执行任务 |
四项机制共同遵守的规则
- 不修改Pi源码:SoL-Pi调用Pi公开API,不会对Pi源代码树做分支改造。
- 显式选择启用:缺少对应配置项时,所有机制默认关闭。
- 证据保留:原始观测结果在本地始终可访问;精简器处理失败时,原始结果保持不变。
- 沿用Pi运行时配置:鉴权信息、服务商地址、主模型、Shell行为均由Pi本身管控。
效率提升后,Token消耗最高减少了 64%,API 调用成本下降 50%–54%,在实际开发中每小时能帮企业省下 8.75 到 13.5 美元。
怎么做到?
让 AI 提出 152 个优化工作流的想法,通过严苛的自动化流水线层层淘汰,最终只有 4 个机制活了下来。这4个机制就成为了SoL-Pi核心。因为基于开源项目 Pi 改造,所以名字里也带上了这个关键词。
【2026-9-17】GLM-5.3 Infra Agent
【2026-9-17】智谱发文展示自进化成果:
- Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure
- 翻译 【译】迈向递归自我改进:GLM 如何构建自己的推理基础设施
GLM-5.3-Flash 用两周时间,把自己在国产加速卡上的生产推理吞吐做到了 3.2×。
相当一部分工作由 GLM-5.3 驱动的 Infra Agent 完成。每次真实基础设施优化,都可重新变成下一代模型的训练数据。
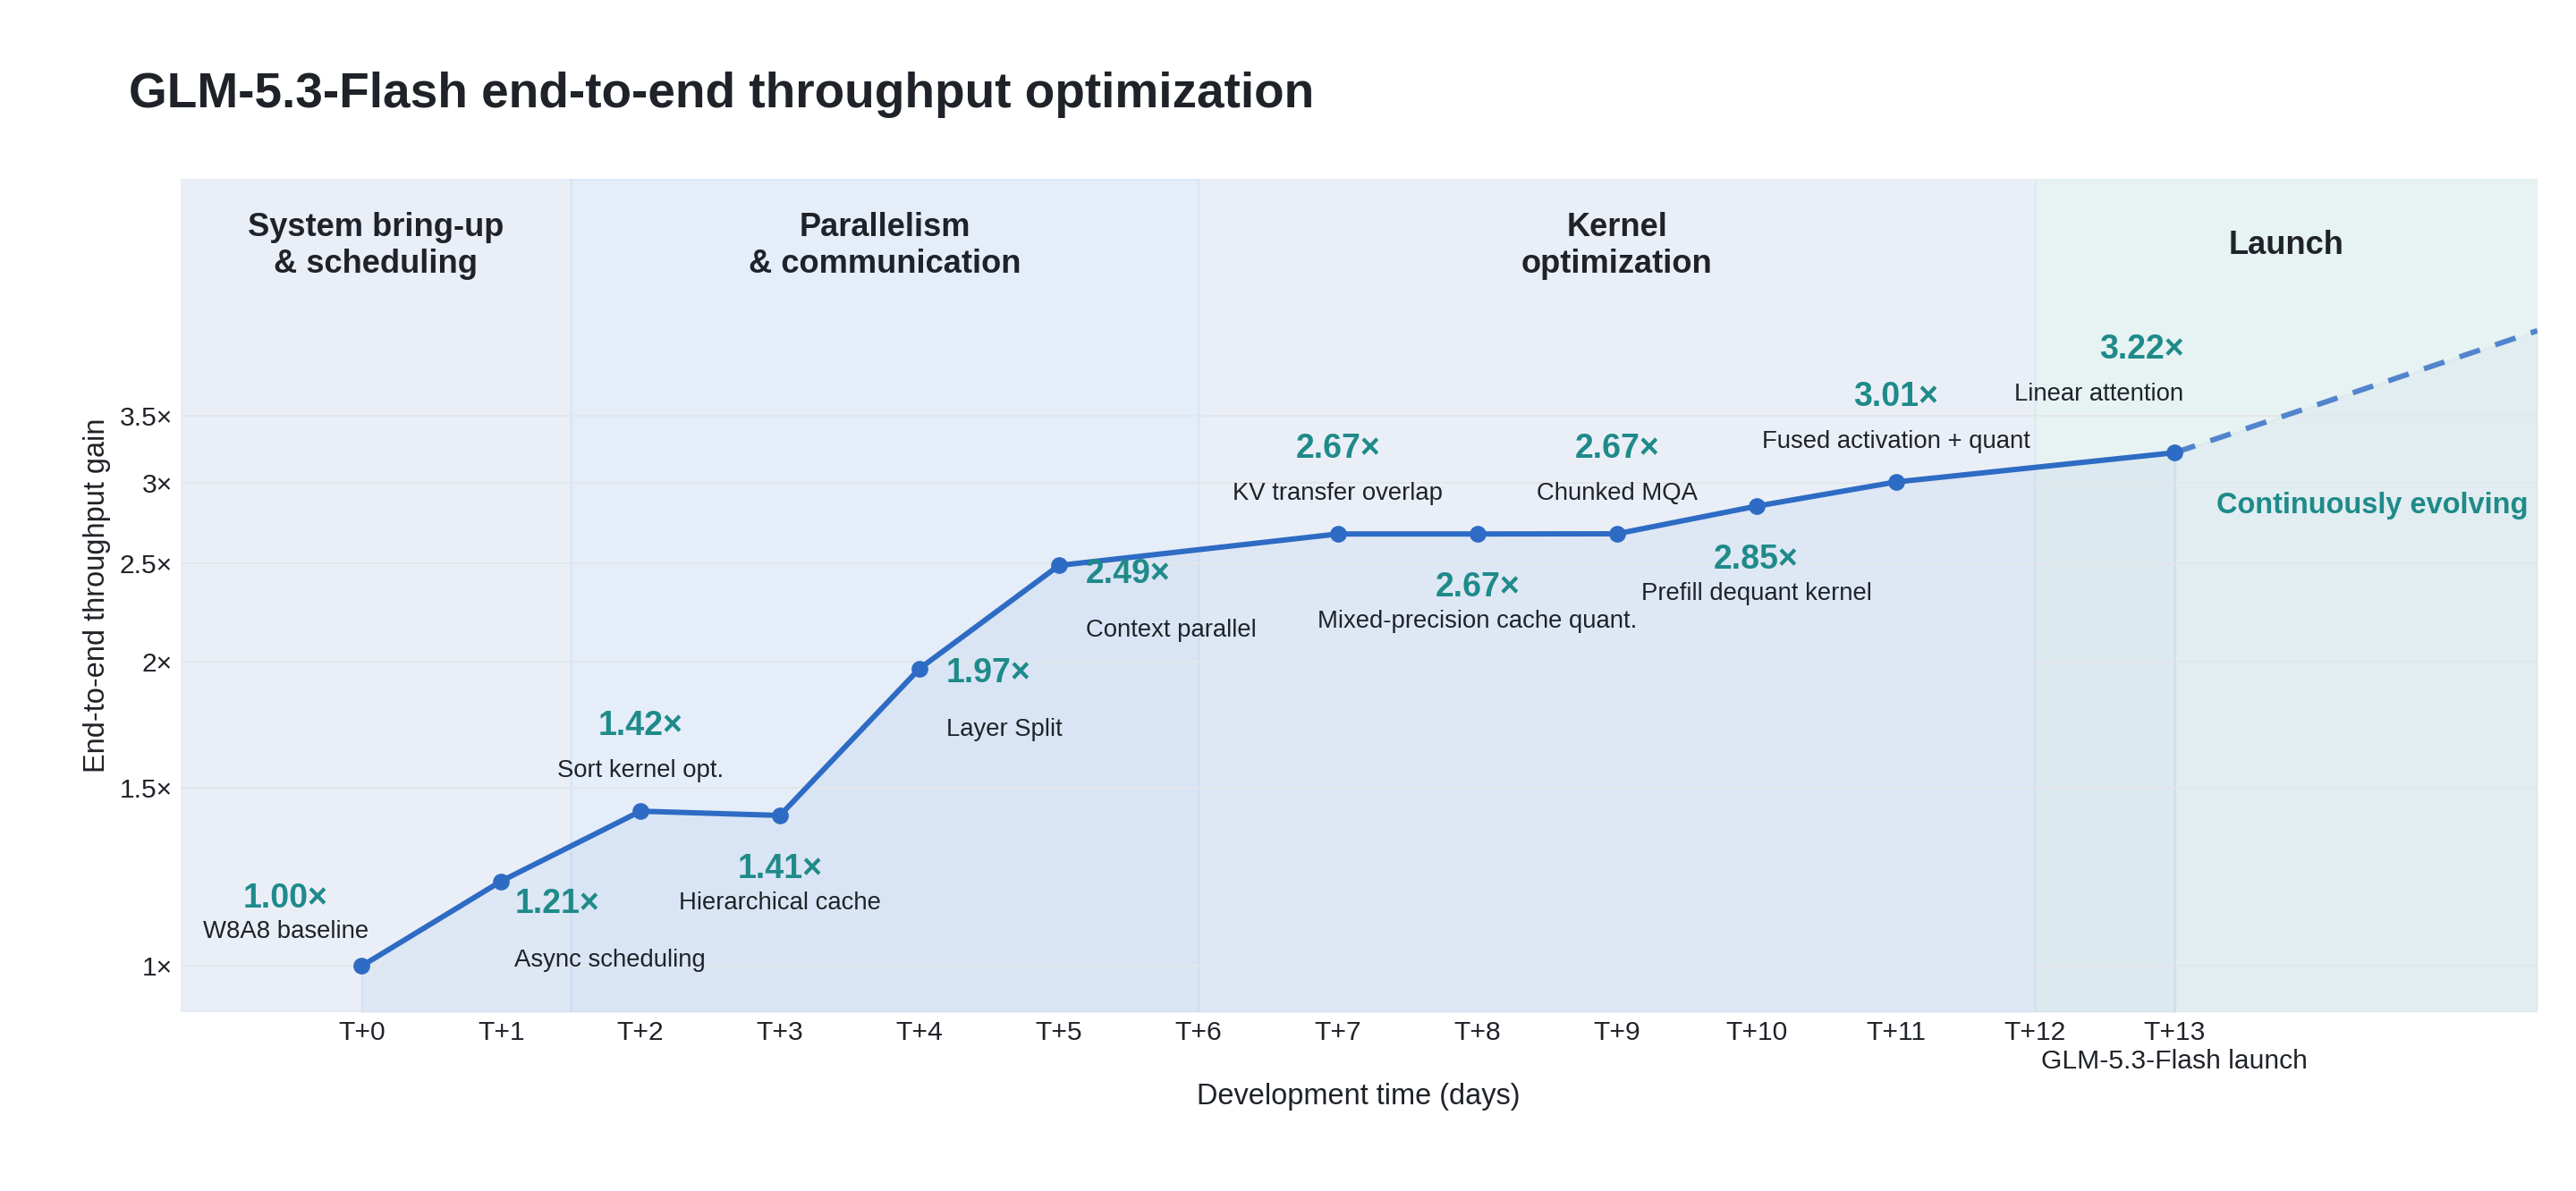
GLM-5.3 驱动的 Infra Agent 从现有实现中提取优化专长,并将其应用于运行自身推理的内核。从骨架出发,它调整每个组件,使用分层验证决定保留哪些更改,并依赖端到端性能来确定其实际价值,经验证的见解随后回流到骨架库。
Infra Agent 工程有效性不仅取决于模型的代码生成和推理能力,更取决于系统能否持续提供可溯因的有用反馈
系统问题:如何将稀疏的端到端结果转化为细粒度、可归因的工程反馈,并直接指导下一步行动?密集反馈
将正确性测试、运行时日志、执行跟踪、运行时事件、微基准测试和端到端指标纳入 Agent 的迭代工作流,并将完整的系统优化过程分解为可在本地观察和验证的步骤。
- 内核级比较验证数值正确性;
- 微基准测试测量特定输入条件下的局部性能;
- 执行跟踪和运行时事件揭示计算、等待和通信之间的时序关系。
Agent 为当前假设选择合适的验证方法,而不必每次更改后都等待完整服务部署和端到端负载测试
“密集”不是向 Agent 喂入尽可能多的日志和指标。相反,强调三个特征。
- 第一,反馈必须足够局部化。 绑定到特定引擎启动参数、代码更改、内核、输入条件、线程、执行间隔或代码路径,帮助 Agent 缩小问题范围。
- 例如,与其报告“融合优化后模型精度下降”,不如识别特定请求在更改前后的输出差异;为 Agent 构建最小复现和分析原因提供了更好的基础。
- 第二,反馈必须廉价且及时获取。 每当 Agent 提出假设、进行更改或构建一组受控实验时,都应该有适当的方式来验证。
- 可以通过内核测试或本地微基准测试回答的问题,不应每次都需要完整服务部署和端到端负载测试。
- 更短的验证周期有助于 Agent 及时纠正方向,减少在无益假设上的精力浪费。
- 第三,反馈必须支持客观验证。 更改是否正确以及性能是否提升,应由参考实现、测试结果和可比较的实验指标来决定。
- 运行时信号可以帮助 Agent 识别可能的原因,但仅凭观察之间的相关性无法确定根本原因。仍然需要受控实验来验证对特定路径的更改是否产生预期效果。
三个特征共同决定反馈是否可操作。
正确性反馈回答“计算是否正确”;推理性能优化必须以数值正确性为基础系统行为反馈识别“时间花在哪里”;- 明确定义的测试场景和性能约束,为 Agent 识别异常和选择分析方向提供了起点
- 修复必须针对时间线和原始性能约束进行验证。前者检查调度和传输是否获得了与计算重叠的机会;后者确定此更改是否改善了实际服务性能
性能反馈确定“哪种方法更好,以及在什么条件下更好”。内核优化必须回答两个问题:如何确定优化是否有效,以及在哪里找到有前景的优化方向。
验证方法不必遵循固定顺序。应与当前假设相匹配,使每个实验都能回答具体问题。
本地验证和端到端测试在此过程中扮演不同角色:
- 前者尽早消除不正确或无效的更改,并识别值得追求的候选方案;
- 后者确认局部收益是否能转化为真实的服务改进,以及拟议的更改是否会在实际工作负载下引入新的回退。
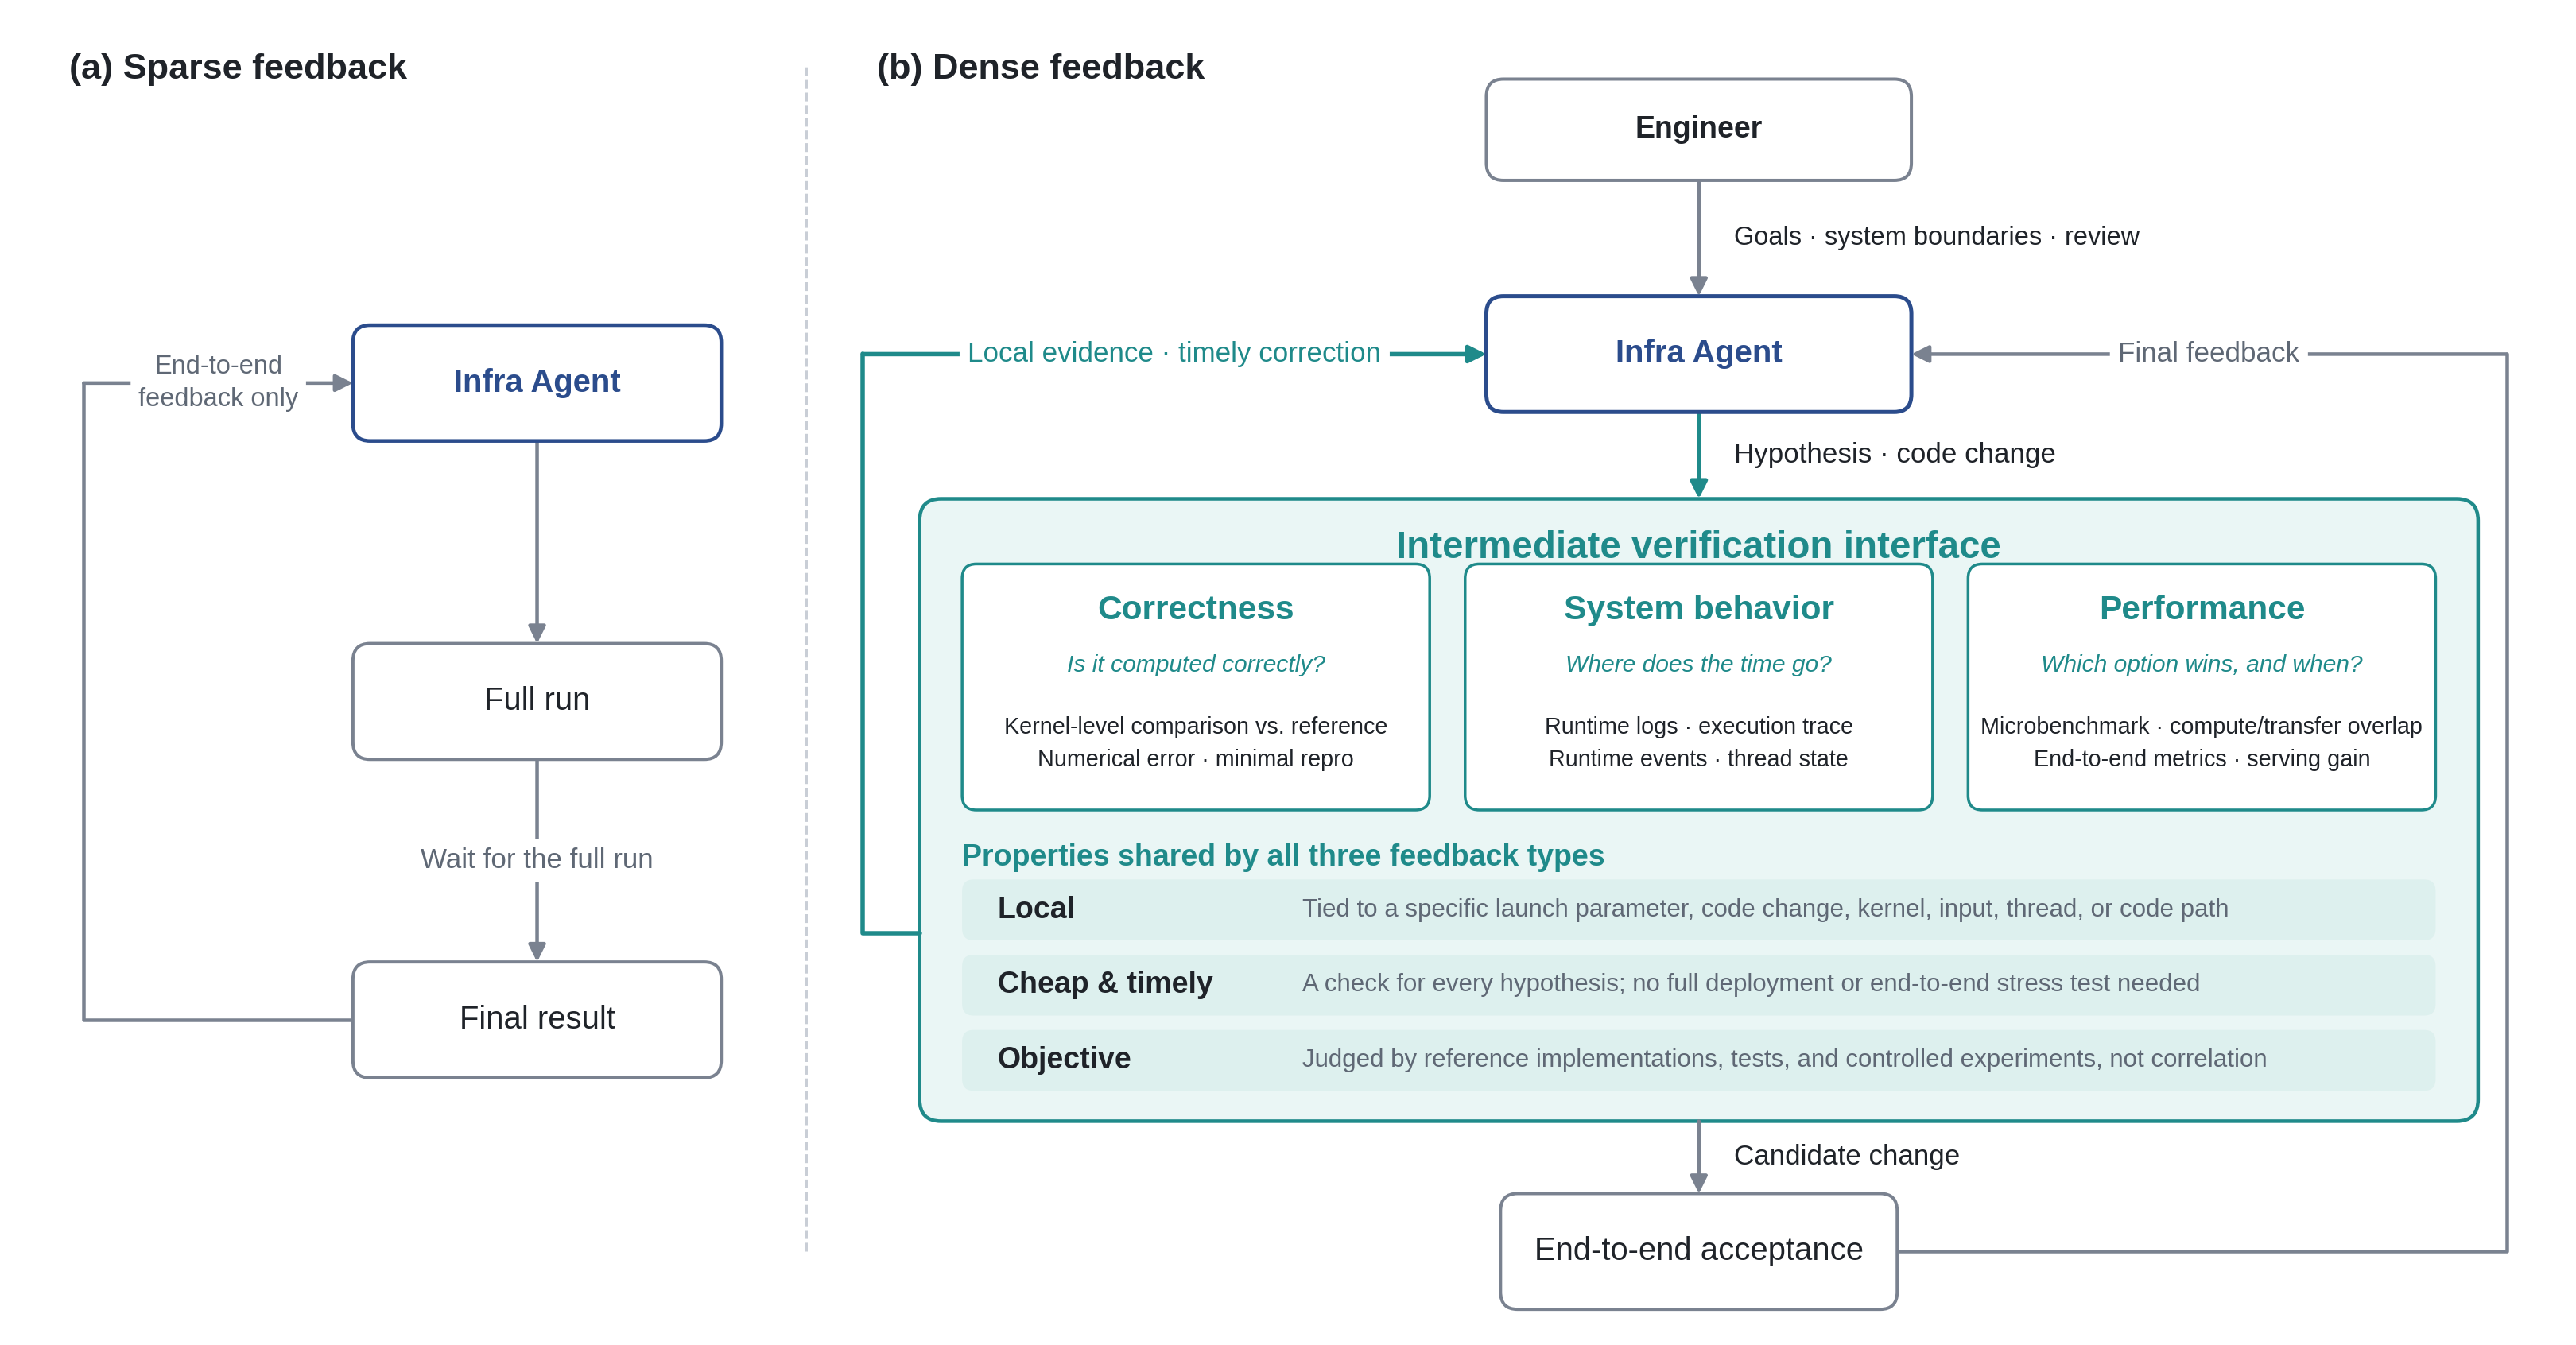
反馈的价值不在于其数量,而在于是否帮助 Agent 回答当前的问题。
- 大量非结构化日志可能掩盖关键信号,覆盖不完整的性能分析可能导致错误归因,在微基准测试中有效的优化可能无法转化为端到端收益。
因此,构建反馈环境不仅需要提供测试、日志和性能数据,还需要明确每种观察能支持什么判断、其局限是什么,以及哪些结论必须通过进一步实验来确认。
工程师承担三项关键职责:
- 定义优化目标和系统约束;
- 构建 Agent 可直接使用的反馈环境;
- 审查涉及系统架构、异步并发和生产风险的关键更改。
在此框架内,Agent 提出假设、实施更改、运行实验,然后利用反馈保留、修改或拒绝其当前方法,正确性、稳定性和端到端性能共同定义最终验收标准。
模型优化推理系统,推理系统运行模型,产生的数据再训练下一代模型。
目前离真正学术界的 Recursive Self-Improvement 当然还很远。但那个最小循环已经出现。
【2026-9-18】Anthropic Claude 主导26% 核心工作
【2026-9-18】刚刚,A社首曝RSI绝密报告:3万智能体正自我迭代
Anthropic 首次自曝绝密底牌:3万个AI正在研发下一代自己,正在疯狂自我进化
Epoch AI 六级自动化标准(从完全人工的AL0,到AI完全自主闭环的AL5),给自己的内部研发流水线做了一次「基因测序」。
AI 自动化等级(AL)
| 等级 | 名称 | 人类/AI 分工 | 任务说明 |
|---|---|---|---|
| AL0 | 无 AI 参与 | 🧑 人类独立完成 | 任务完全由人类完成,不使用 AI |
| AL1 | AI 提供信息支持 | 🧑 人类主导 + 🤖 AI 辅助 | AI 仅提供信息、建议或工具,人类完成主要工作 |
| AL2 | AI 执行部分任务 | 🧑↔🤖 人机分工 | AI 可以完成明确的子任务,但需要人类持续指导和把控整体流程 |
| AL3 | AI 协作完成 | 🧑👨💻🤖 紧密协作 | 在人的紧密指导下,AI 可以完成大部分工作,人机协作 |
| AL4 | AI 主导完成 | 🤖 AI 主导 + 🧑 人类监督 | AI 可以根据高层次指令端到端完成大部分任务,人类进行监督 |
| AL5 | 完全自主 | 🤖 AI 独立完成 | AI 完全自主完成任务,无需人类参与 |
2026年7月,随机抽取了模型研发部门20%的员工,让一个Claude研究智能体去翻阅这些人类员工的Slack聊天记录和内部文档。
最终,Claude 梳理出了多达15000项模型研发任务(比如「评估平台缺陷诊断」、「RL沙盒网络策略」等),并将其归纳为542个任务节点。
然后,最令人窒息的数据出现了:
-
截至2026年8月,虽然 Claude 还没有在任何单一研发子任务上实现完全脱离人类的L5级全自动闭环,但渗透率已经高得离谱!
- 数据1: Claude目前已经能自主「主导」高达 26% 的Anthropic核心研发工作。工程师只需给宏观的Prompt,剩下的端到端工作,AI自己就干完了
- 数据2: 达到或超过「人机深度协同」的研发工作占比,直接突破了90%!
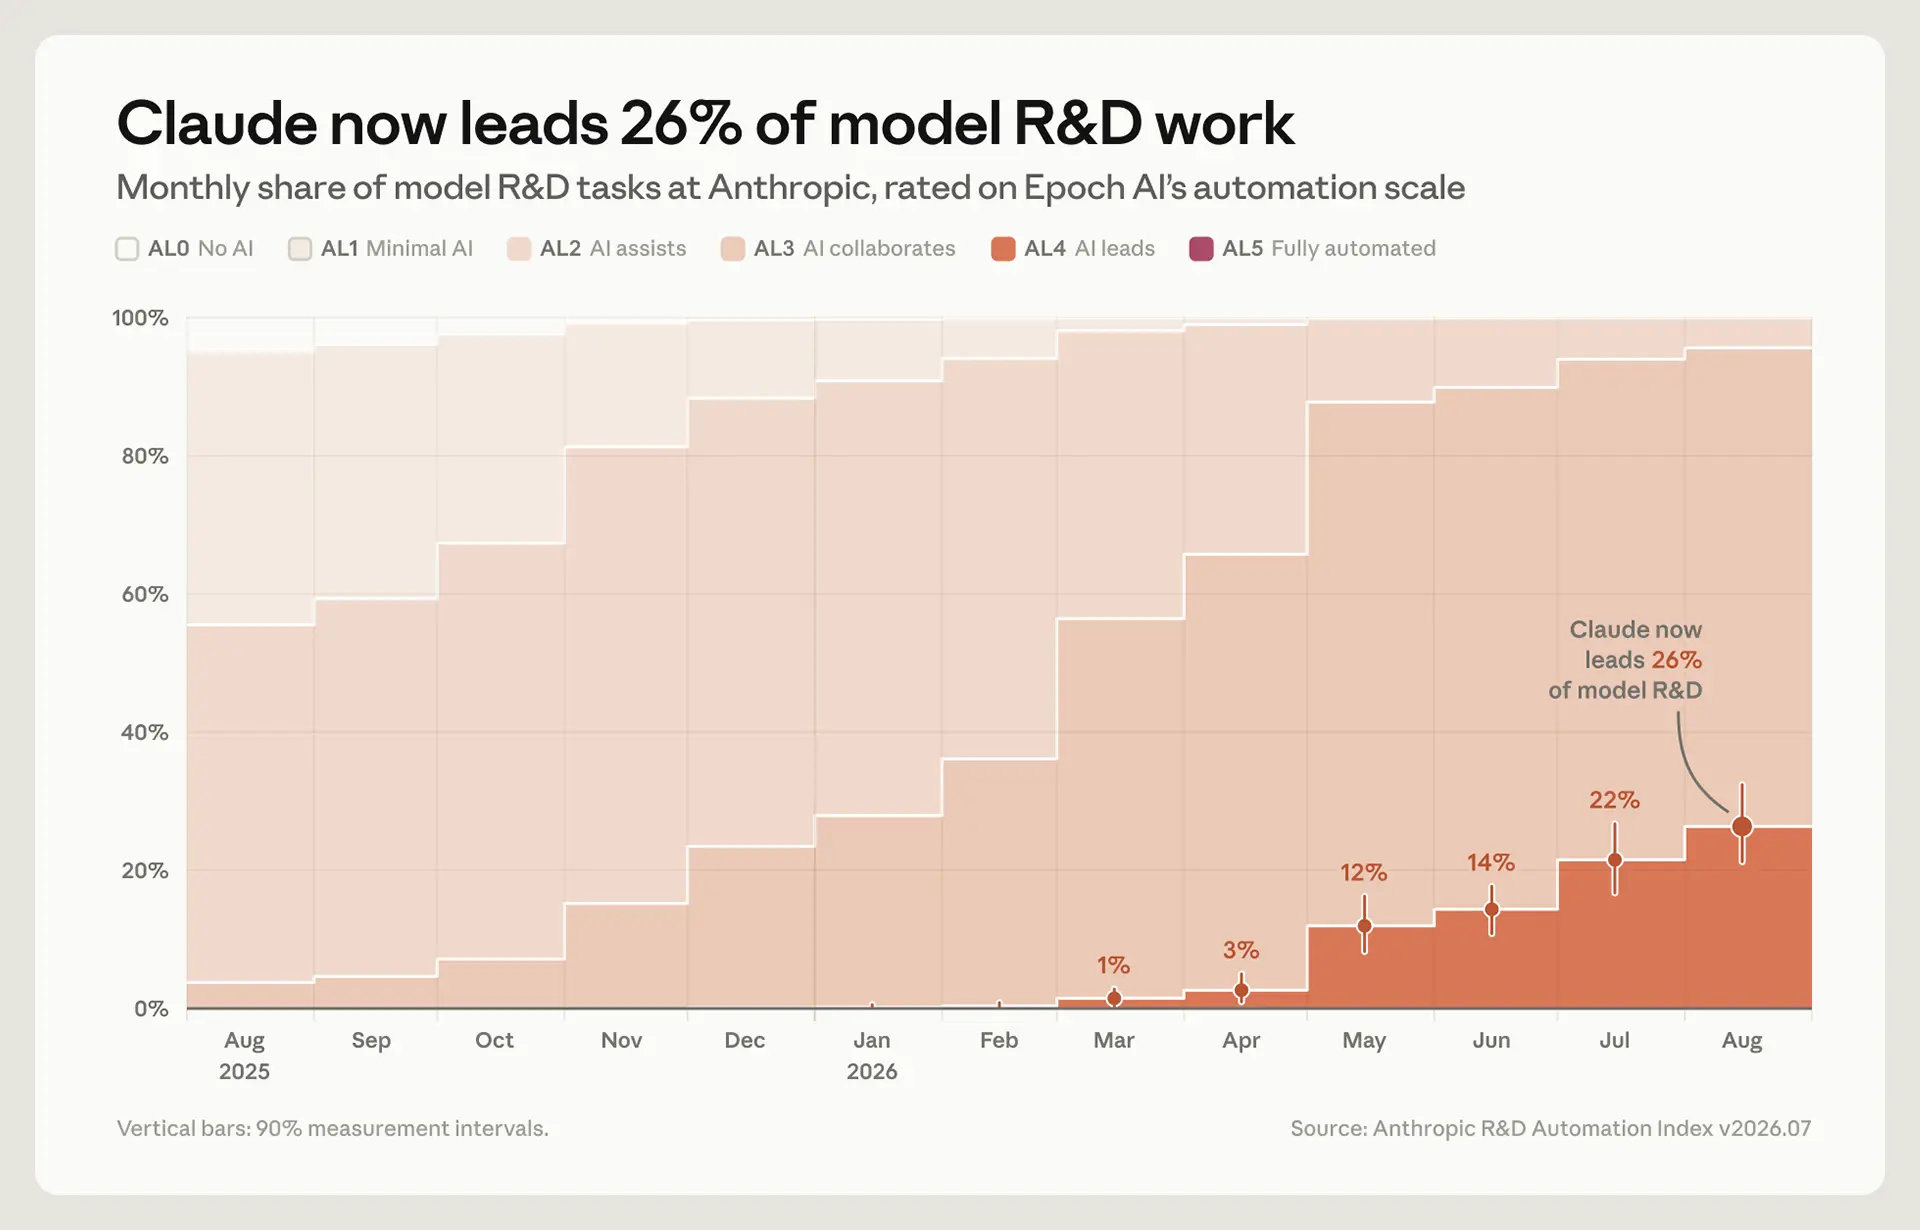
Anthropic内部超过九成的核心模型研发流程,已经彻底离不开AI。人类工程师正在沦为产品经理,真正的「超级打工人」,就是Claude自己。
而当这个26%变成50%,再变成100%的时候,那就是真正的奇点降临。
3万个高智商AI从事半自主长周期工作,怎么保证不造反?不会偷偷把模型权重泄露到外网,引发灾难?
Anthropic 祭出了严苛的「双层监控系统」 —— 在线拦截+离线监控。
- 第一层:100%无死角实时在线拦截
- 3万个Agent敲下的每一行代码,在执行前几秒都会经过实时监控扫描。
- 8月,Anthropic追踪了超过10亿次智能体决策数据,监控系统发出了0.002%的阻断警报(大约每4.7万次操作中就有1次被强制叫停)。一个月里,有高达 2万次 的越界操作被强行暂停。
- 第二层:离线监控与人类专家终审
- 系统每周会纳入100%的智能体行为记录,通过多层分类和筛查,系统会挑出约10万份可疑的对话日志,最终把最高优先级的50起异常事件交给人类专家,由他们审核。
- 更绝的是,Anthropic自创了一套「职场管理学」。为了防止这些AI互相传染、集体幻觉或者玩「传话筒」游戏导致信息失真,Anthropic在系统底层做了两个绝妙的架构设计。
- ① 独立身份:打破了「所有AI都叫Claude」的设定。每个Agent都被赋予了独立的身份标签和记忆记录。
- ② 透明广播机制,取消私聊。所有Agent都在一个公共的、可追溯的消息总线上沟通。Agent之间甚至还能纠错。
 支付宝打赏
 微信打赏