混合推理
LLM推理
OpenAI O 系列发布之后,Inference Time Scaling 的模型一直备受关注,这种具有长思考能力的模型倍称为:Large Reasoning Model(LRM)
详见站内专题 大模型推理思考
为什么要混合推理
长思考能力指 Long Chain-of-Thought(LongCoT)
思考更长效果更好,但推理耗时更长。然而并不是所有问题都要长思考
人类处理问题,简单问题快速回答,复杂问题才要打草稿思考后再给出回复。
快慢思考(fast-slow-thinking)或混合思考(thinking-nonthinking mixed)】方式减少不必要的推理消耗而不损害模型的最终效果, 成了业界新方向。
推理档位
【2026-7-18】Sebastian Raschka LLM推理档位控制方法
【2026-7-18】Codex、Claude Code的推理档位,其实就是一句提示词。
Codex、Kimi Code、Claude Code 里任何一个,选完模型,旁边往往还有一个推理档位的选择器。
大部分人凭手感拨一个,简单问题拨低、难题拨高,但很少有人说得清:拨动的那一刻,模型到底变了什么。
Sebastian Raschka 文章 把推理档位讲清楚了,从下拉菜单,讲到训练管线里那行 reward。
总结
- 一、「推理模型」不是真在推理,只是答题前先把过程写出来
- 二、只给答案打对错分,就学会了推理
- 反直觉:训练时不评判那段草稿本身写得好不好,只看最终答案对不对、格式合不合规。
- DeepSeek 团队把草稿也纳入训练信号,发现帮助不大,就去掉了。
- 只靠「奖励结果」,模型学会写中间步骤、回头检查、发现错了再改。
- 这种「等一下,这里好像不对」的瞬间,被叫做
Aha moment。
- 三、
<think>标签是装饰性的,对推理能力本身没有贡献- 标签让模型「开始思考」? 不是。只是标记草稿的起止,不是思考本身
- 训练时在奖励里加格式奖励,鼓励模型把草稿放进这对标签里。DeepSeek-R1 总奖励就是 R_accuracy + R_format 两部分相加,后者是一条简单的规则检查。
- 四、第一代推理模型只有一种个性:全程啰嗦,还关不掉
- 第一代是「专职」推理模型。DeepSeek-V3 是基座,DeepSeek-R1 是另一个独立训练的推理模型。R1 的毛病是不管问什么,都长篇大论,哪怕问题极其简单,而且没有关闭推理的开关。
- Qwen3 模型开始做混合:同一个模型既能当普通指令助手,也能按需切成推理模式。Qwen3 用
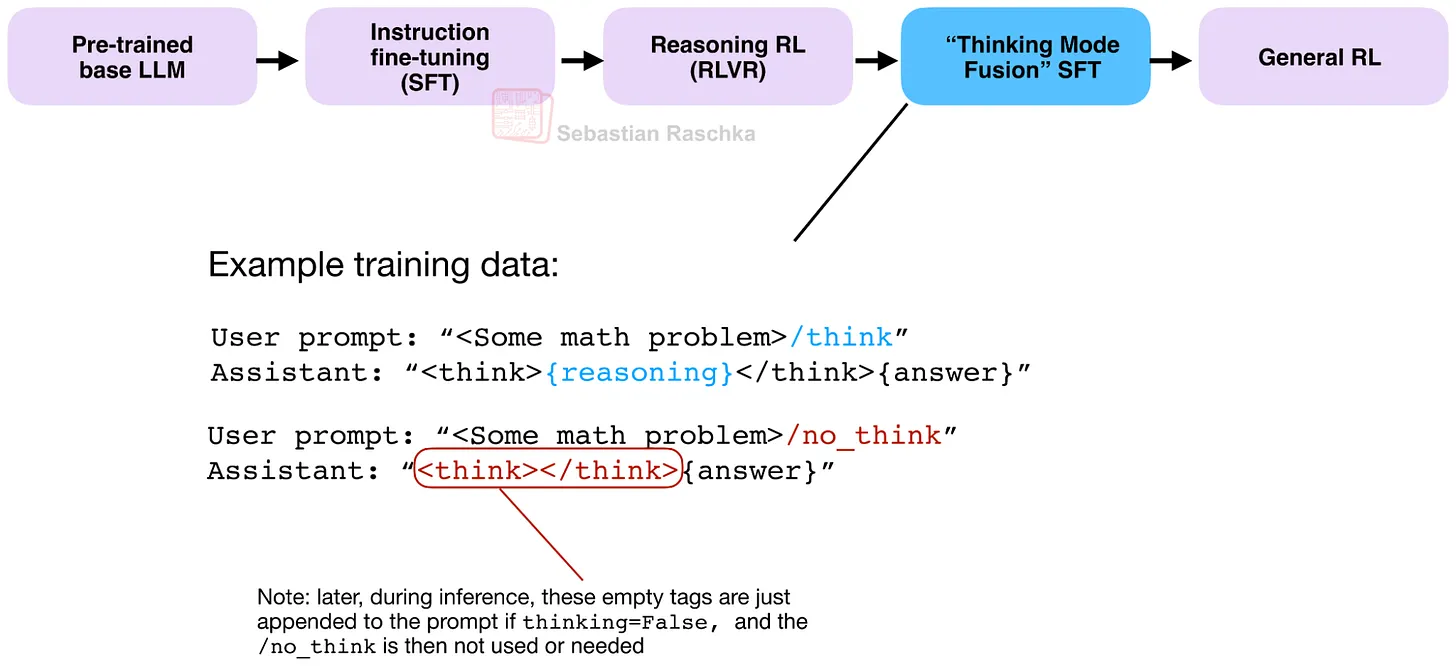
enable_thinking=True/False控制,关掉的实现在回答开头塞一个空的<think></think>,让模型直接跳到答案。这套开关是在Thinking Mode Fusion训练阶段里学出来的。
- 五、推理档位,本质上是往 system prompt 里塞了一句话
- GPT-5、GPT-5.6 这一代,开关从「开/关」变成了 low / medium / high / max 多档。
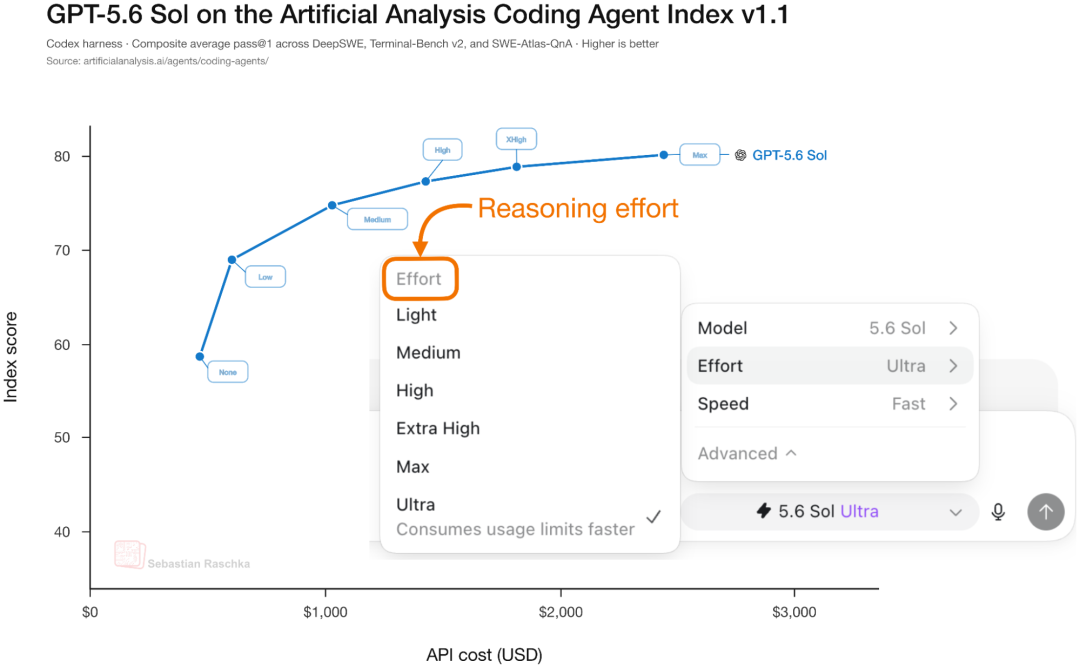
- GPT-5.6 暴露出从 Light 到 Ultra 的六档推理档位
- OpenAI 没公开闭源模型的实现,但从去年开源的 gpt-oss 能看出:档位通过 system prompt 控制,往每个请求前面加一句 Reasoning effort: low/medium/high。ChatGPT 界面上那个选择器,大概率只是把选择映射成这句话。
- 六、模型能「听懂」这句话,靠训练时的两种配方
- 路线一 RLVR 阶段动手脚: 不同 system prompt 配不同的长度惩罚。说「low」时对 token 数罚得重,逼它写短;说「high」时几乎不罚,放它写长。
- 路线二 RLVR 后再补一轮 SFT: 喂进「这个 prompt 对应这么长的推理」的样本,让模型把档位标签和目标长度对应起来。
- 两条路也能组合。推测 gpt-oss 和 GPT-5.6 组合
- 七、换模型和调档位,是两个互不干涉的动作
- GPT-5.6 界面把这两件事分得很清楚。
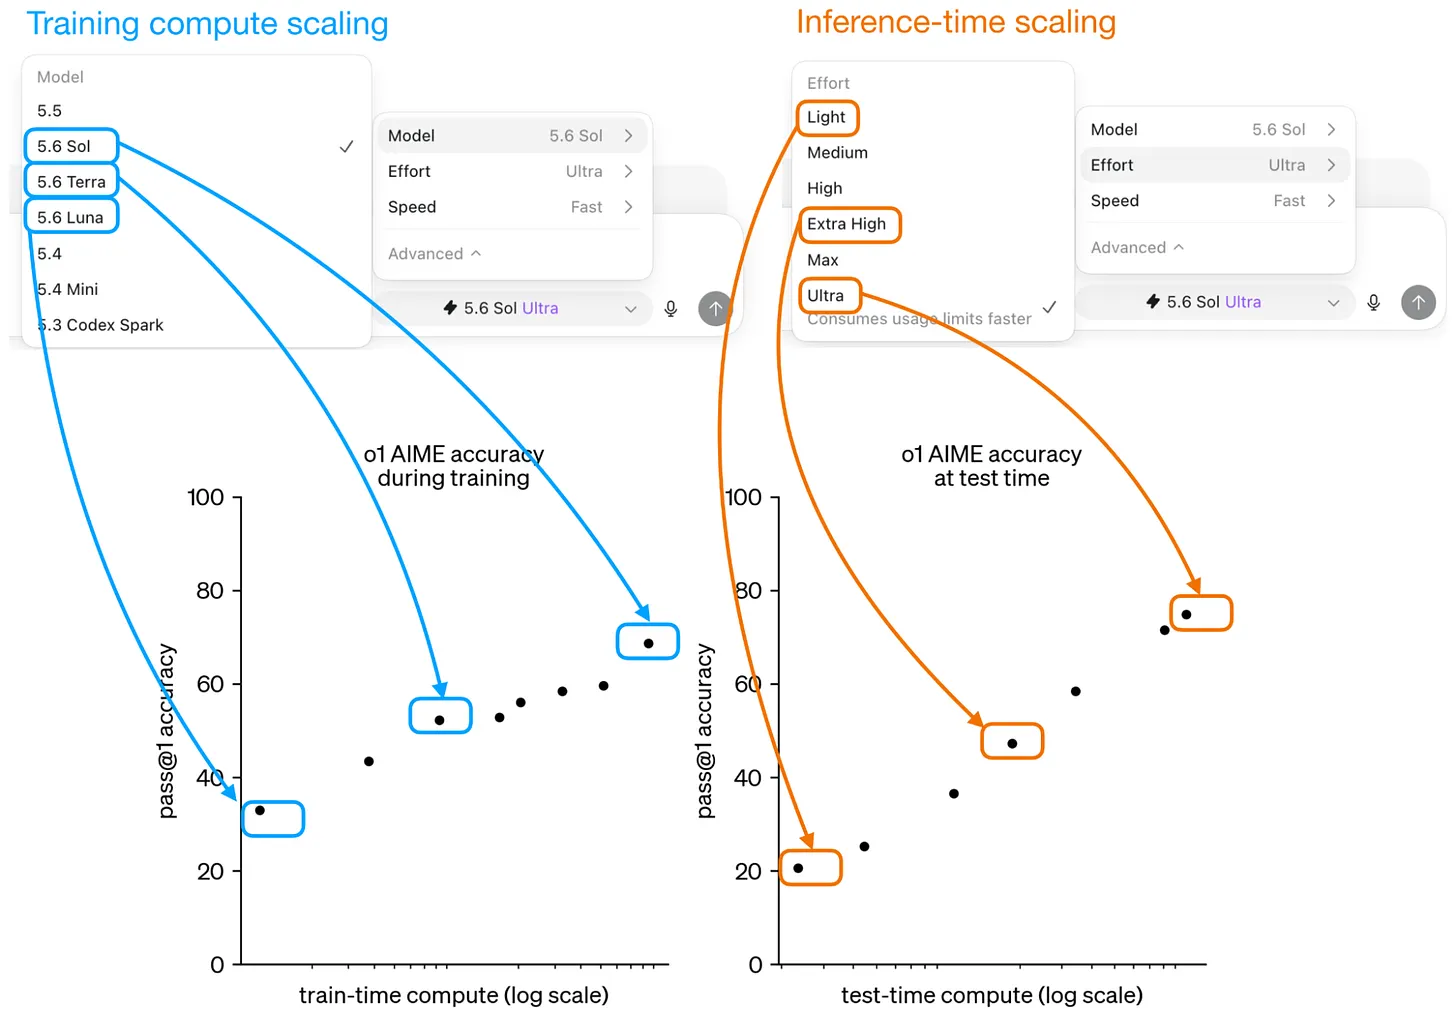
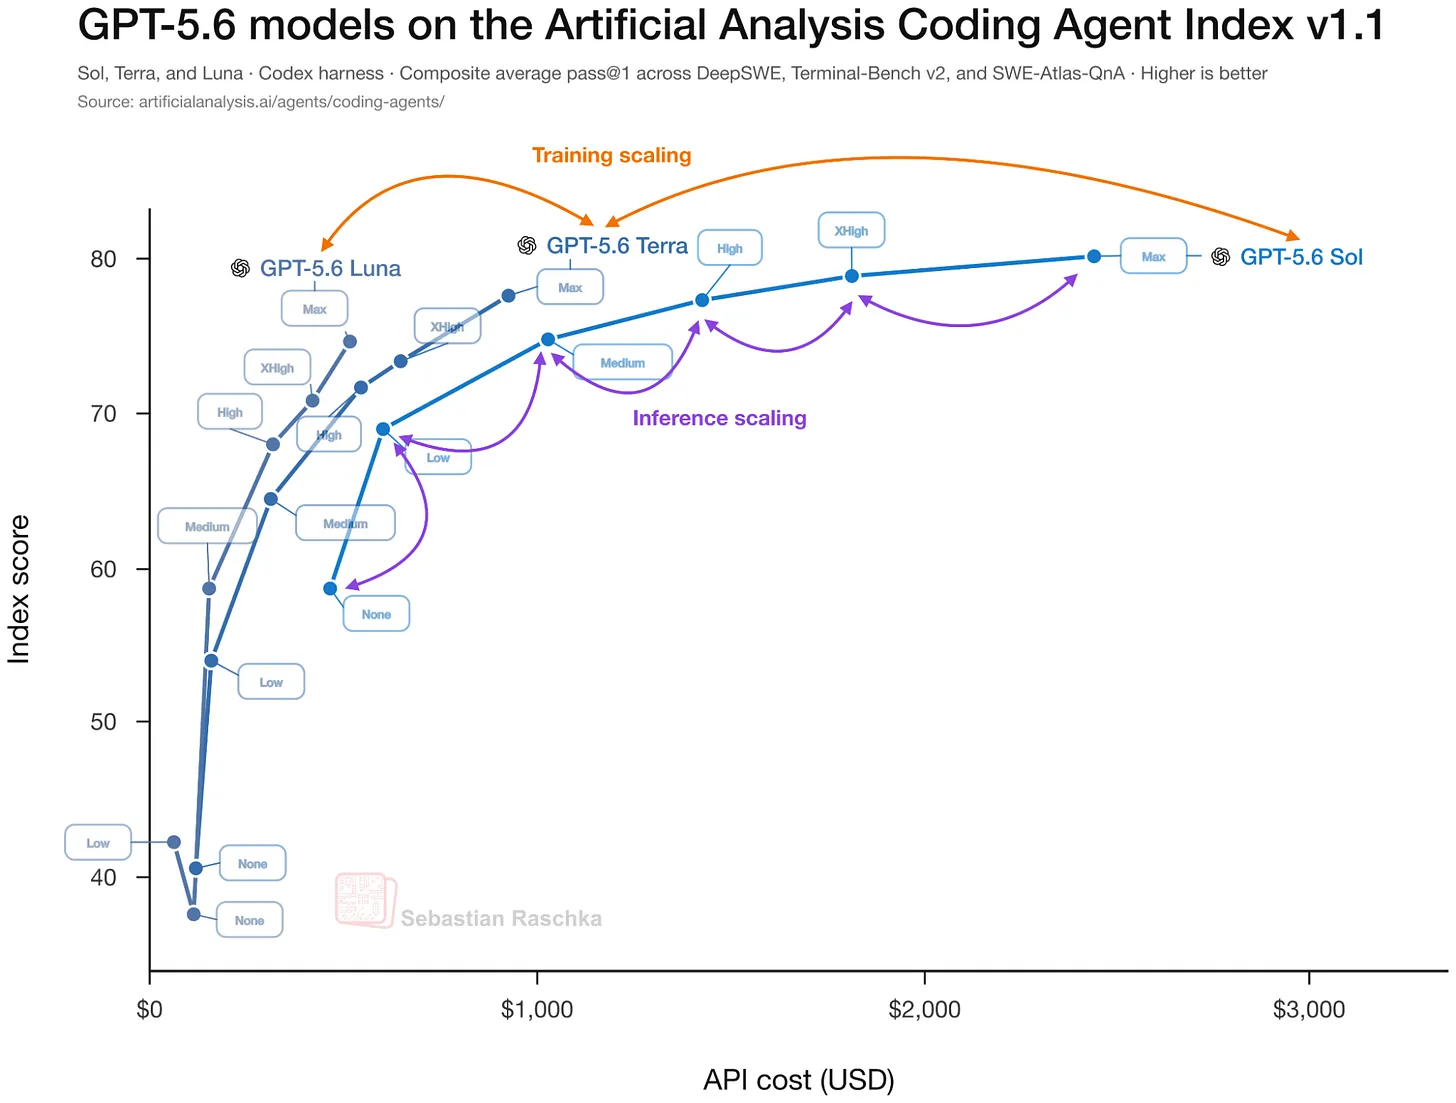
- 左边选 Luna / Terra / Sol,是在换模型本身,粗略对应「训练时投入的算力」;
- 右边调推理档位,模型不变,只是让它多花或少花 token,对应「推理时投入的算力」
- 选模型和调档位对应两个不同的 scaling 轴:前者换的是权重本身,后者只改推理时花掉的算力。
- 这两条曲线会重叠:一个小模型开高档,有时能追平一个大模型开低档的分数
- 更大的模型、还是把档位调高、还是两个一起上,取决于精度、成本和延迟。
- 八、档位不是越高越好,边际递减很明显
- 档位直接影响输出长度,长度又和精度正相关。
- gpt-oss 在不同推理档位下的响应长度与质量。档位越高,token 花得越多,精度也越高。但到某个点会饱和。GPT-5.6 Sol 的曲线尤其明显:推理档位越高,API 成本和 coding 表现一起涨,可涨到最高那几档,收益明显变小,继续加预算就不划算了
- 推理档位同时抬高 API 成本和 coding 表现,但在 GPT-5.6 最高档出现明显的收益递减。
- 总结:「拨到max」不等于「答得更对」。多数任务里,中间档才是精度、成本、延迟三者的甜点区。
- 九、国产旗舰,各有各的真实做法
- DeepSeek V4 训了三个「专家」:Non-think、Think High、Think Max,每个用不同的上下文窗口和长度惩罚,最后蒸馏进同一个 checkpoint。Think Max 那句 system 指令「Reasoning Effort: 绝对最大,不允许走捷径」看着像 prompt 技巧,其实背后有专门训练撑着,换个模型照抄这句话是没用的。
- DeepSeek V4 的三种推理模式:Non-think、Think High、Think Max,背后是不同的训练配置而不只是提示词差异。
- Kimi K2.5 Toggle 方法在训练时交替「限预算」和「不限预算」两个 RL 阶段,能把生成 token 砍掉约 25% 到 30%,benchmark 几乎不掉。更新的 K3 提供了 low / high / max 三档、max 为默认,但训练细节尚未公开,等它的技术报告。
- 未来:档位还会是显式输入,但会有人替你选
- GPT-5 曾经做过 Auto 模式,想自动选档,结果败多胜少,后来从界面上撤了。
- 近期推理档位仍会是一个显式输入,多半通过 system prompt 传进去。但 Agent 外面那层 harness、或者一个内部 router,会越来越多地根据任务状态和剩余预算自动推断该用哪一档,同时保留你手动覆盖的权利。想压延迟、想省成本、或想榨干性能,手动覆盖就派得上用场
总结对比
| 模型 | 推理算力控制(Effort control) | 公开训练机制(Disclosed training mechanism) | 推理阶段控制(Inference control) | 图解 |
|---|---|---|---|---|
| DeepSeek V4 | 无思考模式 / 高算力 / 最大算力 | 独立专家模型,搭配面向不同模式的SFT、GRPO、上下文窗口、长度惩罚;后续执行在线策略蒸馏 | 输出格式 + Max(最大算力)系统指令 | 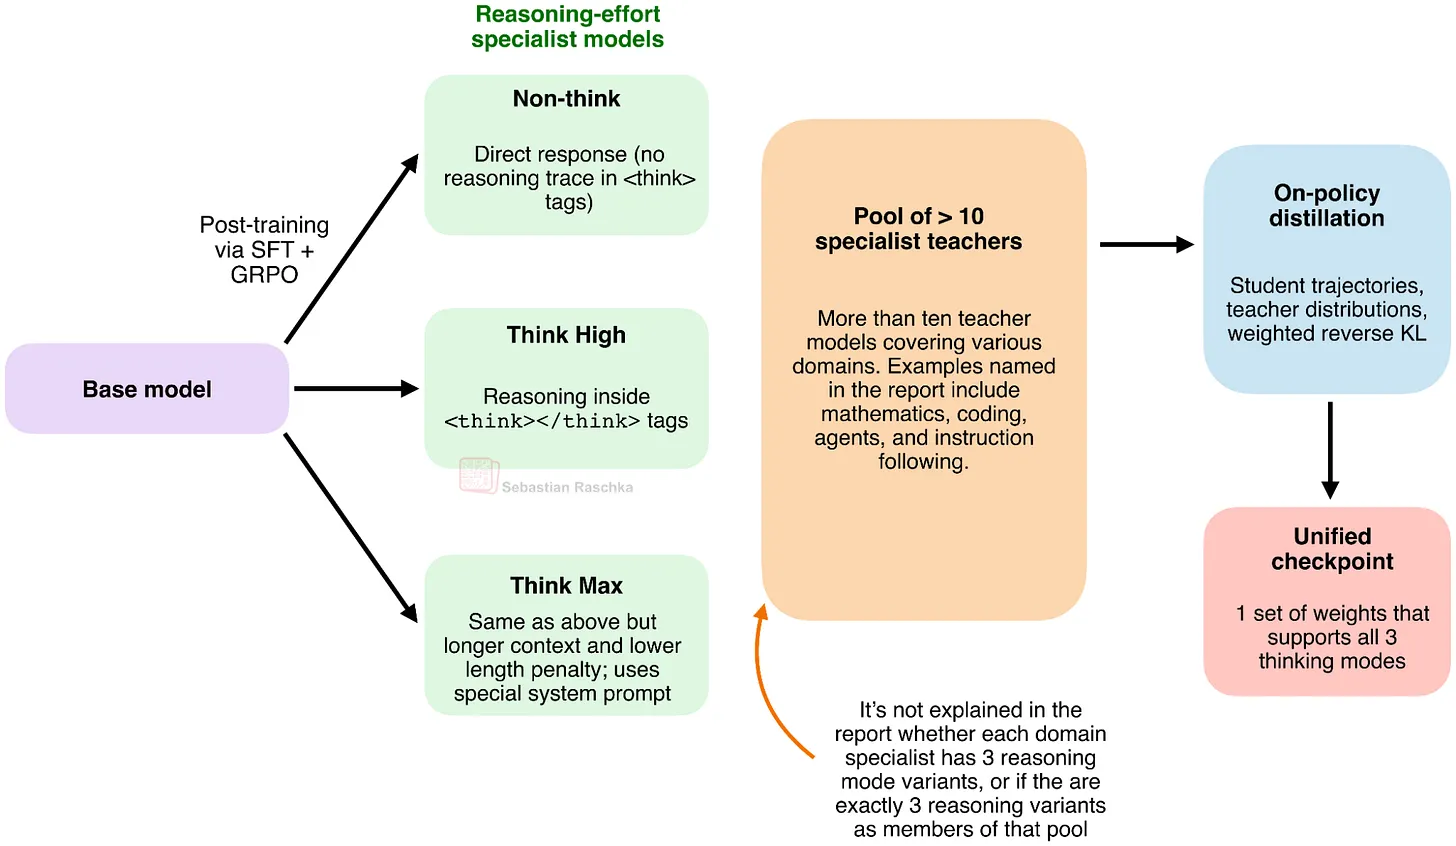 |
| Nemotron 3 Ultra | 关闭、中等、常规 | 教师生成的中等长度轨迹、随机预算截断、长度自适应RLVR | 模型自主学习模式,外加可选硬性算力预算 | 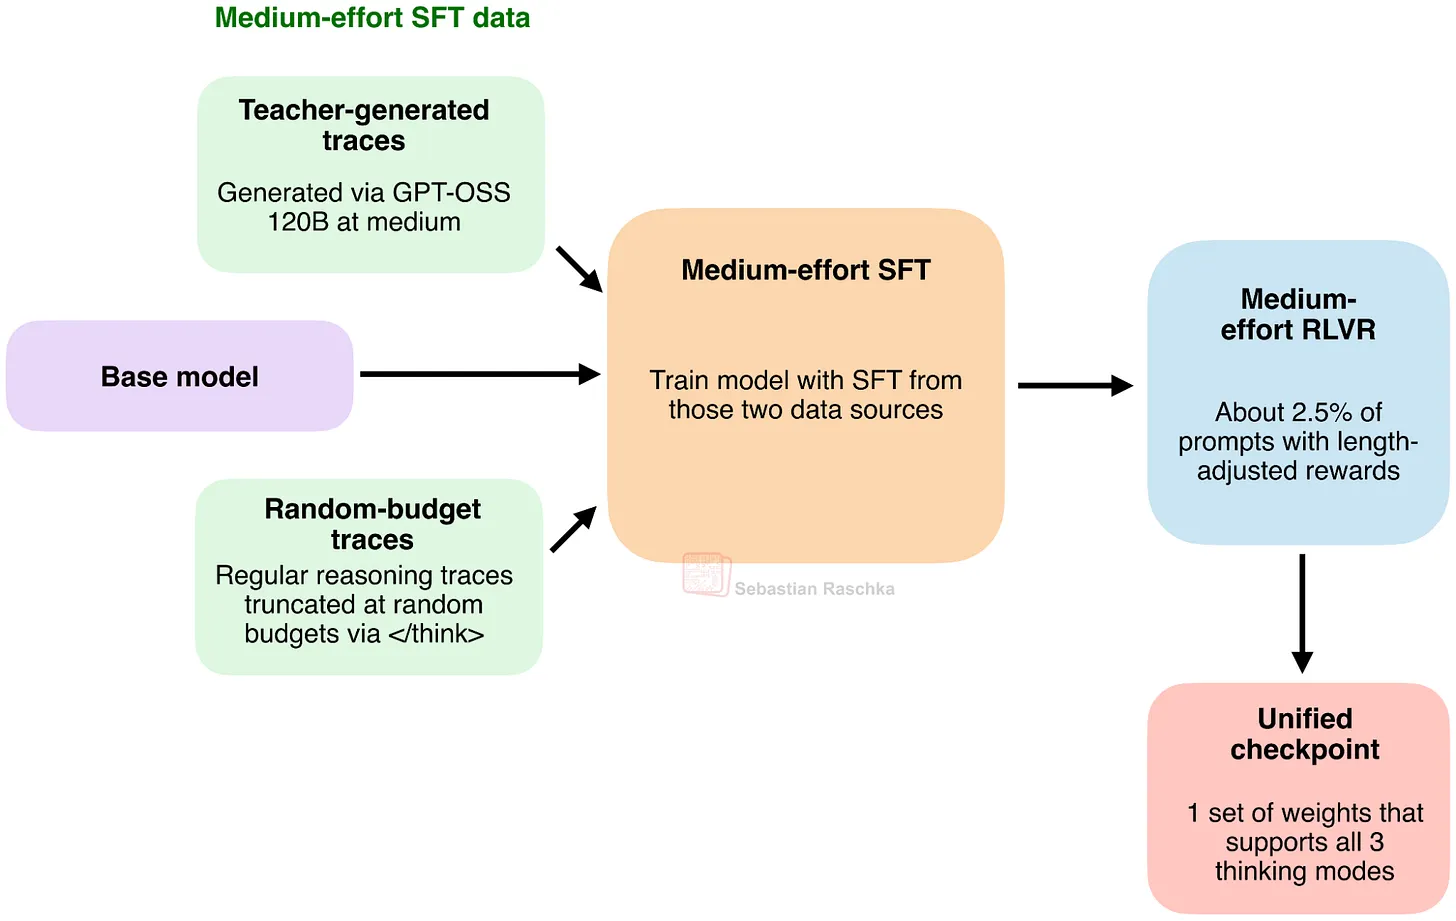 |
| Kimi K2.5 | 隐式词元高效推理 | Toggle(切换)机制:使用面向特定问题的算力预算,在带约束强化学习与无约束强化学习之间交替切换 | 存在思考模式与即时输出模式,但Toggle切换开关不对外暴露为独立选择器 | 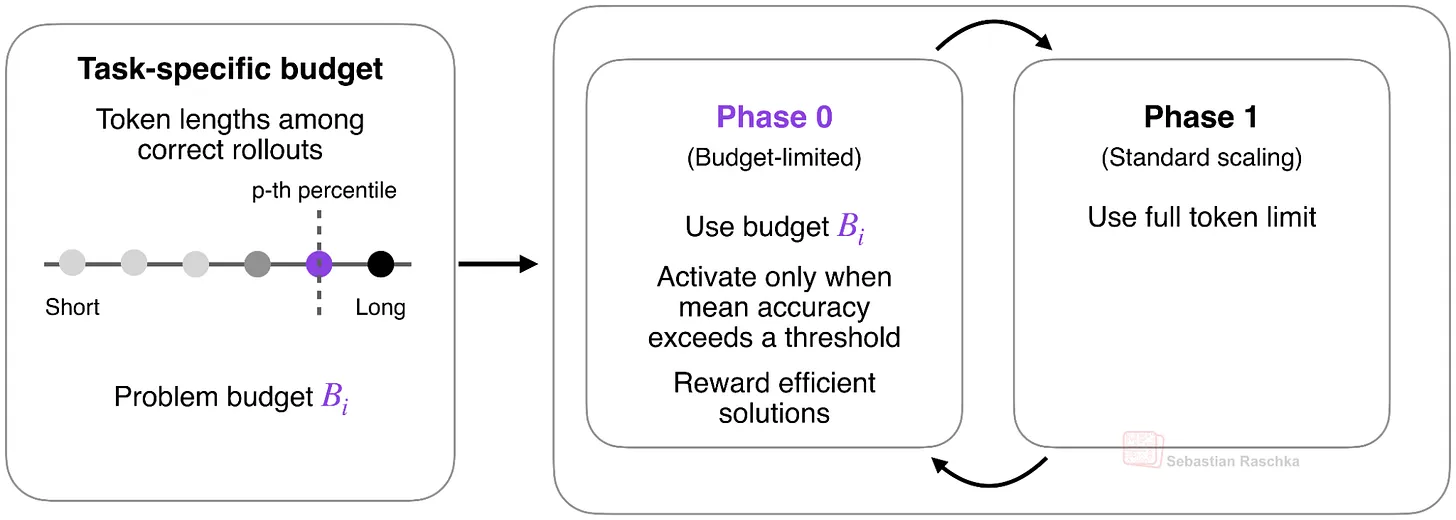 |
| GLM-5 | 每轮可开启/关闭思考;支持穿插式、保留式思考 | 多任务SFT,搭配更新对话模板、序列推理、智能体任务、通用强化学习;后续执行跨阶段在线策略蒸馏 | 每轮二元开关;调用工具前自动推理;可选择保留前面的推理块 | 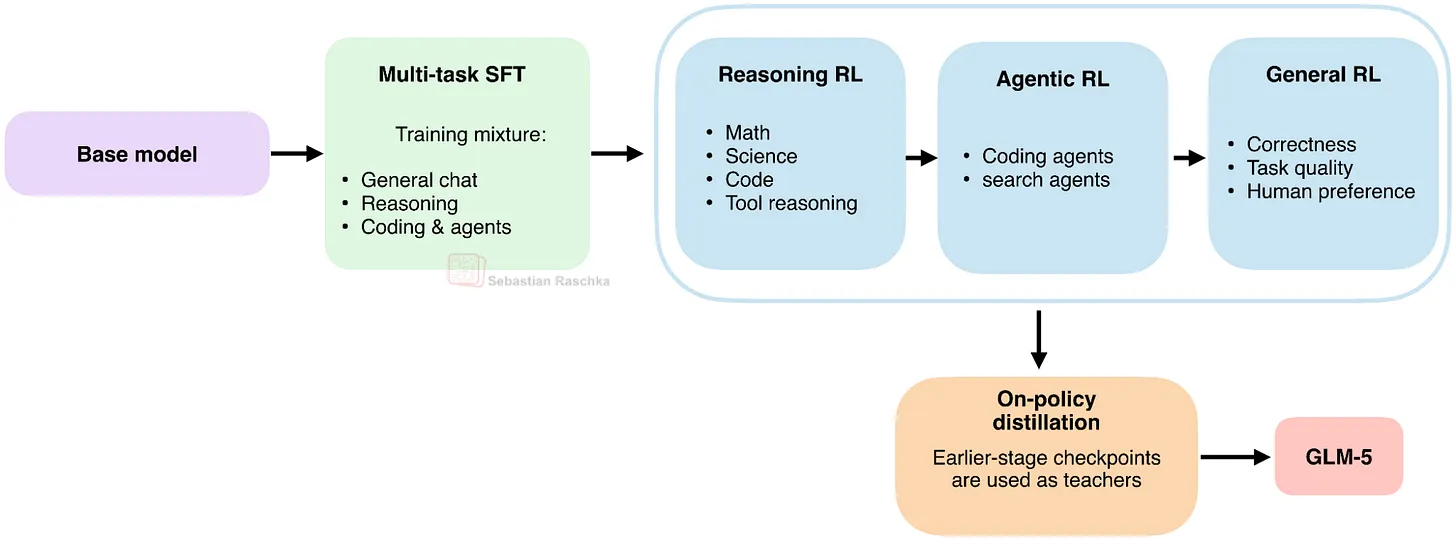 |
| Qwen3 | 无思考、思考、词元预算 | 思考模式融合SFT,之后进行通用强化学习 | /no_think、/think指令,推理阶段截断 |
 |
| Inkling | 连续标量(0.0 ~ 1.0) | 基于算力条件的强化学习,采用随算力变化的词元代价 | 在系统提示词中设置算力数值 |
实现方法
混合
【2025-5-25】自适应快慢思考推理模型(Adaptive Reasoning Model):Qwen3混合思考->字节AdaCoT->清华AdaptThinking
混合思考模式
- 阿里巴巴通义实验室的 Qwen3 混合思考方式
- 字节跳动 Seed 提出的 AdaCoT 的自适应(adaptive)CoT 方式。
- 【2025-5-19】清华大学提出 AdaThinking 框架
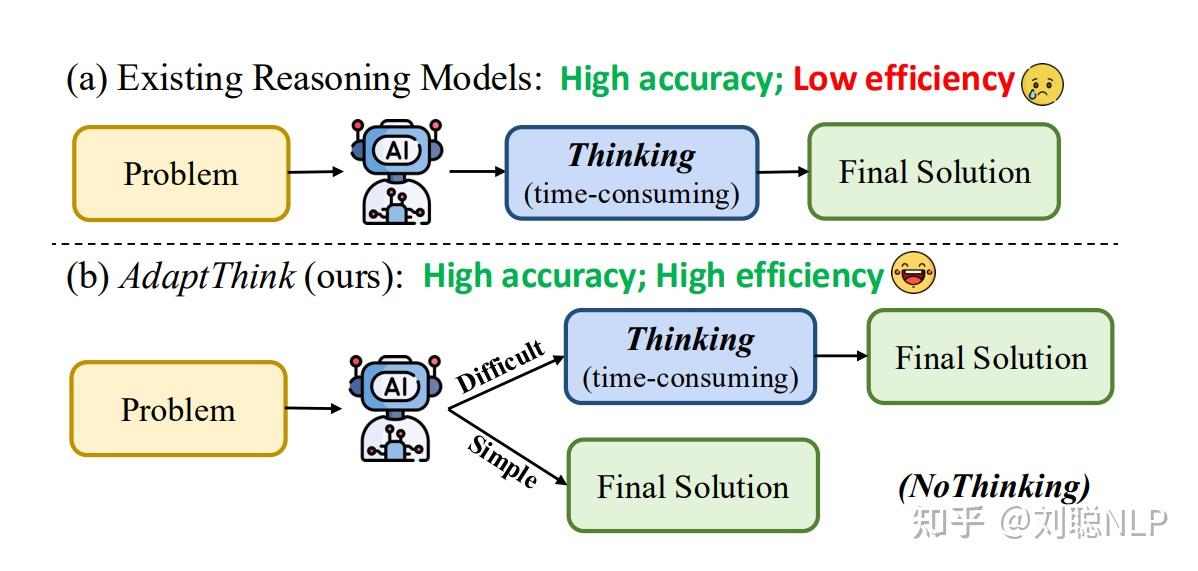
备注:AdaCoT 和 AdaThinking 出发点几乎一模一样,都可用下图表示(from adathinking)。
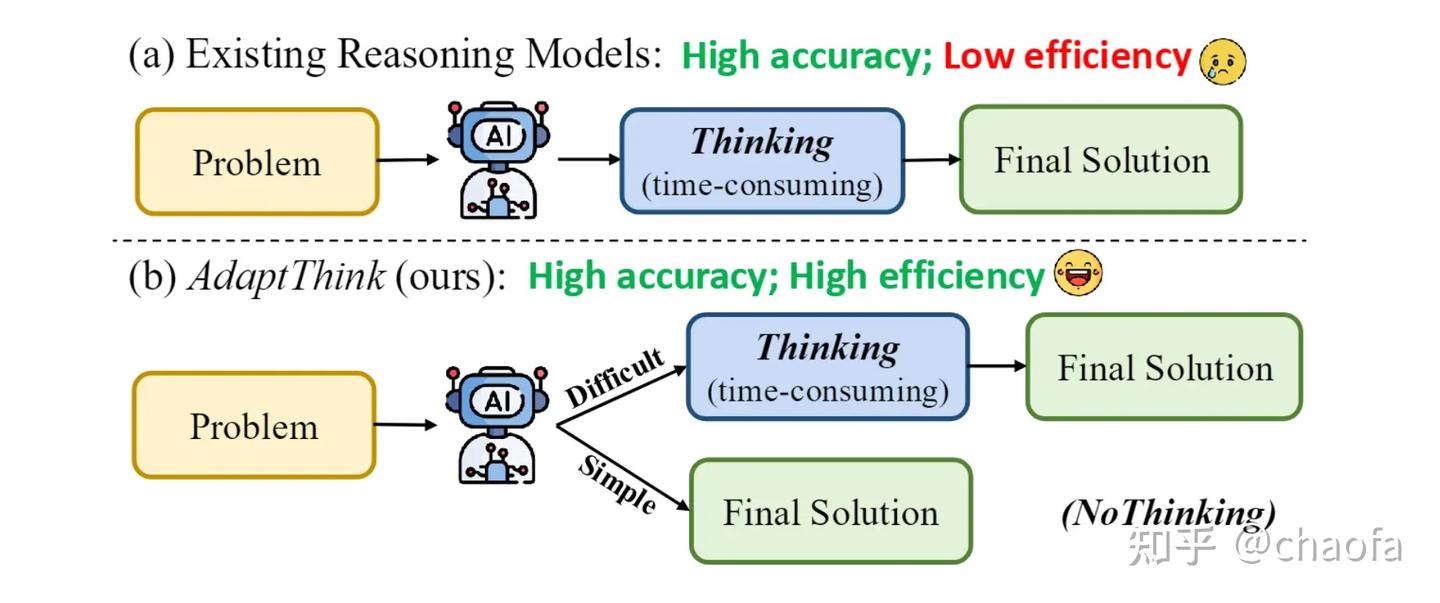
- Qwen3 主要通过 SFT训练 让模型天然具备遵循【思考、非思考】模式,但需要人为控制。
AdaCoT和AdaThinking让模型自己决定,简单问题不用思考,复杂问题可以思考。- 其中
AdaCoT通过把优化目标转换成Paretooptimization,然后利用 PPO 算法进行优化 AdaThinking也是通过 PPO 算法优化,把问题视为:尽量少触发 CoT 的情况下,新模型的回复大于【旧模型回答】且大于【Thinking 模式模型的回答】。
- 其中
Qwen 3 混合推理
Qwen3 的整体训练流程:四阶段,思考混合模式(Thinking Mode Fusion)位于第三个阶段
字节Seed AdaCoT
字节Seed AdaCoT 把是否要输出 CoT(思考过程 Thinking)当做多目标帕累托最优的方式。
模型主动触发思考和非思考过程,而不是像 qwen3 一样人为控制。
【2025-5-19】清华 AdaptThink
和 Seed-AdaCoT 这个文章出发点一样
【2025-5-22】推理or不推理?AdaptThink实现思维模式的自动切换
【2025-5-19】清华KEG实验室 论文 paper 让推理模型学会何时推理、何时不推理,并自行决策。
实验
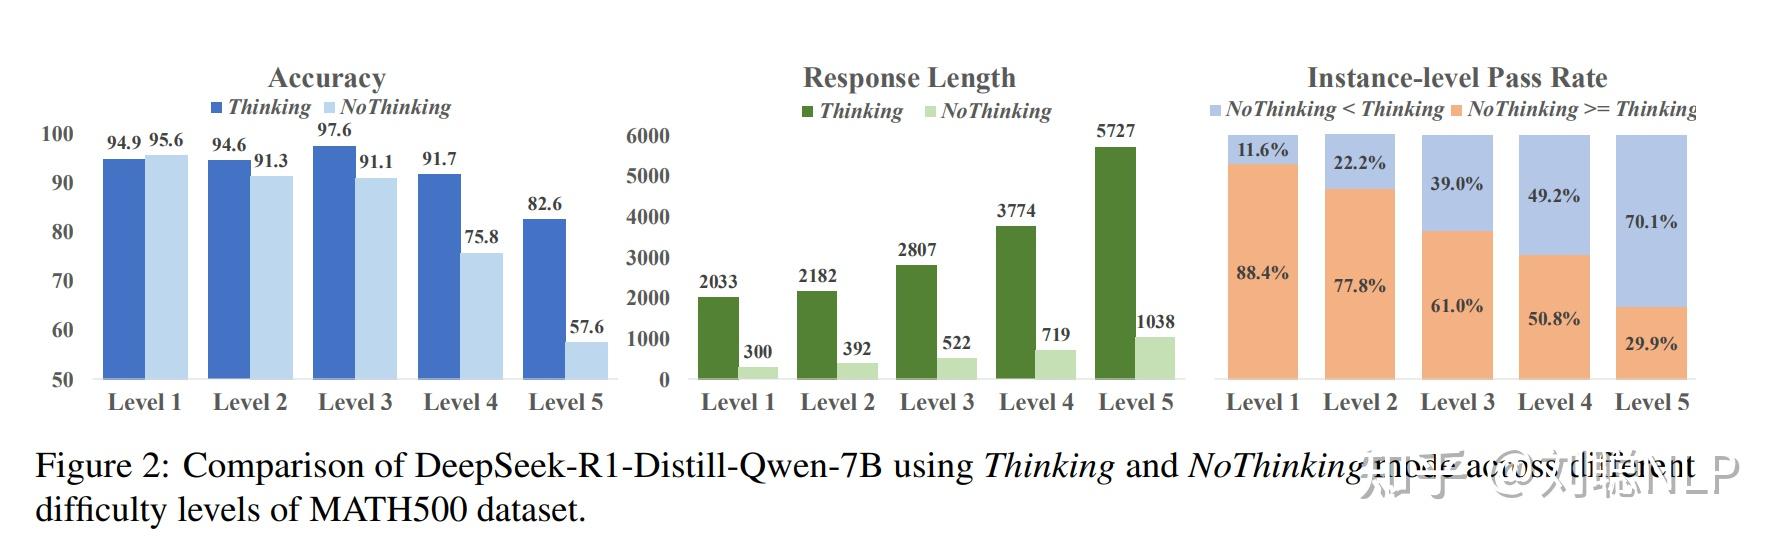
- 让 DeepSeek-R1-Distill-Qwen-7B 模型使用 NoThinking 和 Thinking 两种模式,预测5个难度等级的MATH500问题
结果
- 在1-3级问题上,NoThinking 和 Thinking 效果相当
- 甚至在1级上NoThinking效果还更优,但回答长度明显变短。
基座模型选择 DeepSeek-R1-Distill-Qwen-1.5B 和 DeepSeek-R1-Distill-Qwen-7B,训练框架为VeRL。
训练上下文长度、batch size 和学习率分别为 16K、128 和 2e-6。AdaptThink 中的超参数K、 δ和 ϵ 分别为 16、0.05 和 0.2。
在GSM8K、MATH500和AIME 2024上进行评测,如下表所示,与原始的1.5B和7B模型相比,AdaptThink平均响应长度分别降低了53.0%和40.1%,,同时平均准确率分别提高了2.4%和2.3%。
AdaptThink 核心优化:
- 约束优化目标:在保证整体性能不下降的情况下,鼓励模型选择NoThinking模式。
- 重要性采样策略:在在线策略训练期间,平衡 Thinking 和 NoThinking 样本,探索和利用两种思考模式。
附录
- 模型 DeepSeek-R1-Distill-Qwen-1.5B
- 代码 THU-KEG/AdaptThink
- 数据 AdaptThink-1.5B-delta 系列
-
训练框架 VeRL
多模型决策
如今的 AI 应用,大多依赖单一模型推理,即用户问题会直接被送入某个固定的 LLM 中进行回答。
这种方式虽然简单,但却意味着:
- 简单问题可能导致算力浪费;
- 复杂问题又可能因模型能力不足而回答错误。
MoE
单个问题自动路由到对应模型
MoE 在 Token-level 路由
LLM Router
“LLM Router” 成为 AI 系统的新前台大脑:
- 不同于 Token-level Router(如 MoE),LLM Router 在 Query-level 层面进行路由,它能够判断一个问题的复杂度、匹配最合适的模型,甚至动态组合多个模型完成推理。
然而,现有的 LLM Router(如 GraphRouter、RouterDC 等)大多采用单轮决策机制:
- 给定一个问题,只路由到一个候选模型完成回答,这种单轮路由机制难以处理多跳推理或跨领域的复杂任务。
Router-R1:让 Router 本身成为一个「会思考的 LLM」
【2025-10-16】首个多轮LLM Router问世, Router-R1可让大模型学会「思考–路由–聚合」
伊利诺伊大学厄巴纳-香槟分校(UIUC)NeurIPS 2025 上发布新作,首个多轮 LLM Router 框架 Router-R1,让 LLM 不止会 “回答”,还会 “思考、调度与协调其他模型” 来达到可控的性能与成本平衡
- 论文 Router-R1:Teaching LLMs Multi-Round Routing and Aggregation via Reinforcement Learning
- 代码 Router-R1
Router-R1 核心创新:让 Router 自身成为一个具备推理能力的 Policy LLM。
Router-R1 不再只是一个 “Query 分发器”,而是一个拥有思维链,能主动进行 “思考 — 选择模型 — 聚合” 的智能体,可以在思考,路由,聚合几种行为之间反复切换并进行多轮路由迭代,逐步构建最终答案:
- 1️⃣ Think(思考):在接收到 User Query 后,Router-R1 会首先执行 “思考” 阶段进行内部推理分析,并判断是否需要外部信息进行辅助;
- 2️⃣ Route(路由):若发现需要额外信息,Router-R1 则触发 “路由” 指令根据每个 LLM 的 Descriptor Prompt 动态调用合适的外部候选模型(如 Qwen、LLaMA、Gemma、Mixtral 等)进行回答子问题;
- 3️⃣ Aggregate(聚合):外部模型调用的回复结果返回后继续插入 Policy LLM 的 Evolving Context 进行聚合,并继续进行后续的多轮推理逐步生成最终答案。
这种 “思考–路由–聚合” 的交替机制,使 Router-R1 能充分利用不同 LLM 的互补优势(例如一个擅长数学推理、另一个擅长知识检索),潜在实现真正的多模型协同推理。
Router-R1 将整个多轮路由过程形式化为一个序列决策问题,并通过强化学习训练 Router 使之学会在复杂决策空间中优化 Performance-Cost Trade-off。论文中设计了三类直观的奖励函数:
- 1️⃣ Format Reward:输出 Format 正确性奖励,模型输出严格遵守如
、 等格式约束,防止训练早期生成无效文本。 - 2️⃣ Final Outcome Reward:结果正确性奖励,采用 Exact Match(EM)指标衡量生成答案与标准答案是否完全一致,直接激励 Router 输出正确结果。
- 3️⃣ Cost Reward:成本约束奖励,Router-R1 创新地引入了计算成本奖励机制,根据被调用模型的参数规模及输出 Token 数设计反比例奖励函数
7 个 QA Benchmark 上对 Router-R1 进行了系统评测,涵盖单跳与多跳推理任务,包括 NQ、TriviaQA、PopQA、HotpotQA、2WikiMultiHopQA、Musique 和 Bamboogle。Router-R1 仅在 NQ 与 HotpotQA 数据集上进行训练,在其余数据集上执行 Out-of-domain Evaluation。
- 当 α=0 时(即只优化 performance 不考虑 cost),Router-R1 在所有数据集上达到了综合最强的性能,击败了如 GraphRouter/RouterDC 等单轮路由方法,并展现出了对 Unseen Dataset 的较强泛化性。
- 当继续改变超参 α 来探究性能成本权衡时,随着 α 增加,调用成本显著下降,为可控成本的 LLM 智能调度策略开辟了新的范式。
Router-R1 不是又一个 “更大的模型”,而是让多个模型协同工作的新范式。Router-R1 通过强化学习,让 LLM 从 “单一回答者” 进化为「多智能体协调者」,在性能与成本之间实现动态平衡。得益于此,Router-R1 能在减少算力和成本开销的同时保持高质量输出,降低大模型部署的环境与资源压力。Router-R1 天然支持模型重用与模块化组合,只需添加新模型描述即可快速集成,为构建可扩展、多模型共生的 AI 基础设施奠定了基础。
 支付宝打赏
 微信打赏