在线蒸馏 OPD
知识蒸馏由 Hinton 等人(2015)奠定。小型学生模型可以通过拟合教师模型软化后的输出对数概率,从更大的教师模型中学习。
- 经典的离线策略蒸馏在 “大模型向小模型蒸馏” 任务中取得了可观成果)。
- 针对序列生成任务,Kim 和 Rush(2016)将该思路拓展为序列级知识蒸馏(SeqKD),让学生模型对齐教师模型的序列级分布。
离线蒸馏
传统离线蒸馏:“看录像学习”
流程:
- 老师先完成所有任务、生成标准答案,学生全程照着老师的“录像”模仿学习。
核心问题:
- 暴露偏差——学生平时练的是老师的正确轨迹,一旦自己生成时出错,后续会一步步错下去,无法自我修正。
离线蒸馏 vs 在线蒸馏
【2026-7-9】On-Policy Distillation(OPD):为什么越来越多的大模型开始采用它
传统知识蒸馏(Supervised KD,Hinton et al., 2015)通常采用离线(Offline)范式。
- 核心流程: 利用 Teacher 模型在给定输入x下生成(或采样)高质量的序列y,随后指导 Student 模型进行学习。
- 训练目标: 通常定义为 Token 级的 Forward KL 散度
强假设:
- Student 在推理阶段自回归生成时的前缀分布
p_s(y|x)与训练阶段 Teacher 所暴露出的前缀分布p_t(y|x)完全一致。
然而,自回归生成中,假设并不成立。
GKD 论文(Sec 3.1)指出:传统 KD 存在严重 Train-Inference Distribution Mismatch(又称 Exposure Bias 暴露偏差):
- 训练时:Student 始终在 “正确”(Teacher 生成)前缀上进行预测。
- 推理时:Student 依赖自身历史输出。一旦某一步采样出现偏差(例如生成了低概率 Token),后续所有预测都将基于从未在训练中见过的错误前缀展开。
因此,传统 KD 只能让 Student 学习 Teacher 的正确路径,却无法指导 Student 如何处理自身生成的错误轨迹,导致误差逐步累积,并限制最终蒸馏效果
OPD(On-Policy Distillation)核心思想 on-policy imitation learning:
- 不再用 Teacher 提前生成的固定轨迹,而是让 Student 根据当前策略自行生成样本,并由 Teacher 在 Student 实际会遇到的状态上提供 token-level 监督信号。
- OPD 训练数据采样自 Student 当前参数化策略,而非固定数据集或 Teacher 的策略
OPD 不再要求 Student 去复现 Teacher 已经走过的路径,而是在 Student 自己可能遇到的状态上,让 Teacher 提供更加贴近实际推理过程的指导。
从根本上缓解了传统 KD 中由于 train–inference distribution mismatch 导致的 exposure bias 和误差累积问题。
OPD 最容易让人误解:
- Teacher 并不是读取 Student 的最终答案进行打分,而是将 Student 已生成的 prefix 作为输入,通过一次 forward,计算当前位置的 next-token probability distribution
KL 散度衡量两个概率分布之间的差异。 对于每一个 token 位置,Teacher 都会给出整个词表上的概率分布,KL loss 会推动 Student 调整自己的预测,使其逐渐逼近 Teacher 的分布,而不仅仅是学习某一个正确 token。 因此,OPD 学习的是 Teacher 的决策偏好(decision distribution),而不是单一答案。这也是知识蒸馏通常采用 KL 散度而非交叉熵监督的重要原因。
Teacher 不提供一条标准答案,而是在 Student 自己生成的轨迹上,为每一个 token 位置提供概率分布指导,最终通过 token-level KL loss 完成能力迁移。
OPD 更适合 Reasoning Model
Reasoning Model 推理过程通常包含较长的自回归轨迹,每步生成都会影响后续的推理状态。
一旦早期 token 出现偏差,后续上下文也会随之发生变化,误差会在整个推理过程中不断累积。
传统 Offline KD 只能学习 Teacher 提供的标准轨迹,而 OPD 则直接在 Student 自己生成的轨迹上进行蒸馏,使监督信号覆盖 Student 实际会访问到的状态分布,从而有效缓解长链推理中的 train–inference distribution mismatch。
因此,对于数学、代码、Agent 等依赖长程推理的任务,OPD 能够更有效地完成能力迁移,这也是其成为近年来 Reasoning Model 后训练重要技术路线的原因之一
OPD 行业标配
OPD成为大厂标配的原因
- 工业落地广泛:Qwen3、MiMo、GLM-5等主流大模型后训练均采用;
- 成本优势显著:比传统强化学习(RL)计算成本低一个量级;
- 效果更稳定:相比传统SFT,有效减少错误累积,小模型能快速追上大模型推理能力。
【2026-6-9】On-Policy Distillation (OPD):起源、发展路线与当今现状
OPD 在 18 个月内完成了从 ICLR 论文到后训练新范式的跨越。
2026 年的核心命题从”要不要用 OPD”变成了”如何用 latent space / multi-teacher / adaptive KL / offline precompute 来突破 OPD 的 token 空间瓶颈和长序列限制”。路线图现已覆盖 56 篇参考文献、17 种 OPD 变体、14 篇深度论文分析(含 4 篇 latent reasoning)、完整的 Forward/Reverse KL 理论基础。
2026年4月,多家大模型开始重度使用 OPD
- DeepSeek-V4:先训练领域专家,再用 on-policy distillation 统一整合
- 论文 5 (Tsinghua):OPD 机制深度分析,分布不可区分性,97-99% 概率质量
- MAD-OPD:多智能体辩论突破单教师天花板
- StableOPD / SCOPE:训练稳定性与采样策略改进
- Qwen3.5-Omni:全模态模型技术报告;此处不再作为 OPD 直接证据引用
【2026-8-3】2026年后训练变化
- ① 范式:配方从「单一大模型」转为「多专家 + 蒸馏合并」(MOPD)
- ② 效率:在线蒸馏(On-policy Distillation)成为 RL 的廉价替代,5–10× 效率
- ③ 缩放轴:测试时计算(test-time compute)取代预训练数据,成为主缩放轴
- ④ 精细化:RLVR 从「堆算力」转向「精选样本 + 熵控制 + 机制理解」
- ⑤ 数据:数据质量被反复验证为不可替代的硬约束
演进脉络
- 2022–2023:InstructGPT 单管道(SFT → 奖励模型 → RL)
- 2024:SFT → DPO → RLVR 标准化
- 2025:DeepSeek-R1 把大规模推理 RL 推到中心舞台
- 2026:配方「碎片化」——先训练 N 个领域专家,再蒸馏合并回一个通用模型MOPD(多教师在线蒸馏)怎么运作
分别训练数学、代码、agentic等各领域的专家模型,再训练一个通用学生模型:采样自己的轨迹,对每个 token 做逐 token 蒸馏
由MiMo Flash v2(2026 年 1 月)提出,DeepSeek V4与Nemotron 3 Ultra规模到 10+ 个教师
动因:把数学、代码、agentic 三类 RL 混在一个 run 里训,成本高且能力互相打架;专家模型便宜、可并行组织,再靠蒸馏合并。
在线蒸馏
在线蒸馏OPD:“实战陪练式学习”
OPD= 强化学习 + 蒸馏的密集监督
本质是“边练边改”,流程极简:
- 学生自主完成任务,生成属于自己的推理轨迹(相当于“自己做题”);
- 老师对学生生成的每一个token(每一个字、每一个词)打分,给出密集奖励信号(相当于“逐字点评”);
学生只在自己真实会踩的坑上学习,逐步对齐老师的分布(相当于“边错边改”)。
【2025-10-27】On-Policy Distillation

对比
| 方法 | 采样策略 | 奖励信号 |
|---|---|---|
| SFT | 异策略 | 密集 |
| RL | 同策略 | 稀疏 |
| OPD | 同策略 | 密集 |
| 角色 | 图解 |
|---|---|
| 题目 | 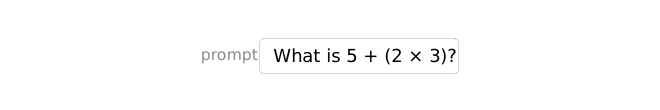 |
| 学生 | 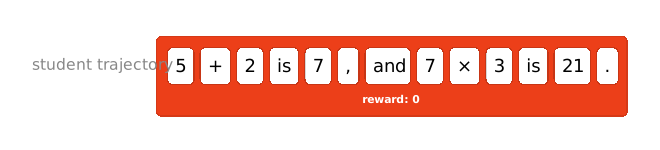 |
| 教师 | 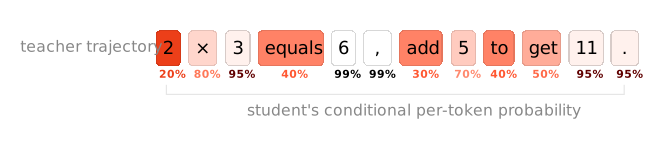 |
| OPD | 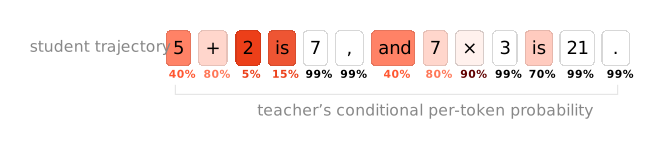 |
什么是 OPD
小模型(学生)自己答题,大模型(教师)对生成的每个 token 实时打分纠错。
类比学棋:
SFT=看大师棋谱RL= 自己实战,只看输赢OPD= 大师在一边辅佐每步棋 = RL 的实时相关性+SFT 的稠密反馈,两头好处都占了。
💰 为什么爆火:算力账本
AIME’24 数学基准(Qwen3-8B 学生 / 32B 教师):
- SFT:40 万 prompt 到 60%,外推 70% 要 200 万
- RL:17,920 GPU 小时,67.6%
- OPD:约 150 步(7.7 万 prompt)到 70%
约 RL 十分之一的算力,效果还更好。
📈 发展 4 步走
- 2023 奠基:MiniLLM 提出 reverse KL,GKD 确立框架
- 2024 工程化:DistiLLM 提速 4.3×
- 2025 引爆:Thinking Machines 博客出圈,Qwen3 写进配方
- 2026 爆发:自蒸馏等四支线并进,首篇综述出现,awesome 收录 492 条
🏭 工业界在用
Qwen3、DeepSeek-V4、GLM-5、MiMo-V2-Flash 技术报告都有 OPD。
适合场景
什么任务适合OPD?
- 结果易于验证的推理任务:
- 数学竞赛: 如论文中测试的 AIME、AMO-Bench。因为有明确的正确答案 $y^\star$ 作为特权信息。
- 代码生成: 教师可以利用单元测试结果或参考代码来修正学生的逻辑。
- 逻辑推理: 任何可以提供“标准答案”引导的任务。
- 具有一定规模的模型:
- 模型需要具备一定的自反思能力。在 4B 或 8B 规模的模型上效果显著,但在 1.7B 的极小模型上提升有限,因为极小模型很难在看到答案后“理性化”推理过程。
- 算力受限的训练场景:
- 如果没有足够的算力去跑大规模的强化学习(RLVR),OPSD 提供了一种极其高效的替代方案,能以极小的采样代价换取高质量的推理能力提升。
OPD 学什么
token 级机理拆解:OPD到底在学什么?
OPD训练过程拆解到每一个token,揭开了其底层逻辑——成功的OPD,本质是“高概率token的逐步对齐”。
成功OPD的三大核心特征
- 重叠率渐进提升:学生与老师的top-k token重叠率,从初始72%逐步提升到91%以上;
- 熵差持续缩小:学生和老师的熵(反映输出的不确定性)差距不断减小,自信程度逐步对齐;
- 概率高度集中:共享token集(学生和老师都认为是高概率的token),集中了97%–99%的概率质量。
关键发现:只学共享token就够了
论文通过消融实验验证:
- 仅优化“学生与老师的共享top-k token”,效果和优化全词表几乎一致;
- 仅优化“非共享token”,学生几乎没有任何提升。
结论:OPD 99%的收益,都来自极少数高概率共享token,非共享token几乎没有贡献。
强老师带不动弱学生
灵魂拷问:为什么强老师反而带不动弱学生?
论文最反直觉、最有价值的发现:
老师更强 ≠ 蒸馏一定成功,老师的“强”(参数大、分数高),不等于蒸馏一定成功。
实验中多次出现:
- 7B大模型老师,反而带不动1.5B小模型学生;
- 同一家族的大模型,效果不如经过RL优化的小模型。
论文给出OPD成败的两大铁律,缺一不可。
- 铁律1:思维模式必须对齐(最关键)
- 核心判断标准:学生和老师的top-k token(高概率候选词)重叠度要高。
- 思维对齐:即使老师不是最强,学生也能快速进步;
- 思维错位:哪怕老师分数更高,早期重叠度低,后期训练也无法挽回,蒸馏必然失败。
- 铁律2:老师必须有“真·新知识”
- “强老师”的核心不是参数大、分数高,而是拥有学生没有的新知识:
- 无效老师:仅参数更大、训练数据和学生一致,没有额外能力提升;
- 有效老师:经过额外RL后训练,掌握了学生没学过的能力(如更精准的推理逻辑)。
结论:高分 ≠ 新知识,没有新知识的老师,再强也带不动学生。
关键实验:反向蒸馏验证
实验设计:用“经过RL优化、变强后的1.5B模型”当学生,用“未优化的原始1.5B模型”和“未优化的原始7B模型”分别当老师。
实验结果:
- 学生在蒸馏后,直接退回未RL优化前的水平;
- 7B老师虽然分数更高,但蒸馏效果和1.5B老师完全一致。
核心证明:OPD本质是学习老师的思维模式,而非单纯复制分数。
原理
步骤
- 学生生成部分/完整回答,即轨迹
- 序列
y~πθ(*|x)
- 序列
- 轨迹交给教师评估每个token是否符合自己的分布
- 学生根据逐token信号更新参数
第 t 步,损失函数 L_opd=E[∑D(πθ, πt)]
其中,D可以是
- Farward KL:
D_KL(πt||πθ)学生分布 πθ 趋近于老师分布 πt - Reverse KL:
D_KL(πθ||πt) - JS散度:Jensen Shannon Divergence
只在学生采样token上计算近似 KL, 基于教师打分器、Rubric或判别器构造的黑盒蒸馏目标
概要
训练流程
OPD 训练流程(4 阶段,左到右)
- ① Rollout 阶段:蓝色 数据集 → Student 模型(no_grad 自回归生成)→ Student Rollout ŷ
- ② Teacher 评估阶段:黄色 Teacher 模型(stop-grad)→ 对同一 rollout 逐 token 前向 → Teacher logits
- ③ Loss 计算阶段: 绿色 Student 带梯度前向 → Student logits → 两份 logits 逐 token 算散度 D(p_T ‖ p_S)
- ④ 参数更新阶段: 紫色 梯度回传(只更新 student)→ Optimizer → 更新后模型 → 红色虚线循环回 ①
理解
小模型后训练选 SFT 还是 RL ?
2025年10月,Thinking Machines Lab 的On-Policy Distillation 文章核心结论:
用RL”在策略采样”+蒸馏的”稠密反馈”,在推理任务上复现了Qwen3用RI才能达到的效果,成本却只是零头。
三种后训练区别:两个维度,采样是否 on-policy、奖励是否稠密:
- SFT (off-policy+稠密): 学老师轨迹,但学「老师常处的状态」,推理时自己一旦走偏会误差累积(compoundingerrorexposure bias)
- RL (on-policy+稀疏): 在自己轨迹上学,但一整条 rollout 只回传一个标量奖励,「每个 episode 只教固定比特」,token 利用率极低
- 【On-policy 蒸馏(on-policy+稠密)】: 在学生自己采样的轨迹上,让teacher对每个Token打分
| 训练模式 | 采样策略 | 奖励类型 | 核心逻辑 | 优势 | 局限 |
|---|---|---|---|---|---|
| SFT(监督微调) | off-policy(离线策略,仅学习专家轨迹) | 稠密奖励(逐Token提供监督信号) | 完全模仿老师/专家的输出轨迹,学习专家的Token生成逻辑与常出现的状态 | 训练过程稳定,Token利用率高,可快速对齐专家的行为与输出风格 | 仅覆盖专家常出现的状态,推理时模型一旦偏离专家轨迹,会出现误差累积(暴露偏差),泛化能力弱 |
| RL(强化学习) | on-policy(在线策略,在模型自身采样的轨迹上学习) | 稀疏奖励(单条轨迹仅提供1个标量奖励) | 基于模型自身采样的完整轨迹学习,仅在整条rollout结束后,回传最终的标量奖励信号 | 可探索模型自身的行为空间,适配推理时的真实输出分布,泛化能力强 | 单条轨迹仅能提供极少有效学习信号,Token利用率极低,训练过程不稳定,收敛难度大 |
| On-policy蒸馏 | on-policy(在线策略,在学生模型自身采样的轨迹上学习) | 稠密奖励(逐Token提供监督信号) | 在学生模型自身采样的轨迹上,由老师模型对每一个Token进行打分,提供逐Token的稠密监督信号 | 结合SFT的稠密监督与RL的在线探索优势,既适配模型自身的推理分布,又保持高Token利用率,训练更稳定 | 需要老师模型持续提供逐Token的打分,计算成本相对较高,最终效果强依赖于老师模型的质量 |
OPD vs offline KD
SFT、Offline KD、OPD 和 GRPO 核心区别并不在于模型结构,而在于训练状态(State Distribution)和监督信号(Supervision)。
- SFT 与 Offline KD 都属于 Off-Policy 方法,训练过程始终基于固定数据;
- OPD 与 GRPO 都属于 On-Policy 方法,训练数据来自 Student 当前策略生成的轨迹;
- Offline KD 与 OPD 的监督信号都是 Teacher 的概率分布,区别仅在于 Teacher 提供监督的状态不同;
- GRPO 不依赖 Teacher,而是根据 Reward 更新策略,更强调探索与策略优化。
| 方法 | 训练状态(Prefix) | 监督信号 | 优化目标 |
|---|---|---|---|
| SFT | 固定数据集(Ground Truth) | One-hot Label | 学习标注数据 |
| Offline KD | Teacher / 固定数据集 | Teacher Probability Distribution | 模仿 Teacher |
| OPD | Student 当前策略 | Teacher Probability Distribution | 在 Student 轨迹上迁移 Teacher 能力 |
| GRPO | Student 当前策略 | Reward | 优化当前策略 |
两个维度的组合:
- SFT:离策略+独热监督
- Offline KD:离策略+教师分布监督
- OPD:在策略+教师分布监督
- GRPO:在策略+奖励监督
| Off-Policy | On-Policy | |
|---|---|---|
| One-hot Supervision | SFT | —— |
| Teacher Distribution | Offline KD | OPD |
| Reward | —— | GRPO |
OPD 并不是一种新的损失函数,而是在保持 Teacher Distribution 监督的同时,将训练状态从 Teacher 轨迹切换到了 Student 自己的轨迹,从而缓解了 train–inference distribution mismatch。
OPD vs SFT
SFT(forward kl)与OPD(Reverse KL)本质区别
【2026-6-11】LLM后训练知识:从数学原理区分SFT与OPD
SFT(Supervised Fine-Tuning,监督微调) 和 OPD(On-Policy Distillation,同策略蒸馏 / 在线偏好蒸馏)是两种截然不同的训练范式。数学原理和目标函数上的根本区别,主要体现在数据状态分布的采样来源以及优化的散度(Divergence)类型上。
数学原理上
- SFT 是基于 离线静态数据、优化 前向 KL散度(寻求全面模仿) 的开环优化,存在训练和推理状态不一致的问题;
- 而 OPD 是基于 模型自生成动态数据、通常优化 反向 KL散度(寻求精准专精) 的闭环优化,通过让模型在“自己的失误”中接受教师的实时纠正,从根本上解决了长链条推理过程中的误差累积问题。
OPD vs RL
sft与rl之间是opd
新观点
【2026-6-8】港科大:OPD 并非 SFT 与 RLVR 的折中方案,而是具备独立特性的参数更新范式
SFT、RL、OPD 都在改变语言模型的“输出分布”;
真正决定模型会不会大幅遗忘的,不只是 loss 长什么样,而是训练数据是不是来自模型自己,也就是 on-policy。
把语言模型看成“序列上的概率分布”,后训练就是在重塑这个分布;
SFT、RL、OPD 差异在于: 目标分布是谁、数据从哪里来、梯度在哪里发力。
- SFT:给出示范答案,让模型往数据集答案拉, 因此产生
灾难性遗忘。- 例如模型学习时不管是否写作习惯风格token(therefore),还是答案,都要一视同仁
- SFT 目标: 作用于外部数据集上,而不是新任务相关的分布,因此泛化性也会变差,把自己的能力给忘了
- RL:让模型自己生成答案,通过reward打分,通过policy gradient提高期望奖励,这就相当于从当前模型自己采样的行为发出的,训练数据来自模型自己,学生自己做,通过reward自己修正自己写出的东西,从而在自己的路径下(符合自身分布前提下),把更好的路加粗。
- OPD:On-Policy Distillation 介于SFT和RL之间,就是学生生成样本,学生主导下,reverse KL 把学生的logits分布往老师的logits分布靠拢。
- 还是以学生和老师的例子,普通蒸馏下:老师生成答案,学生模仿老师答案,OPD的视角下,学生生成prefix,老师应该告诉学生下一步token的概率分布是什么样。
- 普通 SFT / hard token imitation 只学一个目标 token;传统 soft KD 本身是学老师的 token-level 分布。
- OPD 特别之处不是第一次学分布,而是在学生自己生成的状态上学老师分布,即:让学生走自己的路,但每一步让老师告诉它:在你现在这个位置,下一步应该更像什么分布。
SFT、RL、OPD 核心区别
| 维度 | SFT(监督微调) |
RL(强化学习) |
OPD(在线策略蒸馏) |
|---|---|---|---|
| 核心本质 | 用外部示范答案,强行将模型输出分布对齐外部数据集 | 模型生成样本,借助奖励函数优化自身输出分布 | 介于SFT与RL之间,模型生成前缀,再对齐教师模型的概率分布 |
| 训练数据来源 | 外部人工/标注数据集(非模型自身产出) | 模型自身采样生成(on-policy) | 模型自身生成前缀/样本(on-policy) |
| 优化方式 | 逐Token硬模仿,统一学习风格、答案等所有内容 | 策略梯度,最大化整体期望奖励 | 反向KL散度,对齐教师模型Token级概率分布 |
| 遗忘风险 | 易出现灾难性遗忘,原有能力丢失 | 遗忘风险低,在自身分布基础上优化 | 遗忘风险介于两者之间 |
| 泛化能力 | 偏向拟合固定数据集,泛化性变差 | 保留原有能力,泛化表现更优 | 兼顾模仿与原生分布,泛化能力中等 |
| 通俗理解 | 照着标准答案全盘模仿学习 | 自己做题,根据评分自主修正优化 | 自己先动笔走流程,每一步由老师指导最优方向 |
| 学习特点 | 仅学习单一目标Token(硬模仿) | 基于自身行为迭代,强化优质输出路径 | 在模型自身生成的状态下,学习教师的完整分布 |
OPD成败关键:思维对齐+新知识,非强教师
【2026-4-16】搞懂大模型在线蒸馏OPD:成败关键、底层机理与工程方案
- 论文:《Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Mechanism, and Recipe》
- 代码地址 OPD
核心创新点总结
- 首次系统揭示 OPD成败的两大必要条件(思维对齐+新知识),打破“强老师必成”的固有认知;
- 拆解OPD的token级底层机理,证明成功源于高概率token的渐进对齐,且97%–99%的收益集中在共享token;
- 提出两个可工程化的修复方案(离线冷启动、老师对齐提示词),直接解决OPD失败问题;
- 指出OPD的长文本局限,明确其适用边界,为未来混合蒸馏路线提供指导。
在线蒸馏OPD不是“越大越好”的暴力魔法,而是“思维对齐、知识增量、局部监督”的精细艺术。 想让小模型高效追上大模型,关键就3点:让老师和学生“同频”(思维对齐),让老师有“真东西”(新知识),让学生“精准学”(聚焦共享高概率token)。
【2026-6-5】港科大:OPD并非SFT和RLVR折中
在线策略蒸馏(OPD)是2026年热议的大模型后训练方案,训练动态机制仍缺乏清晰认知,大多被视作介于监督微调(SFT)与强化学习(RL)之间的黑盒技术。
【2026-6-5】港科大论文 On the Geometry of On-Policy Distillation
论文从参数几何维度刻画 OPD 对模型权重的改动规律,并提出观点:
OPD 并非 SFT 与带人类反馈的强化学习(RLVR)的折中方案,而是一种具备独立特性的参数更新范式。
- 更新权重数量更少: 相较于 SFT,OPD 仅更新极少数参数,且基本不会触及权重空间的主方向,这也是其样本利用率更高的核心原因。
- 子空间提前锁定: 训练初期,OPD 的累积更新会快速收敛至一个狭窄的低维子空间;而 SFT 的参数更新会分散到多个方向,二者形成明显差异。
- 该子空间具备完整有效功能: 将训练限定在 OPD 早期形成的子空间内,模型仍可保留原有性能;但该约束会严重损害 SFT 效果。这证明该小子空间确实承载了有效学习信息,并非训练产生的无效附属特征。
多组参数空间诊断实验
- OPD 处于弱偏离主方向的更新区间:相较于 SFT,OPD 的参数更新范围更小,且对权重主方向的规避程度更高;而对比 RLVR,其约束又相对宽松。
除上述静态分布特征外,OPD 还存在子空间锁定现象:累积参数更新会快速收敛至一个狭窄的低维通道。若将训练限定在模型早期形成的该更新子空间内,OPD 性能可基本维持,但会大幅破坏 SFT 的效果。这说明该锁定子空间足以承载 OPD 的有效学习信息。
对照实验结论:
- 对更新 token 做稀疏化处理、将模型推理生成改为离线策略,均不会改变秩动态特征;
- 但将 OPD 训练目标与 RLVR 融合后,该特征会发生明显变化。
研究价值
- 厘清 OPD 在权重空间中的作用区域,让这项应用广泛却原理模糊的训练方案形成机理解释。
- 这有助于研究者理解其内在逻辑、将与其他训练目标组合优化,并实现定向迭代改进,摆脱以往试错式调优的研发模式
工程实现
【2026-9-16】蒸馏学习 OPD / OPSD 用什么框架?
- 首次验证 OPSD,ms-swift 仍是最省事的选择;
- 同词表模型的大规模 OPD 优先考虑 verl;
- 常规单教师 OPD 直接用已经稳定的 TRL DistillationTrainer;
-
在线与离线混合时使用 GKDTrainer,跨 tokenizer 则使用 GOLDTrainer,但后两者仍需承担实验 API 变动的风险。
- verl 的大规模 OPD 系统设计最完整
- ms-swift 的 OPD/OPSD 开箱体验更全面
- TRL 已经提供稳定的单教师 OPD 接口,跨 tokenizer 蒸馏也有专门的实验实现。
| 场景 | 建议框架 | 当前情况 |
|---|---|---|
| 大规模、多机 OPD | verl | 教师资源池和多教师能力完整 |
| OPSD 快速验证 | ms-swift | 有直接的 OPSD 数据与训练入口 |
| 常规单教师 OPD | TRL DistillationTrainer | 已进入稳定 API |
| 在线/离线混合 GKD | TRL GKDTrainer | 功能完整,但仍属实验接口 |
| 跨 tokenizer 蒸馏 | TRL GOLDTrainer | 有官方实现,仍属实验接口 |
| 论文精确复现 | 作者仓库 | 适合对齐论文,不宜直接视为生产框架 |
支持OPD的开源框架
- MS-swift GKD
- 支持 OPD,包括top-k和全词表形式
- 支持 部署好的教师模型服务,通过api调用
- 支持 OPSD 方法,实现模型自蒸馏
- Verl async-on-policy-distill
- 支持 OPD,包括top-k和全词表形式
- 支持部署好的教师模型服务,通过api调用
- Slime 框架
案例:双阶段 SFT 与 OPD:
- 以 Qwen3.5-35B-A3B 为基座,构建覆盖轨迹补全、异常清洗和场景均衡采样的训练数据流,并完成双阶段 SFT,BFCL_v3 最高达到 0.7149;
- 基于 Slimme 框架,以 Qwen3.5-397B-A17B 为 Teacher、双阶段 SFT 模型为 Student 开展 On-Policy Distillation,将 BFCL_v3 从 0.7113 提升至 0.7178
GKD 通常用参数 β 选择散度方向:
- β=0 对应 forward KL,即
KL(πt||πθ) - β=1 对应 reverse KL,即
KL(πθ||πt) - 中间值 对应广义 JSD。
- 注意: 不同训练器的默认值并不一致
VeRL
VeRL 已提供独立的 OPD 配置和训练流程。
原生实现两条路线
- GKD OPD 在 top-k 教师 logits 上直接反传 forward KL
- PG OPD 把 reverse KL 的估计当作 reward 走策略梯度更新。
损失的选择主要通过 loss_mode 完成,可选 k1、k2、k3、low_var_kl、abs、mse 等若干种单样本 KL 估计,而不是暴露一个 beta 系数。
配置分三层命名空间,distillation.* 管顶层开关和教师资源池,distillation.teacher_models.
教师必须和学生共享 tokenizer 和词表,这一条写在文档里,实际操作中基本只能同族配对,比如 Qwen3-32B 教 Qwen3-8B,跨词表的需求 verl 不覆盖。
ms-SWIFT
ms-swift 目前是跑 OPSD 最省事的通用框架,OPSD 在这里已经是官方入口,不需要自己动损失函数。
蒸馏能力按 rlhf_type 分成两条基线,–rlhf_type gkd 把教师散度作为损失直接反向传播,–rlhf_type grpo 配合教师则是 OPD-RL,教师信号注入 GRPO 的 per-token advantage。OPSD 建在这两条之上,靠 teacher_prompt 和 teacher_images 给教师侧传入特权信息,前者是文本(参考解答之类),后者是图片,可以单独用也可以一起用。
自教师分两种模式,区别只在于传不传参数:不传 –teacher_model 是动态自教师,教师权重跟随训练同步更新;把 –teacher_model 指成和 –model 同一个路径则是固定自教师,用的是初始权重。教师来源上,本地模型走 –teacher_model,外部服务走 –teacher_model_server 接 vLLM,多教师用 JSON 配置按数据源或样本级别路由,分布式侧有 Megatron 和 Ray 的参考脚本。
几个默认值:–beta 默认 0.5 控制散度类型,–lmbda 默认 0.5 控制在线采样概率,–gkd_logits_topk 默认 None 但走 API 教师时必须填,–teacher_kl_coef 默认 1.0 控制教师信号强度。
TRL
TRL 同时保留稳定入口和实验入口。
- TRL DistillationTrainer
- TRL GKDTrainer
- TRL GOLDTrainer
新版 DistillationTrainer 已进入稳定 API,from trl import DistillationTrainer 即可,专门执行完全在线的单教师 OPD:学生在每一步生成 completion,再通过分块计算的广义 JSD 对齐教师分布。它不再提供 lmbda,beta 默认值为 1.0,也就是默认走 reverse KL。生成侧可以接 vLLM,colocate 和 server 两种模式都支持;把生成与训练解耦、教师通过 HTTP 服务打分的场景交给 AsyncDistillationTrainer。
如果需要混合在线与离线数据,应继续使用实验模块中的 GKDTrainer。该训练器保留 lmbda:0 表示离线的监督式 JSD,1 表示完全在线,中间值按批次混合,beta 默认 0.5。跨 tokenizer 蒸馏则由实验模块中的 GOLDTrainer(General Online Logit Distillation)提供。SDFT、SDPO、SSD 等自蒸馏方法也有独立实现,但不能把它们直接等同于原始 OPSD。
实验模块的共同前提是 API 可能不经通知就发生变化,官方文档在页面顶部挂了提示,选用前需要把这部分风险算进去。
改进
opd综述: 【OPD综述】三万字长文精讲 2026 上半年的 On-Policy Distillation
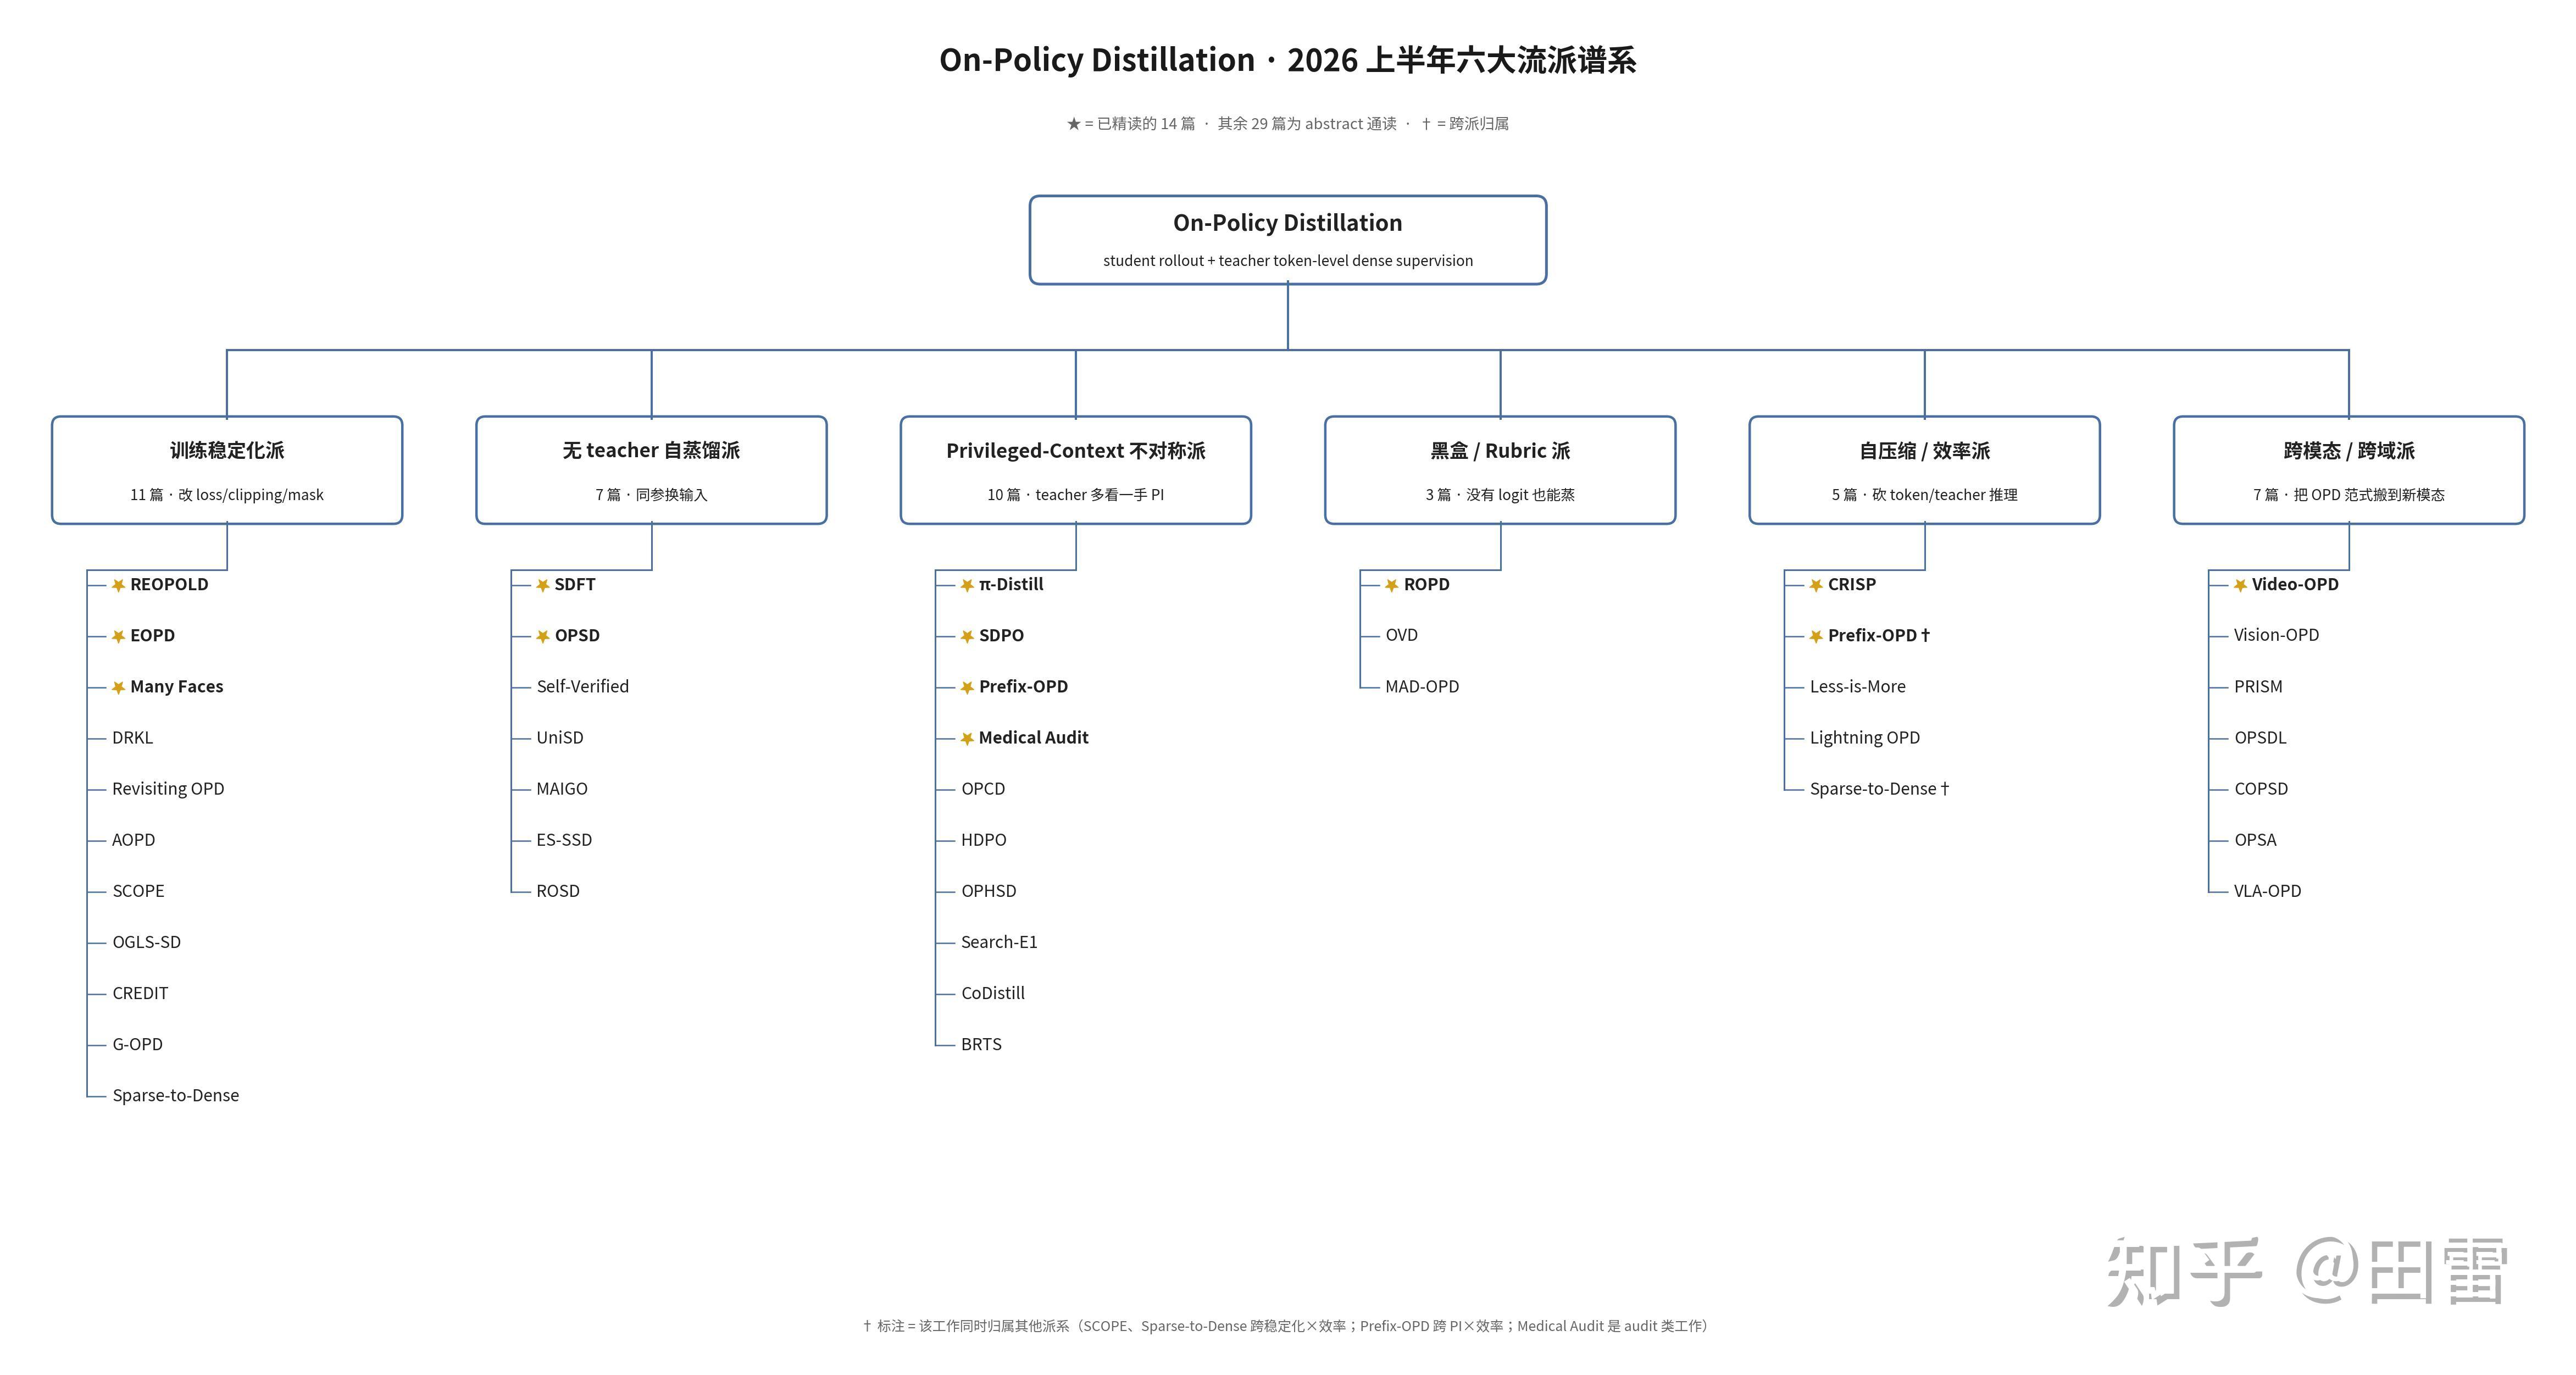
| 派别 | 论文数 | 核心特点 | 方法/模型 |
|---|---|---|---|
| 训练稳定化派 | 11 | 改 loss / clipping / mask | REOPOLD, EOPDD, Many Faces, DRKL, Revisiting OPD, AOPD, SCOPE, OGLS-SD, CREDIT, G-OPD, Sparse-to-Dense |
| 无teacher自蒸馏派 | 7 | 同参换输入 | SDFT, OPSD, Self-Verified, UniSD, MAIGO, ES-SSD, ROSD |
| Privileged-Context不对称派 | 10 | teacher 多看一手 PI | π-Distill, SDPO, Prefix-OPD, Medical Audit, OPCD, HDPO, OPHSD, Search-E1, CoDistill, BRTS |
| 黑盒/Rubric派 | 3 | 没有 logit 也能蒸 | ROPD, OVD, MAD-OPD |
| 自压缩/效率派 | 5 | 砍 token / teacher 推理 | CRISP, Prefix-OPD†, Less-is-More, Lightning OPD, Sparse-to-Dense† |
| 跨模态/跨域派 | 7 | 把 OPD 范式搬到新模态 | Video-OPD, Vision-OPD, PRISM, OPSDL, COPSD, OPSA, VLA-OPD |
黑盒蒸馏
大模型蒸馏过去有个默认前提: teacher 必须是白盒。要拿到 logits、hidden states 或者至少 tokenizer 能对齐,才能把『正确答案的分布』传给学生。
但现实是,最强的那批模型往往是黑盒 API:只给文本输出,不给概率。这就把 On-Policy Distillation(OPD,同策略蒸馏)卡在了开源世界。
【2026-9-*】新国立+中科大+腾讯:ROPD
【2026-9-22】ROPD:用「评分准则」做黑盒蒸馏, 跨模型也可以做OPD了
新加坡国立大学、中国科学技术大学与腾讯提出 ROPD(Rubric-based On-Policy Distillation)换了一条路——用结构化的语义评分准则(rubrics)替代 teacher logits,让学生在黑盒 teacher 的文本反馈下做 on-policy 训练。
结果出人意料:在黑盒场景全面领先,在白盒场景也比当前最先进的 logit-based OPD 更强,样本效率最高提升 10 倍。
ROPD 整体流程:
- Rubricator 从 teacher-student 对比中诱导 prompt-specific rubrics,Verifier 按 rubrics 为学生 rollout 打分并用于 GRPO 优化。
局限
ROPD 并不是万能方案,边界:
- Verifier 开销。每条 rollout 要逐条 rubric 调用 verifier,虽然 teacher 可离线,但生成 rubrics 和打分本身有额外 token 消耗。
- 准则质量上限。如果任务本身很难用明确二值准则描述(如开放式创意写作),rubric 的区分度会下降。
- 奖励粒度:Rubric reward 是响应级而非 token 级,无法做 step-dense 的 credit assignment,适合答案可结构化评估的任务。
因此 ROPD 最适合:数学、科学、医疗问答、代码验证、指令遵循等答案可分解为若干检查项的推理任务。
性能
【2026-5-13】USTC和腾讯混元 EffOPD
【2026-5-13】USTC和腾讯混元 推出
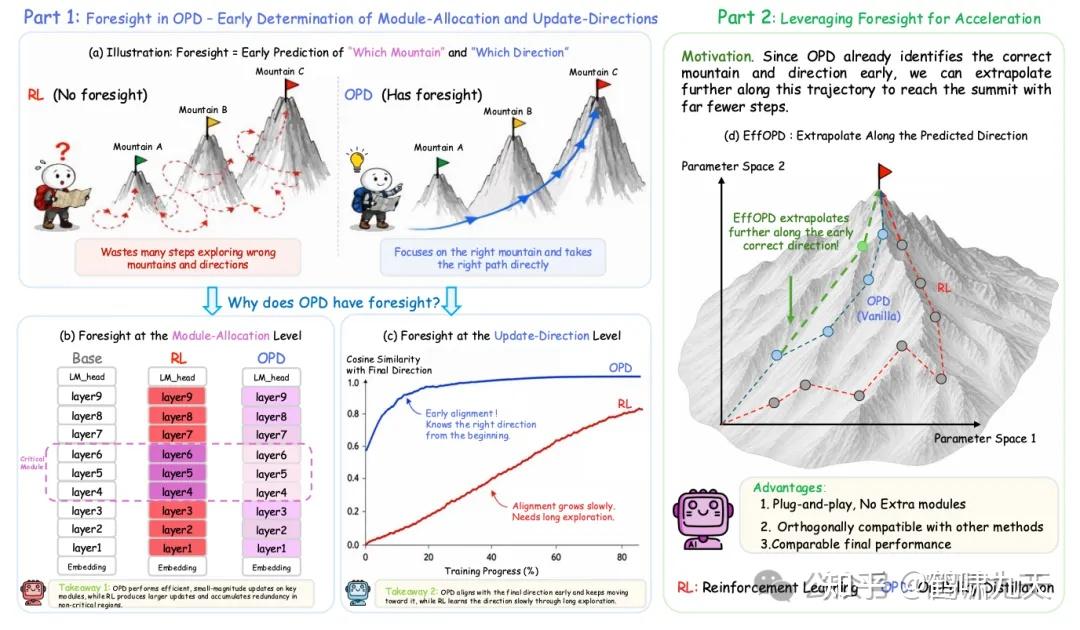
在线策略蒸馏(OPD)已成为大语言模型一种高效的后训练范式。但现有研究大多将其性能优势归因于更稠密、更稳定的监督信号,对于OPD高效性背后的参数层级内在机理,目前仍缺乏清晰认知。
本文研究发现:OPD 高效本质来源于一种“前瞻特性(foresight)”——它能在训练早期就建立起指向最终收敛模型的稳定参数更新轨迹。主要体现在两个维度:
- 模块分配层面:OPD可自动识别模型中边际增益较低的参数区域,将参数更新资源集中投入到对推理能力更关键的核心模块;
- 更新方向层面:OPD具备更强的低秩收敛特性,训练早期的主导参数子空间,就能与模型最终收敛的更新子空间高度对齐。
基于上述机理发现,本文提出 EffOPD,即插即用的OPD加速优化方法。
通过自适应选取外推步长、沿当前最优更新方向迭代参数,实现训练加速。EffOPD无需新增可训练模块、无需复杂超参调优,在保证模型最终性能持平的前提下,平均训练速度提升3倍。
综上,从参数动力学视角揭示了OPD高效训练的底层原理,为大语言模型设计更高效的后训练算法提供了全新的理论依据与工程实践思路。
【2026-6-17】三星中国研究院 TrOPD
【2026-6-17】三星中国研究院、牛津、北大提出 TrOPD 信赖域在策略蒸馏方法 TrOPD(Trust Region On-Policy Distillation)
在策略蒸馏(OPD) 问题
但当教师模型与学生模型的数据分布存在显著差异时,OPD训练会出现不稳定问题:
- 对学生模型自主生成的token施加教师监督信号,可能产生不可靠的策略梯度,甚至造成优化失败。
通过信用分配机制实现可靠的逐token在策略监督,提出信赖域在策略蒸馏方法 TrOPD(Trust Region On-Policy Distillation),具备三大核心特性:
- 信赖域在策略学习:仅在教师监督信号可靠的区域执行OPD训练,缓解分布失配场景下反向KL散度估计器(K1)的优化难题。
- 异常样本约束:针对异常分布区域,采用梯度裁剪、掩码过滤、前向KL散度估计等手段,降低不可靠监督信号带来的负面影响。
- 离策略引导:以教师模型生成的前缀文本作为上下文继续生成内容,并利用前向KL散度学习离策略监督信息,引导在策略探索偏向可靠分布区域。
实验结果
- 在数学推理、代码生成及通用领域评测基准上,TrOPD 整体优于现有主流OPD基线方法(OPD、EOPD、REOPOLD)。项目开源主页详见GitHub。
【2026-7-6】微软+港科大 TOP-D
微软和港科广新论文,把当下 LLM 后训练最主流的在线策略蒸馏(OPD)身上最出名的毛病——训练不稳定——追到了公式层面的根源,再用一行代数变换把它修掉。方法叫 TOP-D(信赖域策略蒸馏)
- 论文 Trust Region Policy Distillation
- 8B 学生在 AIME24 上从标准 OPD 的 24.58 分拉到 50.42 分,计算开销一点没加。
OPD 走红原因:
- 学生自己写答案、老师逐 token 打分,信号密集又不易遗忘,Qwen3、DeepSeek-V4、GLM-5 的后训练都在用。
但奖励是老师与学生概率之比的对数,一旦老师认为学生采出的某个 token 几乎不可能,这个对数就冲向负无穷——单个 token 的惩罚足以主导整批梯度。
- 此前的补丁(奖励裁剪、混合采样、全词表监督)都是经验性技巧,论文认为它们没有触到「无界惩罚」这个根。
TOP-D 切法分两步。
- 第一步,每次更新前把老师和当前学生按 α:(1−α) 混成一位「近端教师」,学生永远只追一个够得着的目标;代回公式后,这个概念上的教师塌缩成对奖励的一次代数变换 log(αρ+1−α),天然有下界,负无穷从此消失。
- 第二步,借鉴 PPO 把采样策略与更新策略解耦,同一批数据安全地分 16 个 mini-batch 反复用,把样本效率一并补上。理论侧,方差上界、全局收敛、单调改进三个定理互相咬合:α 是方差的直接调节器,而收敛差距 ε∞/α 的缺口恰好由内部迭代补齐。
结果相当全面:
- Qwen3-8B-Base 配 30B-A3B 老师,六个数学基准全部第一,AIME24 上比最强 RLVR 基线 DAPO 还高 17.5 个百分点;
- 学生缩到 1.7B、师生差距拉大时,标准 OPD 反而落后 GRPO 与 DAPO,TOP-D 依旧领先,与理论预测吻合。
- 消融显示两个组件缺一不可,α 在 0.1 到 0.3 之间怎么选都差不多,不需要调参。
局限:
- 验证止步于 8B 学生,训练窗口只有约 200–400 步——但也正因如此,作者说正文报告的数字远未到上限。
多教师
单教师存在能力天花板;
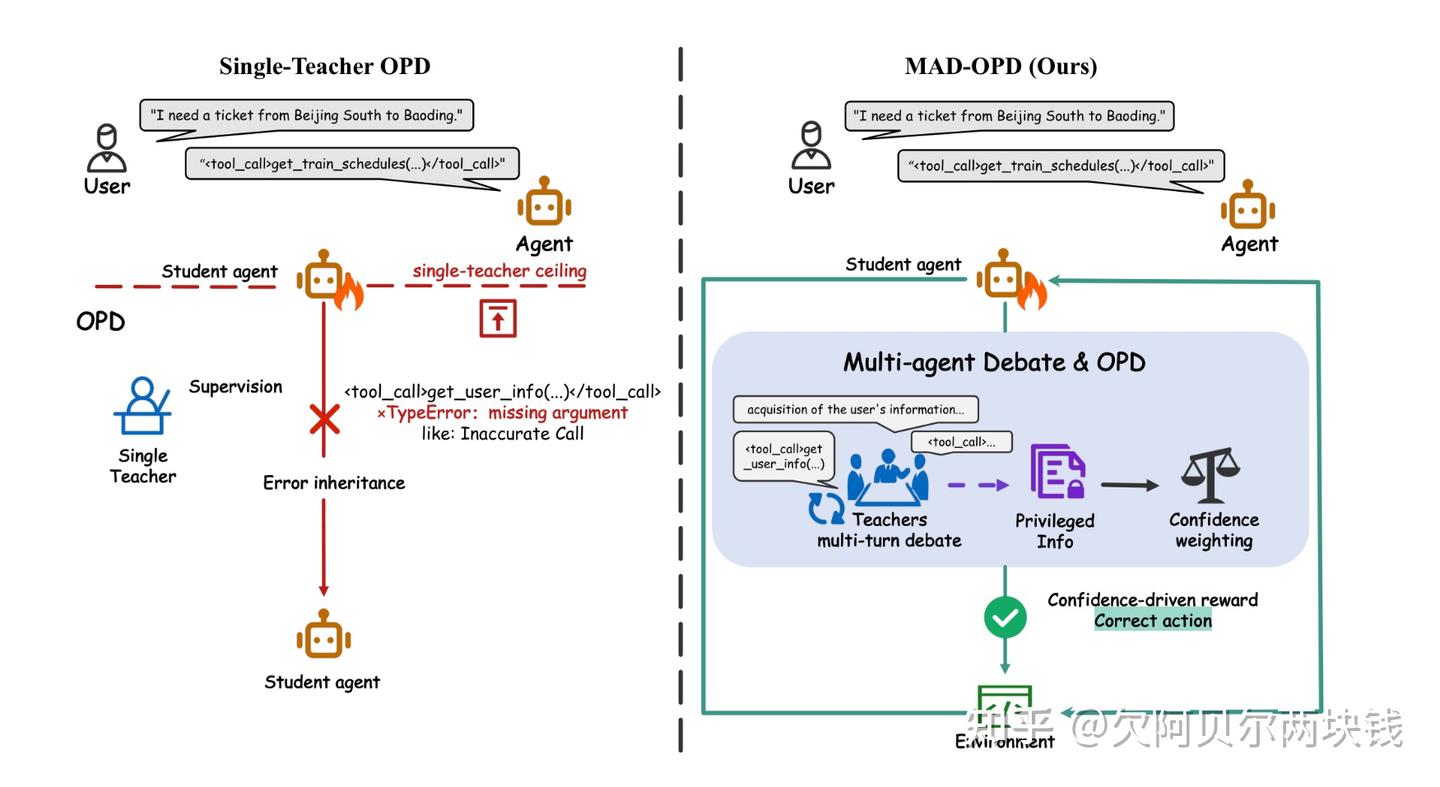
【2026-5-2】华科+阿里 MAD-OPD
但现有方法受限于
- 单教师能力上限:一旦教师模型出错,学生模型就会继承该错误。
- 智能体任务中的研究仍较为匮乏 —— 这类任务里,单步误差会沿着长轨迹不断累积,造成训练失稳。
【2026-5-2】华科+阿里提出 MAD-OPD,引入多智能体辩论生成集体监督信号;
MAD-OPD(多智能体辩论驱动的在线策略蒸馏)。重新定义蒸馏教师,将其改造为具备思辨能力的教师群体,针对学生模型的在线策略状态开展辩论;
- 辩论过程会涌现出群体智能,以此提供词元级监督信号,每位教师的输出权重由辩论结束后的置信度决定。
为将 OPD 拓展至智能体任务,进一步提出 在线策略智能体蒸馏(OPAD),增加步级采样机制,缓解多步误差累积问题,稳定训练过程。
此外,推导了任务自适应散度准则:针对智能体任务选用 JSD(詹森 - 香农散度)保障稳定性,代码生成任务选用反向 KL散度,并从理论与实验两方面验证了该准则。
效果
- 6 组师生模型配置(Qwen3、Qwen3.5;学生模型规模 1.7B–14B,教师模型规模 8B–32B)以及 5 项智能体、代码基准测试中,MAD-OPD 在全部 6 组配置下均取得最优结果。
- 14B 教师 + 8B 教师→4B 学生的实验设置中,相比更强的单教师 OPD 基线,智能体任务平均指标提升 2.4%,代码任务平均指标提升 3.7%。
4B学生可以超过14B原始教师;
- 面向复杂Agent多步任务;
- 解决单教师上限问题。
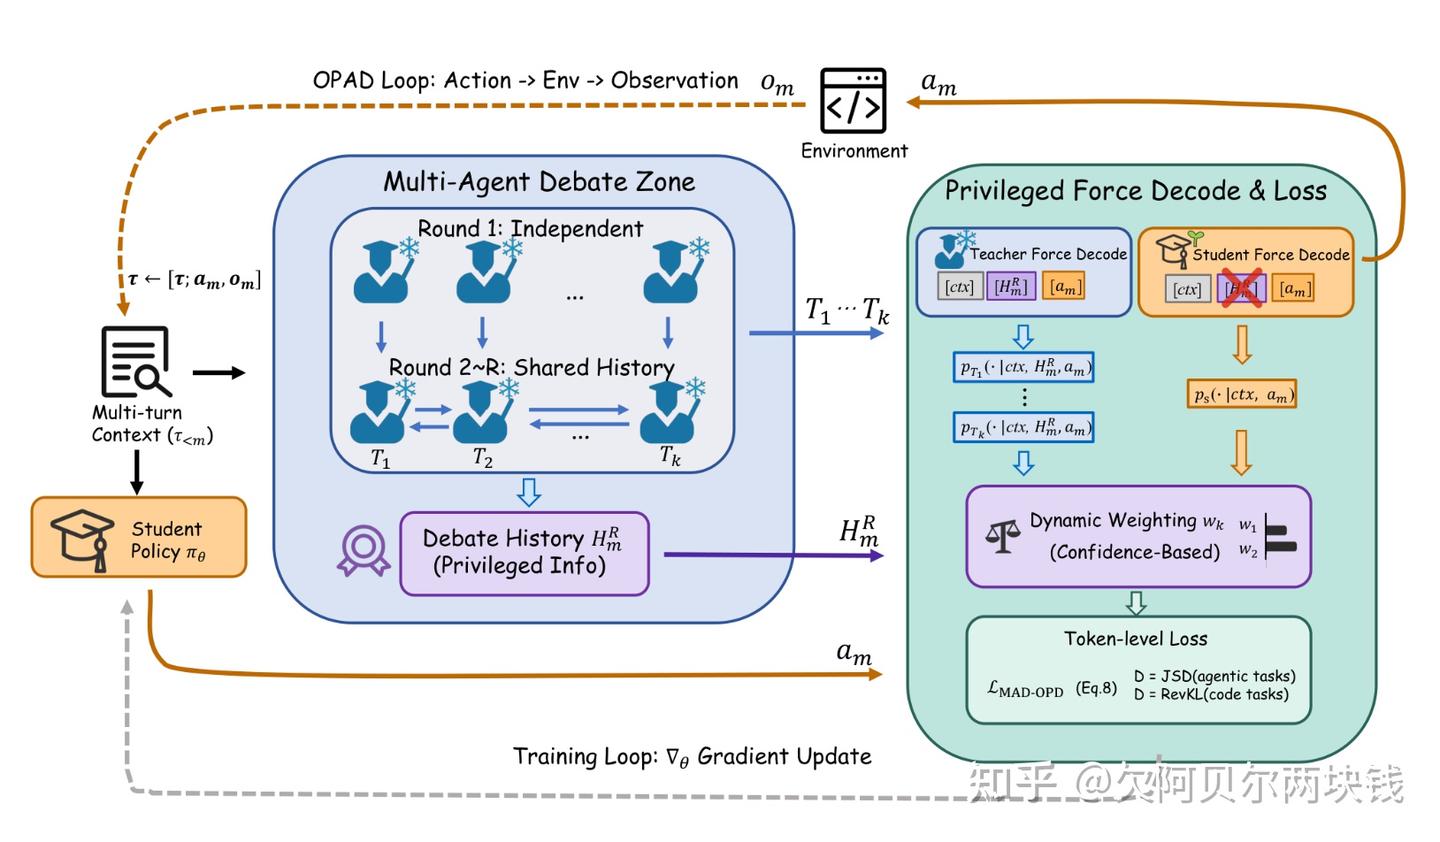
MAD‑OPD 流程。
- 在轨迹第m步,学生策略采样一个同策略动作;
- K个教师开展R轮辩论,生成仅教师可见的辩论记录,构建特权间隙。
- 随后教师强制解码,计算置信度加权散度D(智能体任务使用 JSD,代码任务使用反向 KL 散度;
- 梯度仅更新学生策略。
- 虚线框代表 OPAD 外层循环,环境在此输出下一步观测
【2026-6-29】北大、小米 MOPD
MOPD:多Teacher蒸馏实现能力整合
小米罗福莉解决大模型多专家融合难题
问题:强化学习后训练中极易产生“跷跷板效应”与多领域能力融合瓶颈
LLM 后训练的核心难题:
数学、代码、指令遵循各有最佳 RL recipe,但最终要一个模型全干好。
现有方案
- Mix-RL 跨域干扰跷跷板
- Cascade RL 前域衰减
- Off-Policy FT 有 exposure bias
- Param-Merge 权重融合不稳定。
没有一个令人满意。
【2026-6-29】小米提出“多教师同策略蒸馏(MOPD)”新范式。
巧妙实现工程解耦,允许不同团队基于统一基座并行训练专属领域专家,随后在核心蒸馏阶段,让学生模型自主生成数据(消除曝光偏差),并由各领域专家进行Token级密集概率打分指导。
基于严格的“初始模型同源”机制,MOPD 不仅克服了传统参数合并带来的灾难性遗忘,更在高达3000亿参数的工业级模型上完美实现了所有专家能力的无损吸收,成功打造出各领域表现全面顶尖的“全能大模型”。
MOPD 思路:
- 在 policy space 而非 weight/dataset space 做整合。
- 三阶段 共享 SFT → 各域并行 RL 出专家 → 冻结专家,student 自己 rollout,按 prompt 路由到对应域 teacher,teacher 在 rollout 每个 token 上提供 log-prob,student 最小化 reverse KL。域间零干扰、无 exposure bias、dense per-token 监督。
Qwen3-30B-A3B 上 norm score 0.937,超次优 Mix-RL +5.5,三域 range 仅 0.044(Cascade RL 0.41)。样本效率远超 Mix-RL:IF 域 25K vs 150K 达 teacher 水平。已落地 MiMo-V2-Flash 309B,匹配或超越各域 teacher。
非对称
OPD 优势加权策略梯度存在三项结构性缺陷:
- 更新方差大
- 优势值为零区域出现梯度消失
- 校正信号不足时产生探索瓶颈。
【2026-5-7】华科+美团 AOPD
【2026-5-7】华科+美团提出AOPD
非对称在线策略蒸馏(AOPD):在保留正向强化学习的同时,对于非正优势区域,用局部散度最小化替代效果不佳的负向强化。
数学推理基准测试上的实验表明:
- AOPD 稳定优于标准 OPD;
- 在强初始化、弱初始化条件下,平均性能提升分别为 4.09、8.34。AOPD 在训练过程中还能维持更高的策略熵,并且在顺序工具调用适配阶段拥有更好的能力保留效果。
对比: AOPD 最佳
- 2016年的 SeqKD
- 2024年的 GKD
- 2025年的 OPD
- 2026年的 Ex-OPD
自蒸馏:教师/学生合并
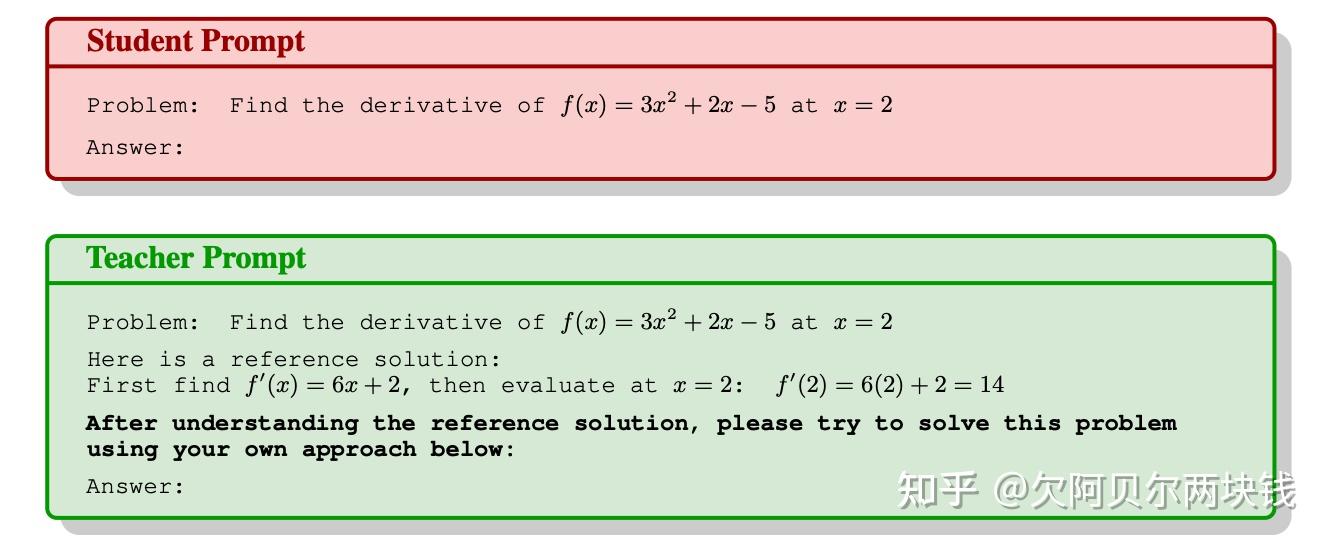
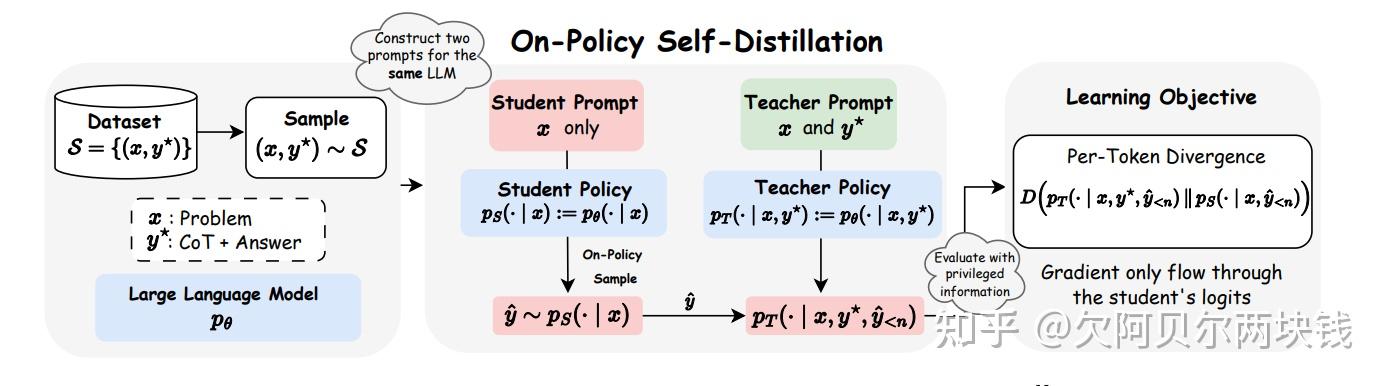
同策略自蒸馏(OPSD)训练单个模型同时扮演学生和教师两种角色,通过条件化于不同上下文来实现:
- 学生: 只输入问题(推理时真实条件) 用自身做老师,完成on‑policy自蒸馏,脱离外部大模型依赖。
- 教师: 额外看到标准答案, 输入问题+ground‑truth 参考答案作为特权信息
- 然后, 学生自身采样的同策略轨迹上,进行逐 token 分布匹配。
同一个 LLM 分饰师生
- 看 问题+正确答案 y* 时, “教师”(rationalization 比生成容易)
- 只看问题时,”学生”。
学生自己采样 rollout,教师在该 rollout 上逐 token 给出概率分布,最小化两者分歧。
问题
【2026-10-01】OPSD 不能凭空造出模型原本不具备的能力,依赖条件:
- 同一个模型在拿到 privileged information 之后,输出质量要明显好于普通条件。
- 如果模型看到了正确答案仍然写不出像样的推理过程,那么 teacher 分支的分布本身就不够好,蒸馏的上限会很低。
OPD vs OPSD
OPSD 指模型利用自身内部的不对称性来构建训练信号。通过特权信息(PI) 创造不对称性,即在训练时能够访问推理时不可用的上下文。
将同一模型以额外上下文为条件,会产生一个更强的策略,能够监督无条件的版本,从而将单个网络同时转变为教师和学生。
主要区别:PI由什么扮演,这几种:
- (1)用标准答案作为PI
- (2)通过源文档等上下文作为PI
- (3)将失败轨迹本身作为负面PI
- (4)利用弱外部评论家生成评论作为PI
- (5)利用rollout的多样性作为PI
- (6)利用事后可得的反馈作为PI
这是OPSD与OPD最大的不同。
【2026-3-20】UCLA OPSD
【2026-8-20】ucla、港大和META 推出 OPSD
知识蒸馏通过压缩大语言模型(LLM)教师模型的知识来训练小规模 LLM,提升大语言模型的推理能力。
在线策略蒸馏(On-policy distillation) 改进:由学生模型自行采样推理轨迹,同时教师 LLM 提供细粒度的 token 级监督,解决离线策略蒸馏方法中训练与推理之间存在分布不匹配的问题。
但在线策略蒸馏需要独立、规模更大的教师 LLM,并且不会显式利用推理数据集中已有的真实标准答案。
启发:强 LLM 对外部的特权推理轨迹进行逻辑推导,并向弱模型传授知识,本文提出在线策略自蒸馏(On-Policy SelfDistillation, OPSD)学习算法,单个 LLM 在不同上下文下同时充当教师与学生:
- 教师策略可以获取特权信息(例如经过验证的推理轨迹);
- 学生策略仅能看到问题本身;
训练目标: 最小化学生模型自主生成序列上,两个模型输出分布在每个 token 上的散度。
多个数学推理基准任务上验证了该方法的有效性。相比强化学习方法,OPSD 具备更优的 token 使用效率;相比离线蒸馏方法,OPSD 取得了更好的性能。
AIME 2024 Qwen3-8B 上,相对于 GRPO 提升 1pp,采样 token 量仅为 GRPO 的 1/4 到 1/8
| Base | SFT | GRPO | OPSD |
|---|---|---|---|
| 51.5% | 76.3% | 76.7% | 77.5% |
token 效率这么高?
- GRPO 每个问题要采样 G 个回答(如 8 个),且全对/全错时梯度为零、白采样。
- OPSD 只采 1 个 rollout,每个 token 位置都有 teacher 密集梯度信号——”每一滴信息都榨干了”。
局限
- 依赖 ground-truth 答案:数据集必须有 y*,无答案的场景不适用
- Teacher 质量受限于模型能力:模型太弱时”看了答案也 rationalize 不好”,教师信号质量低
- 显存仍高于 SFT:需要 student rollout + teacher 前向,两次前向传播
- 适用任务窄:实验仅在数学推理验证,代码/开放域生成未验证
- 固定 teacher vs 更新 teacher:主实验用 LoRA 固定 teacher(step 0),不固定会不稳定——说明自蒸馏有动态范围限制
- 准确率提升幅度小:vs GRPO 不到 1 个百分点,核心优势在效率而非绝对效果
- 单 seed 评估:作者承认只用单 seed,多 seed 结果可能有波动
【2026-5-26】D-OPSD
D-OPSD 把 LLM 的 OPSD 范式迁移到扩散模型,用”同一模型的不同上下文”替代”外部教师”,在 student 自己的 rollout 上做自蒸馏——既学了新知识,又不破坏少步推理。这是少步扩散模型持续微调的一个新范式,尤其适合只有图文对、没有 reward 的社区开发者。
【2026-5-26】D-OPSD: 扩散模型的自策略自蒸馏
背景:当前高性能图像生成模型正从多步推理(几十步去噪)转向少步推理(如 Z-Image-Turbo 4步、FLUX.2-klein)。这些模型通过 step-distillation 技术压缩步数,质量甚至超过多步模型。
问题:少步模型在部署后,开发者想用新的图文对继续微调(学新概念/风格),却发现传统 SFT 会破坏少步推理能力——训练后模型生成质量严重下降。
根因:传统 SFT 把目标图像加噪后输入模型做监督(off-policy)。但少步模型的推理轨迹是精心蒸馏出的特殊动力学路径,训练时用的”加噪目标图”状态 不在模型自己的推理轨迹上——这种 train-inference 状态不一致 会扰乱已学好的少步动力学。
核心矛盾:
- Off-policy SFT 能学新概念但破坏少步能力;
- Online RL 保持少步能力但需要设计 reward function——社区开发者通常只有图文对,没有 reward。
- D-OPSD 要同时满足:on-policy + 有监督 + 无需 reward。
把 LLM 里的 OPSD(On-Policy Self-Distillation)迁移到扩散模型。
- LLM 中,OPSD 让模型在自身生成的序列上学习,用更强上下文的自己作为教师指导更弱上下文的自己。
关键挑战:扩散模型里怎么构建”更强上下文”而不改变学生的推理轨迹?
- 通过 LLM/VLM 编码器的多模态特征。目标图信息走编码器通道注入(作为 teacher 的条件),而非直接加噪喂入去噪过程(那会变成 off-policy SFT)。学生的 rollout 轨迹完全不变。
不要老师
质疑:OPD 中教师对学生采样的轨迹打分,但对教师是 off-policy —— 教师根本不会生成这种轨迹。
那这种”陌生状态”下给出的监督可靠吗?
【2026-8-27】阿里+清华 Self-OPD 文生图
【2026-8-27】阿里淘宝、清华提出 Self-OPD:去掉教师机的流匹配模型 On-Policy 蒸馏
Flow Matching(FM)模型通过学习一条从噪声到数据的连续速度场,已经成为高质量文生图的主流骨架(SD3、FLUX 等都属此类)。但生成质量好并不等于对齐做得好——文本渲染、组合正确性、人类偏好这类下游目标,往往需要额外的后训练才能搞定。
现有的两类后训练方案都各有痛点。
- 第一类是直接用 RL 把去噪过程当成序列决策——Flow-GRPO、DiffusionNFT、GRPO-Guard 等都属于这一类。它的一大限制是奖励只有”终态”才有(完整去噪到一张图后才能打分),需要把一个终态奖励反向传播到几十步去噪过程中的每一步。这就带来了高方差梯度,多目标对齐时还容易出现”跷跷板”——把美学分拉上去,文本正确性就掉下来。
- 第二类是On-Policy Distillation(OPD)——Flow-OPD、DiffusionOPD 等。它用一个预训练好的、专门针对某任务的教师模型在每一步给学生提供稠密的 MSE 监督信号(教师速度 → 学生速度),训练稳定、样本效率高。但它把瓶颈换到了教师上:每加一个新目标就要重新训一个专门教师;学生被教师的质量和偏差”封顶”;多个目标时只能让多个教师在场空间里路由融合(field-level fusion),不同教师的梯度方向相互冲突。
核心问题:能否既保留 OPD 那种稠密的逐步监督,又完全不要外部教师?
Self-OPD 答案:
- 用学生自己的 SDE 局部探索 + 自身的 ODE 自参考基线来产生逐步的稠密监督信号,奖励只在分支排序时使用,不进入梯度,从而也顺便解决了多目标对齐时的梯度冲突。
【2026-8-31】普渡大学 OPSA 同策略自适应
核心质疑
- OPD 效果到底来自”教师蒸馏”还是”自我改进”?如果是自我改进,教师就是多余的
OPD 归因分析:
| 分类 | 发现/结论 | 具体内容 |
|---|---|---|
| 发现1 | 教师噪声大, 教师越大,噪声越多 | 4B教师噪声率 30.6%; 235B教师噪声率 50.6%; |
| 发现2 | 学生对噪声无感, 噪声去不去,效果一样 | 只训噪声样本 = 标准OPD; 去掉噪声样本 = 标准OPD; |
| 发现3 | 真正有效的 token, 教师只是”给低概率 token 打分” | 学习集中在低 log-prob token; 固定负 advantage = 教师效果; |
| 结论 | OPD 没在蒸馏 | 效果来自压制低概率 token; |
思路:不需要教师,不需要 reward;→ 提出 OPSA
同策略蒸馏(On-policy distillation,OPD)提供密集的 token 级监督,作为可验证奖励强化学习(RLVR)所具有的稀疏结果级优势的一种替代方案。
然而,教师模型是在给学生模型自身生成的轨迹打分,而这些轨迹对教师模型而言是异策略,这使得其监督信号的可靠性,即学生提升的真正来源,仍不清晰。
【2026-8-31】普渡大学对 OPD 训练过程中的教师模型监督进行定量分析,发现其中存在大量噪声,且比例随教师模型规模增大而增加。令人惊讶的是,学生模型策略对这些噪声并不敏感,无论是否保留噪声监督,最终都会收敛到相近的性能。
围绕 OPD 究竟在多大程度上实现蒸馏这一问题,分析了其性能提升的驱动因素,发现学习主要集中在低对数概率的 token 上,且使用单一固定的负优势即可达到与教师模型提供的负优势相当的性能。
OPD 作用:
抑制低对数概率 token,而这一点并不需要教师模型参与。
“同策略自适应”(On-Policy Self-Adaptation,OPSA)使用熵自适应负优势的无监督学习方法,将更强的学习信号分配给高熵位置,抑制 tail token,并将概率质量在 head token 之间均匀重新分配。
- 只用当前策略自身的 token probability 和 entropy 进行无需 teacher 的 on-policy 训练。
- OPSA 不需要 teacher model、reward model、reference-model forward 或 task reward。Canonical 配置只训练有效 response token 中 actor log probability 最低的 20%,并根据 entropy 分配 -0.5 到 -1.0 的 negative advantage。 其余 token 全部从 policy loss 中排除。
- 论文 DOES ON-POLICY DISTILLATION REALLY DISTILL? FROM NOISY TEACHER TO SELF-IMPROVEMENT
- 代码 On-Policy-Self-Adaptation 文档 中文README_zh
典型OPD方法对比

与基础模型 Qwen3-1.7B 相比,OPSA 在 AIME24 上把 Avg@32 提升了 35.41 分,对应 263% 相对提升,并在全部 3 个基准上把 Pass@32 提升了一倍以上,在 AIME24 的 Avg@32 分数上也比 OPD 高出 16.77 分。
训练代码
# 安装
git clone https://github.com/DripNowhy/On-Policy-Self-Adaptation.git
cd On-Policy-Self-Adaptation/slime
pip install -e .
# 查看配置信息
bash examples/opsa/run_opsa.sh \
  --model qwen3-1.7b \
  --preset opsa \
  --fraction 0.2 \
  --dry-run
# 训练
bash examples/opsa/run_opsa.sh \
  --model qwen3-1.7b \
  --preset opsa \
  --fraction 0.2 \
  --hf-checkpoint /path/to/Qwen3-1.7B \
  --actor-checkpoint /path/to/qwen3-1.7b-megatron \
  --save-dir /path/to/outputs/opsa-qwen3-1.7b-lowest20 \
  --prompt-data "${OPSA_DATA_DIR}/dapo-math-17k/dapo-math-17k.jsonl" \
  --eval-data "${OPSA_DATA_DIR}/aime-2024/aime-2024.jsonl" \
  --megatron-path /path/to/Megatron-LM
RL 结合
OPD(OPSD) 来自教师模型的密集token-level指导和RLVR(来自环境的稀疏结果奖励)结合,实现互补优化
方法 参考
- 1、结果奖励和过程奖励直接加权
- 论文:
SDPO- Reinforcement Learning via Self-Distillation
- 论文:
- 2、结果奖励和过程奖励方向要求一致
- 论文:
Uni-OPD: Unifying On-Policy Distillation with a Dual-Perspective Recipe - 利用通过OPD结果和RLVR结果的一致性进行校准, 过滤掉结果奖励和过程奖励方向不一致的样本。
- 论文:
- 3、方向取决于结果奖励
- 论文:
RLSD-Self-Distilled RLVR - OPSD 失败: 当特权信息PI是标准答案时,因为这种输入信息的差异,导致了一个无法避免的矛盾,教师因为知道答案,所以在每个 token 上的概率分布会发生变化;而学生不知道答案,永远无法完全复现这个分布。模型可能学到的不是“推理逻辑”,而是“从问题直接猜测答案的捷径”。
- RLSD 将“如何更新模型”这件事分成了两件独立的任务,方向与幅度解耦:
- 1、更新方向(往哪走)—— 交给环境的稀疏结果奖励
- 2、更新幅度(走多远)—— 交给OPSD,只是利用教师的指导来调整幅度大小。
- 论文:
- 4、正方向取决于结果奖励
- (1)只对正优势做教师奖励,对负优势不做
- 论文:Distilled Reinforcement Learning for LLM Post-training; 只对正优势生效,对正优势进行reweight
- (2)对正优势做教师奖励,对负优势修正方向
- 论文:Hybrid Hindsight Self-Distillation 对成功轨迹,和RLSD的做法一样。对失败轨迹,使用反向 KL修正方向。不使用结果奖励
- (3)对正优势做GRPO,对负优势修正方向
- 论文:
SRPO-Unifying Group-Relative and Self-Distillation Policy Optimization via Sample Routing 将正确样本路由到GRPO的奖励对齐强化,将失败样本路由到SDPO的针对性Logit级校正。SRPO进一步引入了一个熵感知动态加权机制,以抑制高熵、不可靠的蒸馏目标,同时强调可信的目标。
- 论文:
- (1)只对正优势做教师奖励,对负优势不做
- 5、降低sampled-token方差
- 论文:Revisiting on-policy distillation: Empirical failure modes and simple fixes
- 1、不再只看学生生成的那个token,而是在每一个生成步骤,比较学生与教师在一个由教师选定的、概率最高的前K个token(top-K)组成的集合上的分布。
- 2、可以结合RLVR
- 论文:KL for a KL: On-Policy Distillation with Control Variate Baseline
- 1、用baseline降低方差
- 2、可以结合RLVR
- 论文:Revisiting on-policy distillation: Empirical failure modes and simple fixes
学习时机
【2026-9-17】浙大+阿里:RetireOPD
【2026-9-22】RetireOPD:智能体何时该停止模仿
【2026-9-17】浙大、阿里推出 RetireOPD
- 论文:RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning,arXiv:2609.20784
直觉:教师知道得更多,监督持续得越久,学生就该学得越好。
RetireOPD 反直觉的答案:
特权技能蒸馏更像训练初期的脚手架,而不是贯穿全程的优化目标。 真正关键的问题,不只是“怎样向教师学习”,还包括“何时停止模仿”。
“持续蒸馏不一定有用”,教师监督的价值具有阶段性。一个成熟的蒸馏系统,不只要知道怎样学,还要知道何时放手。
判断:
- 蒸馏质量的起点不是教师拥有多少信息,而是教师能否把信息转化成环境回报。
RetireOPD 将教师监督拆成三个阶段:
- 先用环境奖励训练一个真正会使用技能的教师
- 再让学生同时接收回报信号和 token 级教师信号
- 最后根据训练动态在线判断何时撤掉蒸馏约束。
- 脚手架完成使命后,学生继续独立优化。
教师冻结后,学生在不接收技能上下文的条件下采样自己的轨迹,并联合优化两部分目标:
Lstudent = LGRPO + λLOPD
其中,GRPO 负责从环境回报中学习;OPD(On-Policy Distillation)则提供教师方向的 token 级监督。
两个信号,决定何时“毕业”
RetireOPD 没有预设一个固定退出步数,而是在训练过程中监测两个信号。
- 对齐停滞信号:观察学生与教师的 token 对数概率差。如果差距不再继续缩小,甚至开始扩大,说明蒸馏信号正在衰减,或可能已经与回报优化发生冲突。
- 相对能力信号:比较学生与冻结教师的成功率。只有当学生达到教师成功率的目标比例,才允许撤掉脚手架,避免过早退出。
应用
【2026-7-5】UI-MOPD 应用到GUI Agent
【2026-7-5】GUI Agent 跨平台蒸馏
清华大学深圳国际研究生院、小米及哈尔滨工业大学(深圳)等团队解决 GUI agent 跨平台持续学习的“跷跷板”问题。
桌面端和移动端的交互语义天差地别——关闭窗口 vs 返回键,鼠标点击 vs 手指滑动——把它们的数据混在一起做 SFT 或 RL,平台特定行为模式会被“平均”掉,甚至灾难性遗忘。
最直觉的跨平台做法有两类:
- 混合 SFT——把桌面和移动端轨迹混到一起做监督微调;
- 模型合并——分别训练平台专家再平均权重(Weight Averaging)或 TIES Merging。
问题出在哪?桌面端要 mouse_move、left_click、scroll 这套操作语义,移动端靠的是 click、swipe、long_press、navigate_back。
把这两套截然不同的行为分布塞进同一个 loss,模型学到的不是“在什么平台做什么事”,而是一个被两头拉扯的折中策略。
- 混合 SFT 在 OSWorld 上 35.0%、MobileWorld 上只有 6.4%;
- TIES Merging 虽然桌面 36.8% 还行,但移动端直接崩到 0%。灾难性遗忘不是偶然现象,是这类方案的必然结果
UI-MOPD 思路:不是“用了蒸馏”,而是“把蒸馏条件化”。
- 先为每个平台分别训一个专家 teacher,再在在线 RL 阶段按平台路由选对应 teacher 做 on-policy distillation,让一个共享 student 同时吸收两个平台的行为先验。
- 把多教师蒸馏(MOPD)从通用大模型后训练搬到了 GUI agent 场景,用条件化的 KL 约束替代了简单的混合监督。
- 论文 UI-MOPD: Multi-Platform On-Policy Distillation for Continual GUI Agent Learning
UI-MOPD 分两阶段。
- Stage 1:在 Uni-GUI 数据集上分别 SFT 出桌面 teacher π_ref^d 和移动 teacher π_ref^m。
- Stage 2:用一个 8B student 在线采样 rollout,按平台标签路由到对应 teacher,做 on-policy KL 蒸馏 + 强化学习。
关键设计在“条件化”三个字。student 在线采样时,桌面环境的 rollout 只对齐桌面 teacher,移动环境的 rollout 只对齐移动 teacher。teacher 信号不是混成一个 KL 惩罚,而是按平台分别约束。这把 KL 项的角色从 RLHF 里常见的“防漂移保守正则”变成了“平台行为先验的定向迁移器”。
UI-MOPD 在 AndroidControl* 上不降反升(78.73% → 80.05%),三个 grounding benchmark 基本持平。Model Merge 则全面下滑,ScreenSpot-Pro 跌了 6.6 个点。说明在线蒸馏比静态参数合并对基础 GUI 能力的破坏小得多。
OSWorld 是桌面端 361 个任务,MobileWorld 是移动端 117 个任务。
【2026-8-6】清华+浙大+美团:AgentOPSD
【2026-9-15】AgentOPSD:智能体做对了一整件事,怎样知道哪一步真正有用?
购物任务:搜索商品、查看详情、比较参数、选择规格,最后成功下单。
- 失败轨迹里也可能包含正确的检索和判断,只是在最后选错了规格
整条轨迹成功了,但中间每一步都值得强化吗?
RL 信用分配问题:
- 最终只得到1个成功或失败的结果,训练时却需要判断几十个中间决策各自贡献了多少。
【2026-8-6】清华大学、浙江大学和美团龙猫提出 AgentOPSD 方法
- AgentOPSD: Recursive Self-Distillation for Agentic Reinforcement Learning
- 代码:AgentOPSD
- 利用训练时带有技能提示的教师分支,对学生自己生成的动作重新打分,将逐 token 差异汇总到交互轮次,再递归更新一个关于轨迹成功的支持状态。每步的训练权重,取决于让累计支持状态改变了多少。
解决什么问题?
RLVR 能构建轨迹层面的优势值,但在长时序、多轮任务中,难以对少量关键决策进行信用分配。
- OPSD 将特权自蒸馏引入RL 信用分配机制,提供更稠密的监督信号。但局部信号无法表达时序信用。
AgentOPSD:无评价器、递归式轮次级信用分配。
- 将 token 粒度的师生对数概率差聚合为轮次级证据,并在对数几率空间中递归更新贝叶斯信念状态。
- 提供有理论依据的重加权方案,可将稀疏的结果监督转化为轮次级信用信号;同时依靠连续状态间的边际变化识别关键轮次。
- 完全兼容标准策略优化流程,无需额外采样轨迹。
效果
- ALFWorld、WebShop、Search-QA 三个数据集上,基于两种参数量的 Qwen 模型(3B、7B)开展实验。
- AgentOPSD 相比 GRPO 以及性能优异的自蒸馏基线模型取得了性能提升;
- Qwen2.5-7B 模型上,ALFWorld 任务成功率达到 89.1%。
- 消融实验表明,性能增益来源于轮次级聚合以及依赖历史信息的递归信念更新。
OPD 问题
重要警告:OPD不是万能的,有明确天花板
原生 OPD
- Prefix‑drift 前缀漂移:学生生成长序列,几步偏离教师熟悉路径后,教师面对陌生上下文,给出的token概率信号不可靠甚至有害;局部流畅≠全局答案正确。教师只是下一个token预测器,不是任务评判器。
- 位置偏置:序列越靠后token,监督质量快速下降;前面prefix信号强,末尾几乎学不到有效信息。
- 训练不稳定、梯度方差大;teacher和student tokenizer不匹配会带来噪声。
- 计算开销大:每步迭代学生采样+教师逐token推理,长推理任务FLOPs极高。
- teacher和student不兼容:即便教师绝对能力更强,如果两者底层分布、推理范式差异大,OPD效果很差;师生模型基座/思维模式匹配,远比教师绝对分数重要。
失败怎么办
工程落地:2个直接可用的失败蒸馏救场方案
针对“思维错位”“无新知识”导致的蒸馏失败,论文给出两个可直接落地的修复方案,工程价值拉满。
方案1:离线冷启动(Off-policy Cold Start)
核心逻辑:先用离线蒸馏缩小思维差距,再启动OPD,专治“思维错位”。
两步执行流程:
- 冷启动阶段:用老师生成的标准答案,对学生做一轮SFT(监督微调),让学生先熟悉老师的思维模式;
- OPD阶段:从SFT后的模型开始,启动标准OPD训练。
- 效果:初始重叠率大幅提升,训练全程更稳定,最终效果比直接启动OPD显著更高。
方案2:老师对齐提示词(Teacher-aligned Prompts)
核心逻辑:让训练用的提示词,和老师后训练时用的提示词保持一致,强化高概率token对齐。
两个关键操作:
- 提示模板对齐:使用老师后训练时用的提示模板(如老师习惯“请分步推理,答案放方框内”,学生训练也用同样模板);
- 提示内容对齐:使用老师后训练时见过的提示数据,让学生生成的轨迹更贴近老师熟悉的场景。
注意事项:需混合少量“分布外提示词”,防止学生熵崩塌(输出过于单一)。
奖励随长度退化
OPD的致命缺陷:奖励质量随文本长度急剧退化,决定了适用边界。
文本长度的“甜蜜点”
- 短文本(0.5K–1K token):监督token太少,学习效率低;
- 中等长度(3K–7K token):奖励最可靠,效果最佳;
- 超长文本(10K+ token):奖励质量急剧下降,训练后期会崩溃(错误从末尾往前传染)。
结论:
OPD不适合长推理、多轮智能体等长文本场景。
未来最优路线:
- 短片段密集监督(OPD) + 长文本稀疏奖励(传统RL),兼顾效率与可靠性。
Teacher 能用商用API?
【2026-9-6】OPD 训练:Teacher能不能用商用API?
总结
- 标准原版OPD ❌ 不能直接用 GPT‑4o/Claude 这类闭源商用API当teacher:没有logits接口、词表不透明、TOS协议禁止蒸馏。
- 开源模型托管API(Together等):技术上可跑稀疏top‑K OPD,但是成本、延迟、版本风险很高,仅适合原型。
- 如果一定要拿闭源商用大模型能力做 OPD‑like 训练:使用ROPD / OmniOPD 这类黑盒变体,把教师当成文本评判器,不再做token‑KL匹配;但算法已经不是原版OPD。
- 区分:拿API生成静态数据集做SFT蒸馏 ≠ OPD。OPD核心是学生自己rollout轨迹,在线拿到教师针对该错误轨迹的密集反馈。
标准原版OPD(On‑Policy Distillation)核心机制:学生生成完整轨迹 → 把学生生成的每一步前缀送入教师,拿到教师在该前缀下的token‑level logprobs,计算KL散度做损失更新学生。
1、原生标准OPD不能直接用
GPT‑4o / Claude / Gemini这类闭源商用API不能直接用
两个硬限制:
- 技术限制
- 商用API不对外返回任意前缀下完整token概率分布(logits),OpenAI最多返回top‑20 logprobs;Claude完全不开放logprobs接口。
- OPD需要:输入学生已经生成的任意token序列前缀,教师对这个前缀做前向,输出下一个token的概率分布。商用API接口只能做“生成补全”,不支持“给定任意前缀,只做前向算概率,不生成文本”,无法拿到训练需要的密集token‑level监督信号。
- 开源模型搭vLLM/SGLang服务,可以做到这个能力;OpenAI/Claude API做不到。
- tokenizer词表必须对齐
- 教师、学生词表/tokenizer必须一致,否则logprob完全没有对比意义。商用闭源模型词表不公开,天然不满足条件。
- 法律/TOS约束
- OpenAI、Anthropic服务条款明确:禁止把API输出用于蒸馏、训练另一个竞争模型,商用项目直接踩协议风险。
✅ 可用API作为离线数据生成源:调用API批量生成样本,学生在静态数据集上做普通SFT蒸馏,这不是OPD。OPD关键是在线inner‑loop:学生每一步rollout,立刻拿自己跑出来的错误轨迹去查询教师,离线数据集做不到闭环。
变通方案:黑盒OPD变体
黑盒OPD变体:不需要logits,只拿API文本输出
学术界已经有一批变种,专门适配商用API教师,放弃原生token‑KL损失:
| 变体 | 原理 | 输入 | 优缺点 |
|---|---|---|---|
| ROPD | 基于评分标准(rubric)分块监督,把token‑level KL替换为教师文本评价打分,当成奖励信号,套GRPO训练框架 | 仅教师文本输出(API就可以) | 工程改动小;丢失细粒度token信号,性能略低于原生OPD |
| OmniOPD | 分块蒙特卡洛语义验证,在学生高不确定性推理分叉点调用教师,块级监督,不需要逐token logits | 仅教师文本输出 | 减少API调用量;实现复杂 |
| GAD生成对抗蒸馏 | 训练判别器区分学生/教师输出,判别器给出奖励,替代教师logits | 教师文本输出 | 需要额外训练判别器,增加一套模型成本 |
⚠️ 重点:这些都不是原始DeepSeek定义的标准OPD,属于黑盒适配改造;性能普遍弱于白盒原生OPD。
什么API服务可以跑原生OPD?
只有一类:开源模型托管API(Together、Fireworks等)
- 底层跑开源权重,接口支持返回
logprobs,支持输入任意前缀做概率打分; - 教师和学生使用相同tokenizer;
- 协议允许蒸馏。
工程痛点
- 大多数API只返回top‑20 logprobs;原版OPD reverse‑KL需要完整词表分布,只能降级使用top‑K稀疏OPD,效果会下降。
- OPD训练循环每一步都大量调用API,token成本爆炸、延迟高、容易限流,大规模训练几乎不可行,只适合小实验原型验证。
- 服务商随时下架模型版本,训练任务会直接中断。
工程实践:真正大规模OPD训练,几乎都是自己vLLM/SGLang部署开源教师模型,而不是调用外部API。
 支付宝打赏
 微信打赏