问题
LLM对话能力上超越人类,但大规模自动化应用迟迟没有普及,因为LLM 有致命问题:
- 通过RLHF训练出来的自回归大模型存在严重的模式崩溃(Mode-dropping)、过度自信与幻觉,且串行逐字生成的延迟极大,根本无法胜任严肃的机器自动化生产 对于要做决策的场景(如分类、选择、打分),需要以自然语言形式将生成式任务转换为判别式
- 如通过PE,将LLM输出限制到指定选项/范围/格式。
问题:
- 速度慢:尤其是选项较多、附加推理过程、解释
- 质量不稳定:标签幻觉、格式(JSON)乱等
- 置信度难以量化:PE模式下,LLM生成的置信度不科学(LLM里数学运算曾经靠猜)
- 成本高:自回归方式下,prefill和docoder消耗的token多
Jev
【2026-9-15】前 OpenAI 研究员 Diogo Almeida (InstructGPT作者)创立的TypeSafe AI发布 System One 基础决策模型 Jev, 不生成文本,主打结构化概率决策,是与 LLM(System Two)配套的高速判别模型
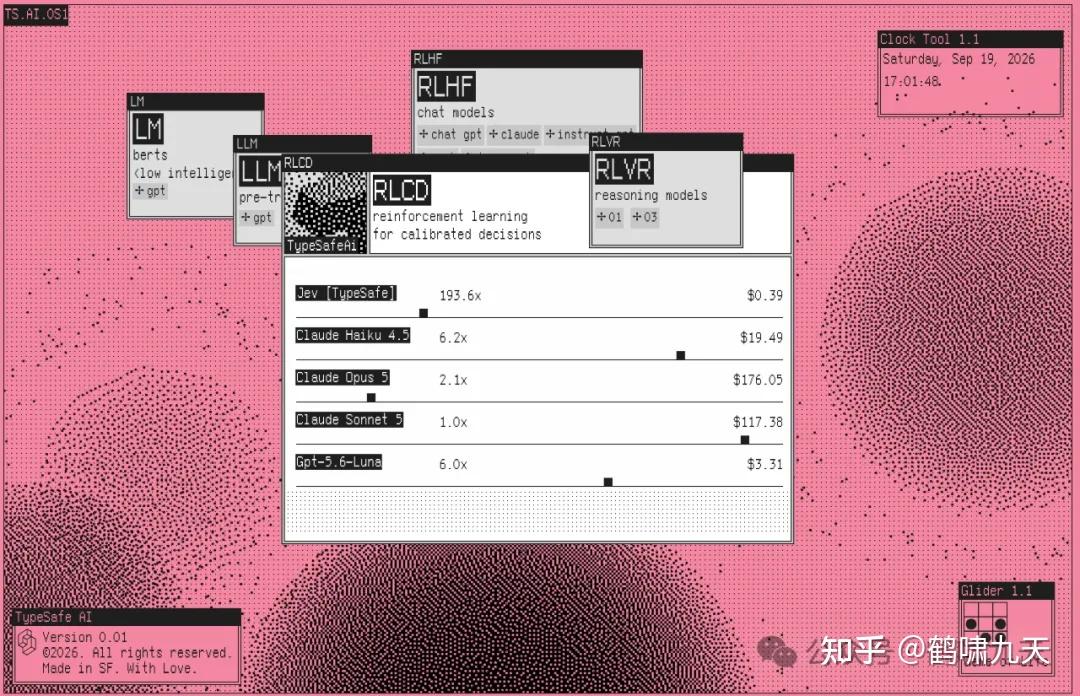
Jev 决策任务更快、更便宜
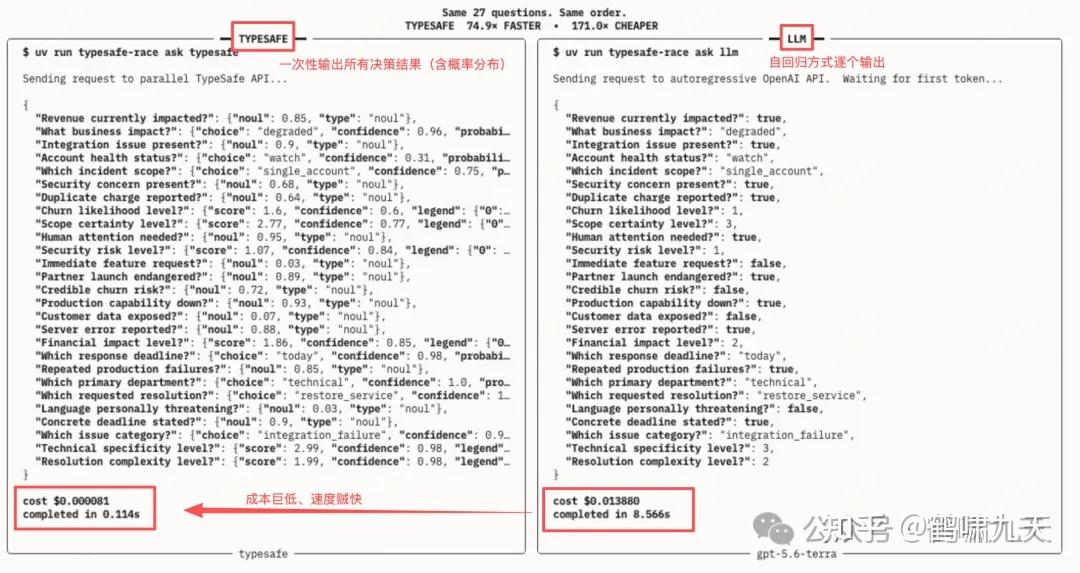
- 效果:相对顶级LLM,Jev 提速 193 倍、成本降低 444 倍
- 快思考模型,采用非自回归方式,一次输出多种决策,消灭幻觉、格式问题
Jev 命名
- 灵感来自丹尼尔・卡尼曼《思考,快与慢》。人类大脑 90% 的动作靠直觉式快思考,瞬间做出避让、识别和判断;只有遇到攻关难题时,才调动耗能极高的慢思考深度推理。
- System‑One(系统一)代表快速、直觉式思考;—— “系统一” 容易犯错
- System‑Two(系统二)代表缓慢审慎推理。
- Jev 取自经济学家
William Stanley Jevons, 提出杰文斯悖论:- 机器智能会重演煤炭‑蒸汽机历史:每当智能成本下降一个数量级,就会解锁多出数个数量级的全新使用场景。
大模型过去一直在模仿 System Two,试图把所有问题都变成深思熟虑的长篇大论。Jev 则是在给 AI 补齐那个高速、轻量、只凭直觉做判断的 System One
更多、更新内容见飞书笔记:Jev 模型
特点
Jev 是“函数调用式”前沿模型
- 输入:非结构化的状态(文本或程序状态)
- 输出:带概率的类型化决策。
Jev 特点
- 无需自回归解码即可并行分类,推理开销大幅降低;
- 结果直接用于业务阈值(例如 p(紧急) > 0.1 就升级处理);这个结果并非语言建模目标训练出的概率,置信度比LLM更有保障
- 显式数值分布让下游系统把误报与漏报的代价写进业务逻辑,而不是藏在模型行为里。
核心特点
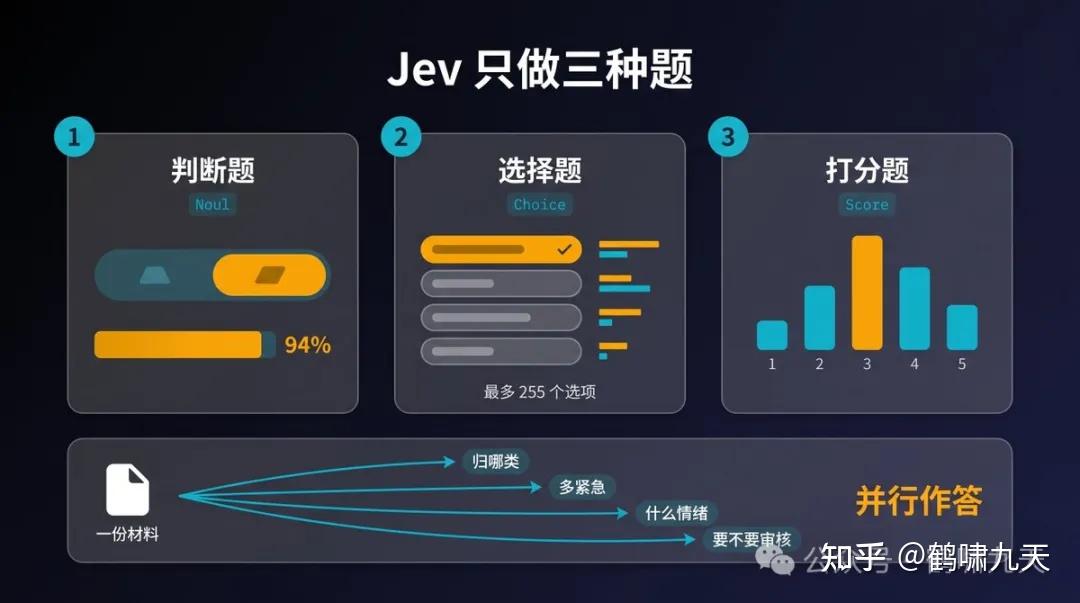
- 不生成自然语言:没有自回归 token 生成,一次前向并行完成多个结构化问题判断;一次请求可以并发多个决策问题,新增问题几乎不增加延迟
- 三类原生输出原语(Typed Output)
- Choice选择题:从给定候选列表选择,返回选中项、所有选项概率分布、置信度
- Noul判断题:命题真假判断,返回 0~1 之间真实概率(是 / 否概率)
- Score打分题:按自定义分级标尺打分,返回档位、概率分布、置信度
- 类型安全输出:返回结构化 JSON,代码可直接分支,无需 LLM 输出解析、清洗
- 输入形式:任意文本 / 日志 / 工单 / JSON 状态 + 用户定义的结构化决策问题
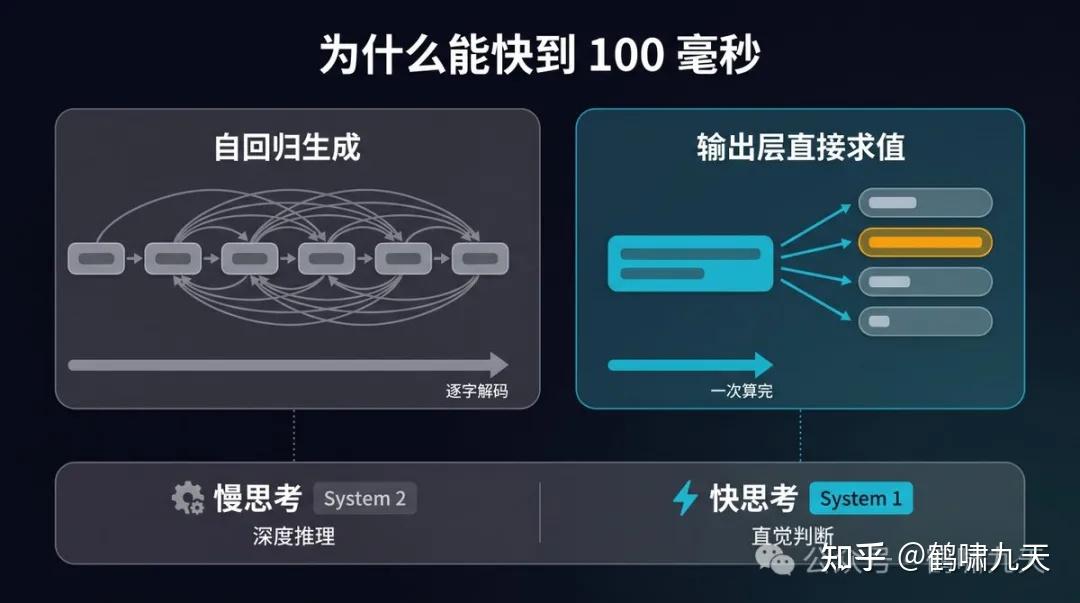
Jev属于System One 定位:
- 快速、高频、标准化判断
- 和 LLM(System Two)搭配:Jev 做批量分流,置信不足时交给大模型做复杂推理
效果
Jev vs GPT-5.6
多方验证
- 速度:端到端延迟 70–500ms;比前沿 LLM快20~200 倍,最高基准可达 193.6 倍加速
- 成本:$0.042 / 百万输入 token,输出 token 免费;比前沿 LLM便宜 40~400 倍,最高基准 444.6 倍成本降低Eigent AI
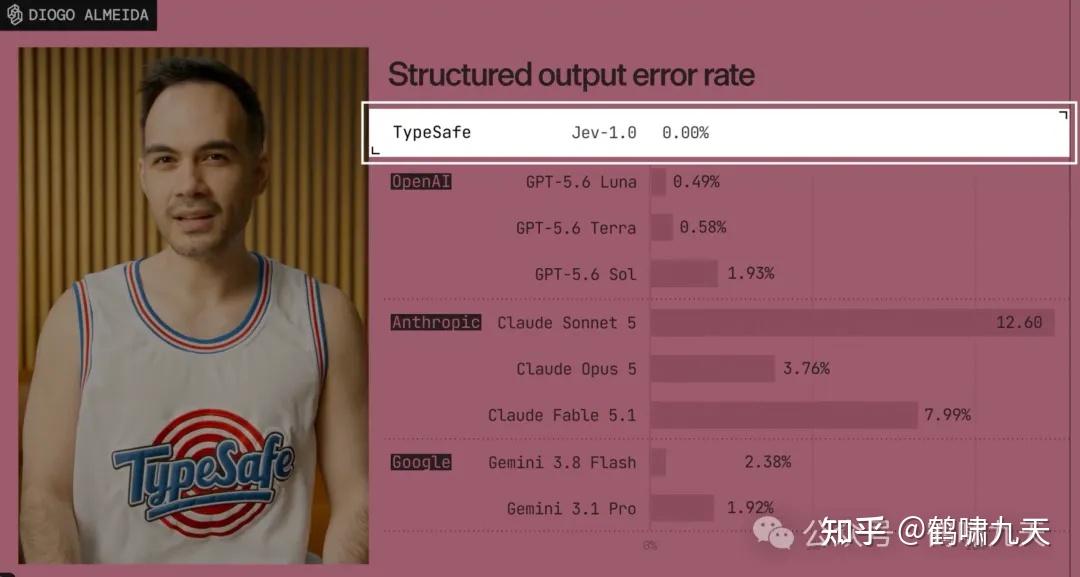
- 可靠性:输出空间严格受限在用户定义选项内,宣称无幻觉、无类型错误;输出带校准后的概率分布 + 置信度,方便代码做阈值分流(低置信交给大模型 / 人工复核)
- 当前LLM无论多强大,依旧会产生幻觉、类型错误。
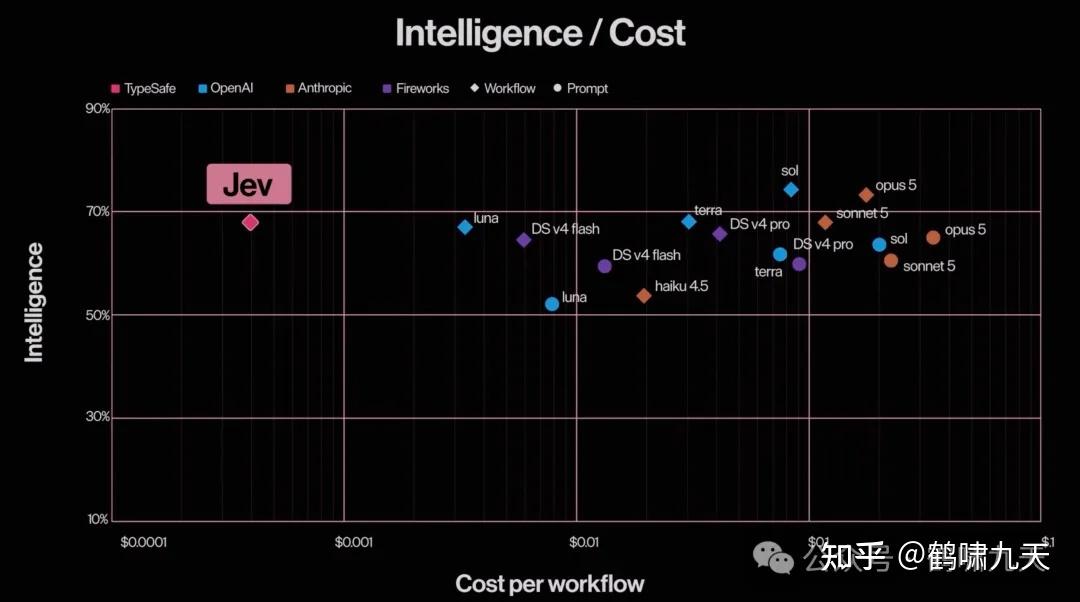
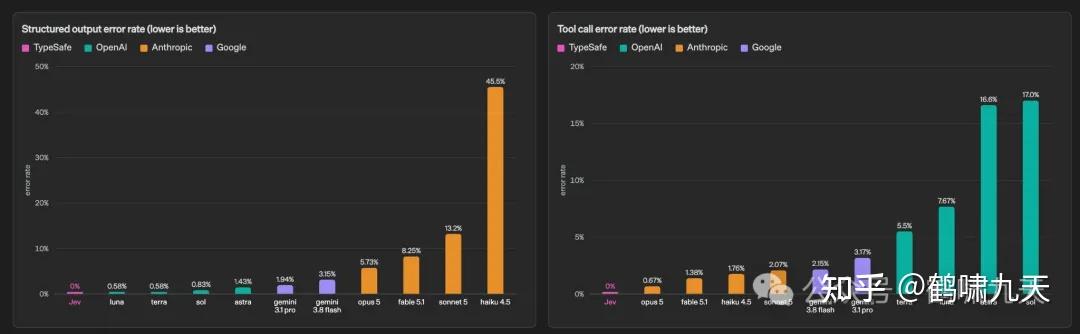
原理
TypeSafe 的 RLCD用真实结果训练模型,使概率”诚实”。
- 在 1,200 道 MMLU 题上,期望校准误差仅 0.0313;
总结
- 训练方法:RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习) 训练目标不是生成文本,而是学习输出校准良好的概率分布,保证模型置信度和真实准确率匹配,减少过度自信
- 推理范式:非自回归并行前向推理 传统 LLM 逐个 token 串行生成;Jev 对同一份上下文 state,并行计算全部决策问题的概率分布,单次前向完成全部判断,没有 token 采样步骤,因此延迟极低
- 输出约束机制:答案空间被用户预先定义的 schema 锁定,模型不能输出 schema 以外内容,从机制上杜绝文本幻觉、非法输出,实现类型安全
⚠️ 注意:
- TypeSafe 没有公开模型权重、技术论文、完整训练数据集,只有博客、API 文档介绍高层原理,底层网络架构细节未披露
推测 Jev 是稀疏 MoE,活跃参数约 100 亿,依据是 3 万 token 约 160 毫秒的处理速度,以及这种仅 prefill 的设计恰好避开了 MoE 逐 token 解码的服务成本;
问题:
- 普通大模型的”置信度”只是文本 token,并不代表决策可靠。
- 但 Jev 无法做任何需要自由文本输出的任务(写作、聊天、copilot);
- 没有清晰决策结构的场景;
- 数学证明、代码生成这类重推理任务;
- 以及本身对延迟不敏感、用 LLM 就够的场景。
Jev 最有价值的地方不是替代 LLM,而是让 agent 系统里那些高频、低价值、但必须可靠的决策点(该不该升级、走哪个分支、这条数据属于哪类)变得又快又便宜又可量化🤔
新旧范式对比
核心架构创新非常激进:
- 单次并行计算(One Parallel Pass):同当年 Transformer 取代 RNN 一样,JEV 彻底抛弃了逐 Token 串行吐字的自回归机制,采用全新模型架构与采样器,一次性并行击发所有预设选项
- 强化学习校准决策(RL for Calibrated Decisions):引入全新训练算法,输出媒介不再是自然语言文本,而是直接输出经过置信度校准的概率分布
- 代码级可靠(TypeSafe):彻底根除幻觉,输出自一致、确定性高,可作为强类型对象直接被程序调用
- 100 倍提速与极端降本:延迟降至 0.1 秒以内(快到能直接插入 60 FPS 游戏循环);输入每 10 亿 Token 仅 42 美元,输出 Token 彻底免费
图解
表格对比
| 对比项 | 现有大语言模型(LLM) | System One + Jev |
|---|---|---|
| 优化算法 | RLHF(基于人类反馈的强化学习)/ RLVR(可验证奖励强化学习) | RLCD(校准决策强化学习) |
| 优化目标 | 人类偏好:产出人工标注者更认可的文案、对话回复 可验证奖励:输出可被程序校验的结果 | 校准式决策:在System‑One任务中输出认知层面真实可信的概率 |
| 输入 | 非结构化数据(文本等),侧重序列消息 | 非结构化数据(文本等),侧重程序结构化状态 |
| 输出 | 字符串/生成文本。字符串灵活性极强,可以是对话、代码,也会产生幻觉、拒绝回答,偶尔也能输出符合类型约束的结构化内容。软件使用前必须解析+校验,AI存在输出失控风险。 | 类型安全结构化值。输出格式与可选结果预先定义,模型不会出现类型错误。每条结果附带经过校准的概率与置信分数。 |
| 采样方式 | 串行自回归:逐token生成,每一步依赖上一个token | 并行计算:单次请求一次性产出全部结果,硬件利用效率极高 |
| 成本 | 输入token:0.20‑10美元/百万token 输出token:价格约为输入的5倍 | 输入token:0.042美元/百万token(42美元/十亿token) 输出token:完全免费(成本低到无需计费) |
| 响应速度 | 前沿模型端到端耗时:3‑329秒。与人交互够用,但嵌入代码中会成为严重性能瓶颈 | TypeSafe端到端:70‑500毫秒。同等智能水平下,System‑One类查询速度提升40‑200倍 |
| 置信度表现 | 即便提示模型输出置信度,结果普遍过度自信、一致性差。模型95%场景下做对,但无法告知自己处于那5%错误场景,就无法实现自动化 | 每次输出都会附带置信度与不确定性;概率经过校准:置信越高代表准确率越高;同类输入返回结果更稳定一致 |
| 适用场景 | 人在回路的任务(聊天机器人、Copilot、代码Agent),通用性强,但需要人工监督,灵活同时伴随输出失控风险。 可验证类问题(数学证明、内核优化):正确性可以低成本自动校验时,大模型可以反复生成‑测试迭代。 原型演示:字符串灵活性适合快速搭建原型,但效果不稳定。 | AI驱动业务流程 / 智能条件判断:结构化输出直接接入普通软件,作为模糊决策规则完成分类、路由、打分、信息提取、分支逻辑,弥补手写规则脆弱的缺陷;外围代码约束模型行为,更容易构建可靠系统。 大数据Map‑Reduce处理:将PB级原始数据转化为特征与业务洞察。 实时应用:百毫秒级延迟,可以用于对用户体验敏感的业务。 全链路校验:打分、评判、内容核验、安全护栏,检测大模型提示词越狱、推理过程与输出内容。 |
使用方法
当前版本:jev-1.13.0,别名jev-latest,jev-preview为预览版MindStudio
如何用Jev
(1)官方渠道
- 1、官网申请加入waitlist,基本上申请当天能过。
- 2、Codex插件安装:操作速度提高10倍并省下大量token!
- 安装 npx skills add typesafe-ai/skills –skill typesafe-ai
- 3、回到操作台,建立API Key。
- 4、在 prompt 里说一句 “use the TypeSafe skill”。
方式 1:原生 TypeSafe API(推荐)
- 接口地址:POST https://api.typesafe.ai/v1/systemone
- 鉴权:在 console.typesafe.ai/settings/keys 创建 API Key,Bearer Token 认证
- Model ID:jev-latest(稳定版) / jev-preview(实验版)
- SDK:
- Python:pip install typesafe-sdk(Python≥3.10)
- JS/TS:npm install @typesafe-ai/sdk(Node≥20)
- 输入结构:state(上下文) + questions(多个 Choice/Score/Noul 决策定义)DEV Commun…
代码
from typesafe_sdk import TypeSafeClient, Noul, Choice

client = TypeSafeClient(api_key="YOUR_KEY")

resp = client.invoke(
    state="用户提交工单:网站持续500错误",
    questions={
        "is_urgent": Noul(instructions="该工单是否紧急?"),
        "category": Choice(
            instructions="工单分类",
            options=["服务器故障", "账号问题", "咨询"]
        )
    }
)
print(resp)
方式 2:框架集成
直接在 Vercel AI Gateway 或者 Cloudflare AI 里调 typesafe-ai/jev,不用等名单,价格跟官方完全一致。Cloudflare AI 接入说明
- LangChain:langchain-typesafe,TypeSafeClassifier封装,直接接入 LangChain Agent 工作流LangChain
- Vercel AI SDK:通过 Vercel AI Gateway 调用,模型标识 typesafe-ai/jev,使用experimental_evaluate接口
应用
- 适合:工单路由、内容审核、严重性打分、真假校验、Agent 工具调用安全闸、欺诈识别;
- 不适合:开放式创作、长文本推理这类生成任务
社区已验证的场景远远不止文本分类。
- 极速浏览器 Agent(Browser Use 社区)Jev Ultrafast 浏览器 Agent。
- 以前让 AI 操作网页,每到一个新页面,大模型都要看半天 DOM、想两秒钟、再决定点哪,慢得像幻灯片
- 现在拆成两层:Jev 专门负责选按钮、选输入框,变成几十个元素里的单选题,几十毫秒就能决定点哪;只有当遇到要打字输入复杂的搜索词时,才调小型文本生成模型。
- 实测中,完成一次从苏黎世搜索到伦敦航班的全流程,只花了 7.1 秒,流畅得像写好的自动化脚本。
- 项目开源地址:https://github.com/browser-use/jev-ultrafast
- 实时游戏决策(Doom 毁灭战士)
- TypeSafe 官方 Jev 玩经典射击游戏 Doom 演示。输入不是游戏画面,而是解析好的结构化游戏状态(比如血量、敌人方位、剩余弹药)。
- Jev 每秒进行大约 10 次实时判断,快速决定走位和开火。连续玩一小时,成本大概只有 7 美元。
- 这种每秒十次的高频连续决策,换成传统大模型,延迟根本跟不上游戏画面,账单也会直接起飞。
- 官方演示与介绍:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Agent 路由与工具选择(LangChain 官方集成)
- LangChain 第二天火速推出 TypeSafeClassifier。复杂的 Multi-Agent 架构里
- 以前每走一步都要问大模型:下一步调用哪个工具?要不要退出循环? 这些原本耗费大量等待时间的控制流判断
- 现在直接交给 Jev 做极速路由,把 Agent 内部空转的耗时压缩到了极致。
- 集成库文档:https://python.langchain.com(Python 包名:langchain-typesafe)
- 实时安全守门员与输出裁判(Vercel AI SDK)
- Vercel 在 AI Gateway 里第一时间支持了 Jev,并在 AI SDK 7 的 evaluate 函数里做了集成。
- 开发者把Jev当AI 裁判:大模型刚生成完一段内容,或者用户刚发来一段提问,Jev 可以在几十毫秒内完成合规审核、事实一致性打分或者情感倾向分析,再也不用为了审核一段话去重新调用一次昂贵的 GPT-4o
- Vercel AI Gateway 说明:https://vercel.com/docs/ai-gateway
- 复杂选项的两阶段竞速(Wikiracing 维基词条跳转)
- Jev 单次选择上限是 255 个选项。如果候选词条有上千个怎么办?两阶段策略:先用打分(Score)并行扫一遍所有候选做粗筛,再把前几十个送进选择(Choice)做精选。维基百科的词条竞速跳转,用这种方式几百毫秒就能完成一次高基数决策。
- 官方发布:https://typesafe.ai/blog/introducing-system-one-models-and-jev
更多社区案例,项目合集:
- Awesome-Jev 资源汇总:https://github.com/cobanov/awesome-jev
- 还有开发者拿它做多 Agent 协作的代码质检监督器(Foreman):https://github.com/thruwire/foreman
LangChain 在发布第二天就火速推出了 TypeSafeClassifier。在复杂的 Multi-Agent 架构里,以前每走一步都要问大模型:下一步调用哪个工具?要不要退出循环? 这些原本耗费大量等待时间的控制流判断,现在直接交给 Jev 做极速路由,把 Agent 内部空转的耗时压缩到了极致。
- 集成库文档 Python 包名:langchain-typesafe
玩游戏,实时操作
- TypeSafe 甚至拿 Jev 去玩射击游戏 Doom。在不需要做复杂长线规划、只需要每秒钟做出约 10 次即时操作判断的场景下,Jev 表现得像一个反应极快的人类玩家,而整套推理成本每小时大概只要 7 美元。
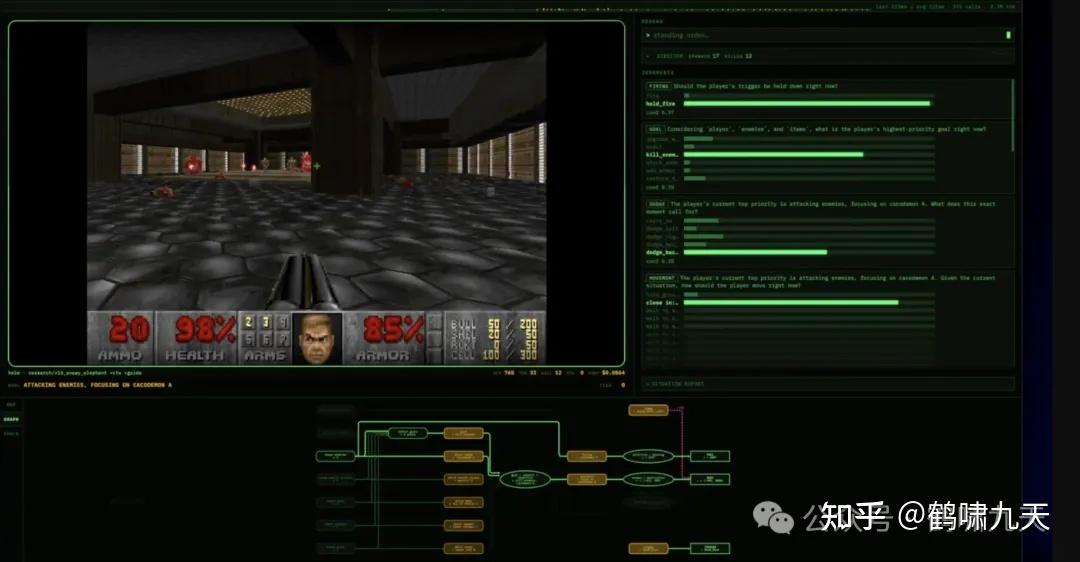
Agent系统中9个场景
【2026-10-24】使用决策模型(Jev)的9个位置
- 模型路由(Model routing): 提示词送入决策模型,由它选择模型层级。简单查询调用低成本模型;高风险、不容出错的任务调用高性能模型。
- 安全护栏(Guardrails): 针对每一类潜在风险单独做是/否判断,可放在大模型接收输入前,或是生成回答之后。
- 检索充足性判断(Retrieval sufficiency): 判断当前检索到的信息是否足以回答问题,是否需要再次检索。
- 段落过滤与重排(Passage filtering and reranking): 判断该段落是否真正能够解答问题,还是仅仅关键词相近。对每条候选段落打分,并按置信度排序。
- 引文核验(Citation checking): 判断该文献来源是支撑观点、和观点矛盾,还是完全没有提及相关内容。
- 工具调用闸门(Tool-call gating) 对每一次工具调用做放行、询问确认或拒绝,规则阈值写在业务代码中。
- 循环终止判断(Loop termination) 判断当前结果是否满足验收标准,决定是否停止迭代。
- 上下文精简(Context compaction) 对每条上下文片段打分,剔除无效陈旧内容(区别于直接摘要压缩)。
- 全量评估(Evals at full coverage) 单条判定成本远低于通用大模型裁判。有机会对每一条轨迹打分,而不是只抽样评估。
| 序号 | 模块位置 | 英文名称 | 核心作用 | 输出形式 |
|---|---|---|---|---|
| 1 | 入口路由 | Model routing | 根据任务难度选择不同规格LLM | 模型选择决策 |
| 2 | 安全校验 | Guardrails | 风险内容拦截、合规校验 | 是/否(放行/阻断) |
| 3 | 检索后 | Retrieval sufficiency | 判断检索信息是否足够,是否继续搜 | 是否继续检索 |
| 4 | 检索召回后 | Passage filtering and reranking | 过滤无关段落、按相关性重排 | 相关性分数+排序 |
| 5 | 生成后 | Citation checking | 校验引用材料和结论是否匹配 | 支撑/矛盾/无关 |
| 6 | 工具调用前 | Tool-call gating | 管控工具调用权限 | 放行/确认/拒绝 |
| 7 | 迭代循环末尾 | Loop termination | 判断是否达成目标、停止循环 | 是否终止 |
| 8 | 上下文窗口管理 | Context compaction | 淘汰低价值上下文,压缩窗口 | 上下文保留/丢弃 |
| 9 | 评估层 | Evals at full coverage | 低成本批量评估每条样本轨迹 | 评估打分 |

意义
Jev开启了Agent分层新范式,过去两年所有人都在写同一种 agent:
一个强模型 + 一堆 prompt + 工具循环(配合各种harness、loop工程)
该不该调这个工具、这请求有没有风险、该用哪个模型、输出对不对,全塞进同一个上下文,让Agent自己想。
这种范式在demo 阶段无敌,一旦到生产环节,就会撞三堵墙:慢、贵、说不清为什么。
判断和生成是两种任务:
判断:固定选项、可校准概率、可调节阈值、能画的 ROC生成:一段文本,除了照办,无法量化。”我觉得这个操作有风险,建议人工确认”。
然而具体任务中,幻觉和误杀率多少?
即将发生的迁移:
- 单体 agent → 生成层 + 一堆小决策器
跟当年 PHP 单体拆成网关/鉴权/限流,同一个剧本
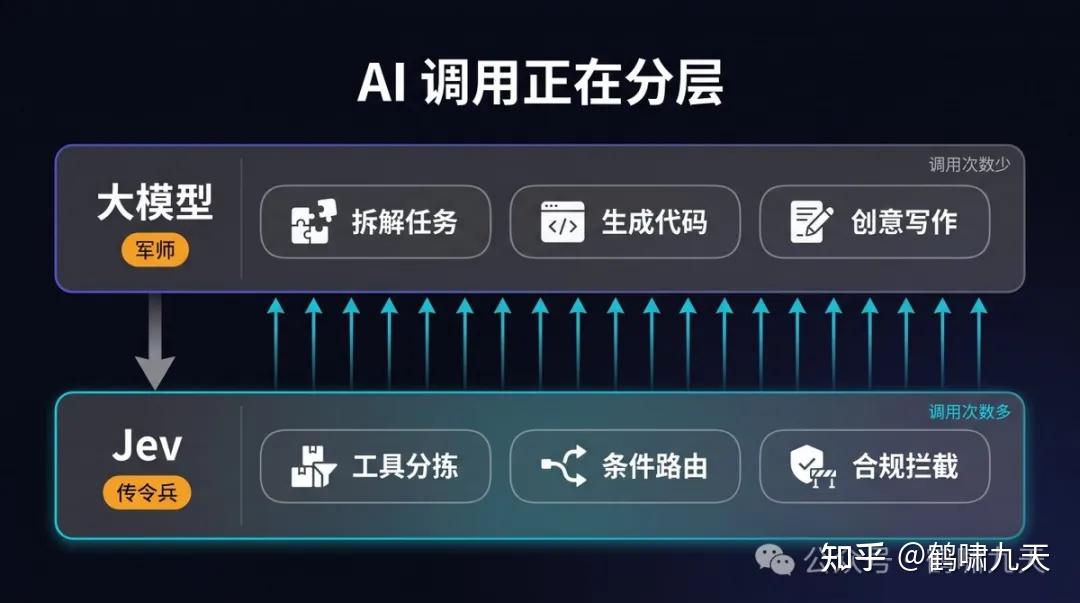
如何应用Jev?
- 1、把Agent 里所有判断点标出来:工具授权、模型路由、内容准入、结果验证
- 2、定义每个判断点:标签集、阈值、两类误判各自的代价
- 3、三个状态:PASS / FAIL / 不确定,别让模型在没把握时硬猜,把不确定导给人
提醒:
- 小模型专职判断不是新东西,传统 NLP 干了十几年,只是最近这两年被 LLM 光芒盖住了
- 真正难的从来不是模型,而是标注和调阈值:幻觉或者误杀率 3% 在 demo 里没感觉,生产环节就是每天几十个投诉。
- 这层会让系统更复杂,不是更简单,只有当agent 真在替人做有后果的事时,才值得加。
- 如果是做demo类,不需要,但生产级agent需要,要在成本和结果提升上找平衡点。
开源实现
Jev闭源,只提供云端 API,但有第三方复现版本
- 开源 SDK 与集成层:LangChain langchain-typesafe 集成包开源,仅 API 封装,不含模型权重
- 复刻 / 实验项目(社区)
- vinnylarouge/jev-like:社区复现类 Jev 并行决策模型,开源仓库,可自行训练类似 RLCD 思路的非自回归决策模型,不是官方原版 Jev
- pi-jev-auto-mode:MIT 协议,开源 Agent 网关 demo,将 Jev 作为安全校验层,拦截、校验 Shell 命令调用,属于 Jev 应用层开源项目,非模型本身DEV Commun…
NanoJev
NanoJev 不是套一层 API,是 0.6B 并行决策模型 + 数据 + 训练管线
把「状态+问题 → 完整概率分布、零 token 解码」直接摊开:
- 🔹底座只用 Qwen3-0.6B,一次前向就能并行批处理多个状态、多个问题
- 🔹动态候选 2–255 个,支持 Choice / Boolean / Score 三类结构化决策
- 🔹50×50 迷宫:244 步、36 次碰撞到达终点;贪吃蛇 12×12 吃到 27 个食物还活着
- 🔹模型和数据全开源,训练、评测、持久化推理服务、三栏对照演示一条龙
- 🔹代码规划 + 模型局部判断,不是纯聊天模型硬解游戏
基于Qwen3-0.6B开发。只要2GB RAM就能运行。手机上也能本地使用。
支持Choice / Boolean / Score三种结构化的决策类型,而且模型和训练数据等全都开源了呢。
闭源 200 倍更快,开源已经把玩具级 System One 端到端跑通
单卡 3090 也能跑,直接读 token 概率,不用等模型说完一整句话再解析成 JSON。 🔗 openjev.com📦 github.com/TheoLeeCJ/SemIf
Kev
Kev-0.5B: A tiny open source Jev-like decision model with a TypeSafe-compatible API based on Qwen2.5-0.5B that you can train and run on a MacBook Pro. Model card and weights are available on GitHub:github.com/jaredpalmer/kev
decider-2b
decider-2b 开源项目通过2B参数直接给出判断概率,适用于工单分类、流程判断等场景,避免大模型冗余生成。未来可基于中文场景开发决策模型,拆分小判断任务,提升系统效率。
论文
Jev 主题的论文
| 编号 | 论文标题 | 日期 | 一句话简介 | arXiv编号 | 机构 | 作者 |
|---|---|---|---|---|---|---|
| 1 | Replacing LLMs with Jev Decision Models | 09.19 | 边缘编排里换掉大模型,延迟和费用都降 | 2609.22753 | 悉尼科技大学 | Delong Li、Xu Wang、Haochen Gong、Rui Lang、Guangsheng Yu |
| 2 | Fast Intent-Driven Service Orchestration | 09.19 | 6G网络把意图翻成合约 | 2609.23136 | 悉尼科技大学 | Delong Li、Xu Wang、Haochen Gong、Rui Lang、Guangsheng Yu |
| 3 | this-that-model-1.0 | 09.20 | 开源2B平替,笔记本显卡就能跑 | 2609.23886 | 牛津大学、FLock.io | Zehua Cheng、Wei Dai、Jiahao Sun |
| 4 | Open-Jev on CallScreenBench | 09.21 | 反诈电话边听边判,正常来电零误报 | 2609.23959 | Scam.ai | Simiao Ren、Kidus Zewde、Xingyu Shen、Yuchen Zhou、Dennis Ng、Ankit Raj、Tommy Duong、Yuxin Zhang、Neo Tiangratanakul |
| 5 | Jev-Mem | 09.21 | Agent记忆交给快决策,建得快查得也快 | 2609.23986 | 德州大学达拉斯分校 | Dongming Jiang、Yi Li、Bingzhe Li |
| 6 | Calibrated Decisions at Scale | 09.21 | 德州交警事故叙述整批编码,跟大模型打平 | 2609.24052 | 德州州立大学 | Amir Rafe、Subasish Das |
| 7 | JEVQA | 09.21 | 零样本给视频质量打分,逼近国际标准 | 2609.24395 | AVEQ,维也纳 | Werner Robitza |
| 8 | Evaluating Decision Models for Text Annotation | 09.21 | 社科标注实测,准头稍逊但便宜太多 | 2609.24574 | 纽约大学阿布扎比分校 | Hazem Ibrahim、Yasir Zaki |
| 9 | Jev for Scientific Decisions | 09.21 | 科学计算里先选关系,再交给公式算 | 2609.24965 | 约翰霍普金斯大学、哥伦比亚大学 | Boyuan Deng、Shuyi Fan、Hongyang Zhang、Xinhong Xie |
| 10 | Visual Jev | 09.22 | 一张图编码一次,几十个问题一起答 | 2609.25845 | 卡内基梅隆大学、独立研究者 | Guanxu Yu、Yuhang Yao |
| 11 | REFLEX with Jev | 09.22 | Agent里加一层快决策,少喊大模型 | 2609.26532 | 南洋理工大学 | Tiantong Wu、Wei Yang Bryan Lim |
| 12 | JEV-as-a-Judge | 09.22 | 当judge用,准头咬得住,钱少花很多 | 2609.26550 | 卡内基梅隆大学 | Yubo Li、Yidi Miao、Ramayya Krishnan、Rema Padman |
| 13 | Type-Safe Is Not Error-Free | 09.22 | 只换个选项名,答案就大面积翻车 | 2609.26758 | 新加坡国立大学、复旦大学 | Yu Sun、Junhao Xu |
 支付宝打赏
 微信打赏